华为全新的 MACaQ 工具仅需 32.5 GB 的设备内存,即可在 64 分钟内完成对一个拥有 122B 参数的大模型的量化。这一进展解决了本地 AI 推理中的一个重大瓶颈:将大型模型压缩为可在消费级硬件上运行且不显著损失质量的格式时,所需的复杂时间和硬件资源。
多模态量化能力
MACaQ 被设计为一个模型无关的量化框架,这意味着它可以应用于各种类型的 AI 模型,而不是局限于单一架构。它支持通过 Diffusers 进行文本生成、图像和视频生成,以及通过 PyTorch 进行语音生成。
此横幅代表 MACaQ 框架作为模型无关量化工具的主要用途。
该工具为不同的后端提供特定的工作流。例如,它支持 llama.cpp 的 2、3 和 4 位 GGUF 格式,以及针对 vLLM 和基于 PyTorch 的语音模型的 W4A4(4 位权重和 4 位激活)格式。
效率与性能基准
MACaQ 的主要优势是速度。开发人员声称,它可以在匹配最佳 Llama-3-8B 困惑度的同时,比竞争方法减少 11 倍的量化时间。对于需要快速迭代压缩模型的研究人员和开发人员来说,这种效率至关重要。
在对 Qwen3.6-35B-A3B 模型进行测试时,MACaQ-R(一种精炼方法)相对于 FP16 实现了 0.013367 的 KL 散度,优于得分 0.015731 的 Unsloth UD-Q4_K_XL 方法。较低的 KL 散度表示对原始模型权重的重建质量更高。
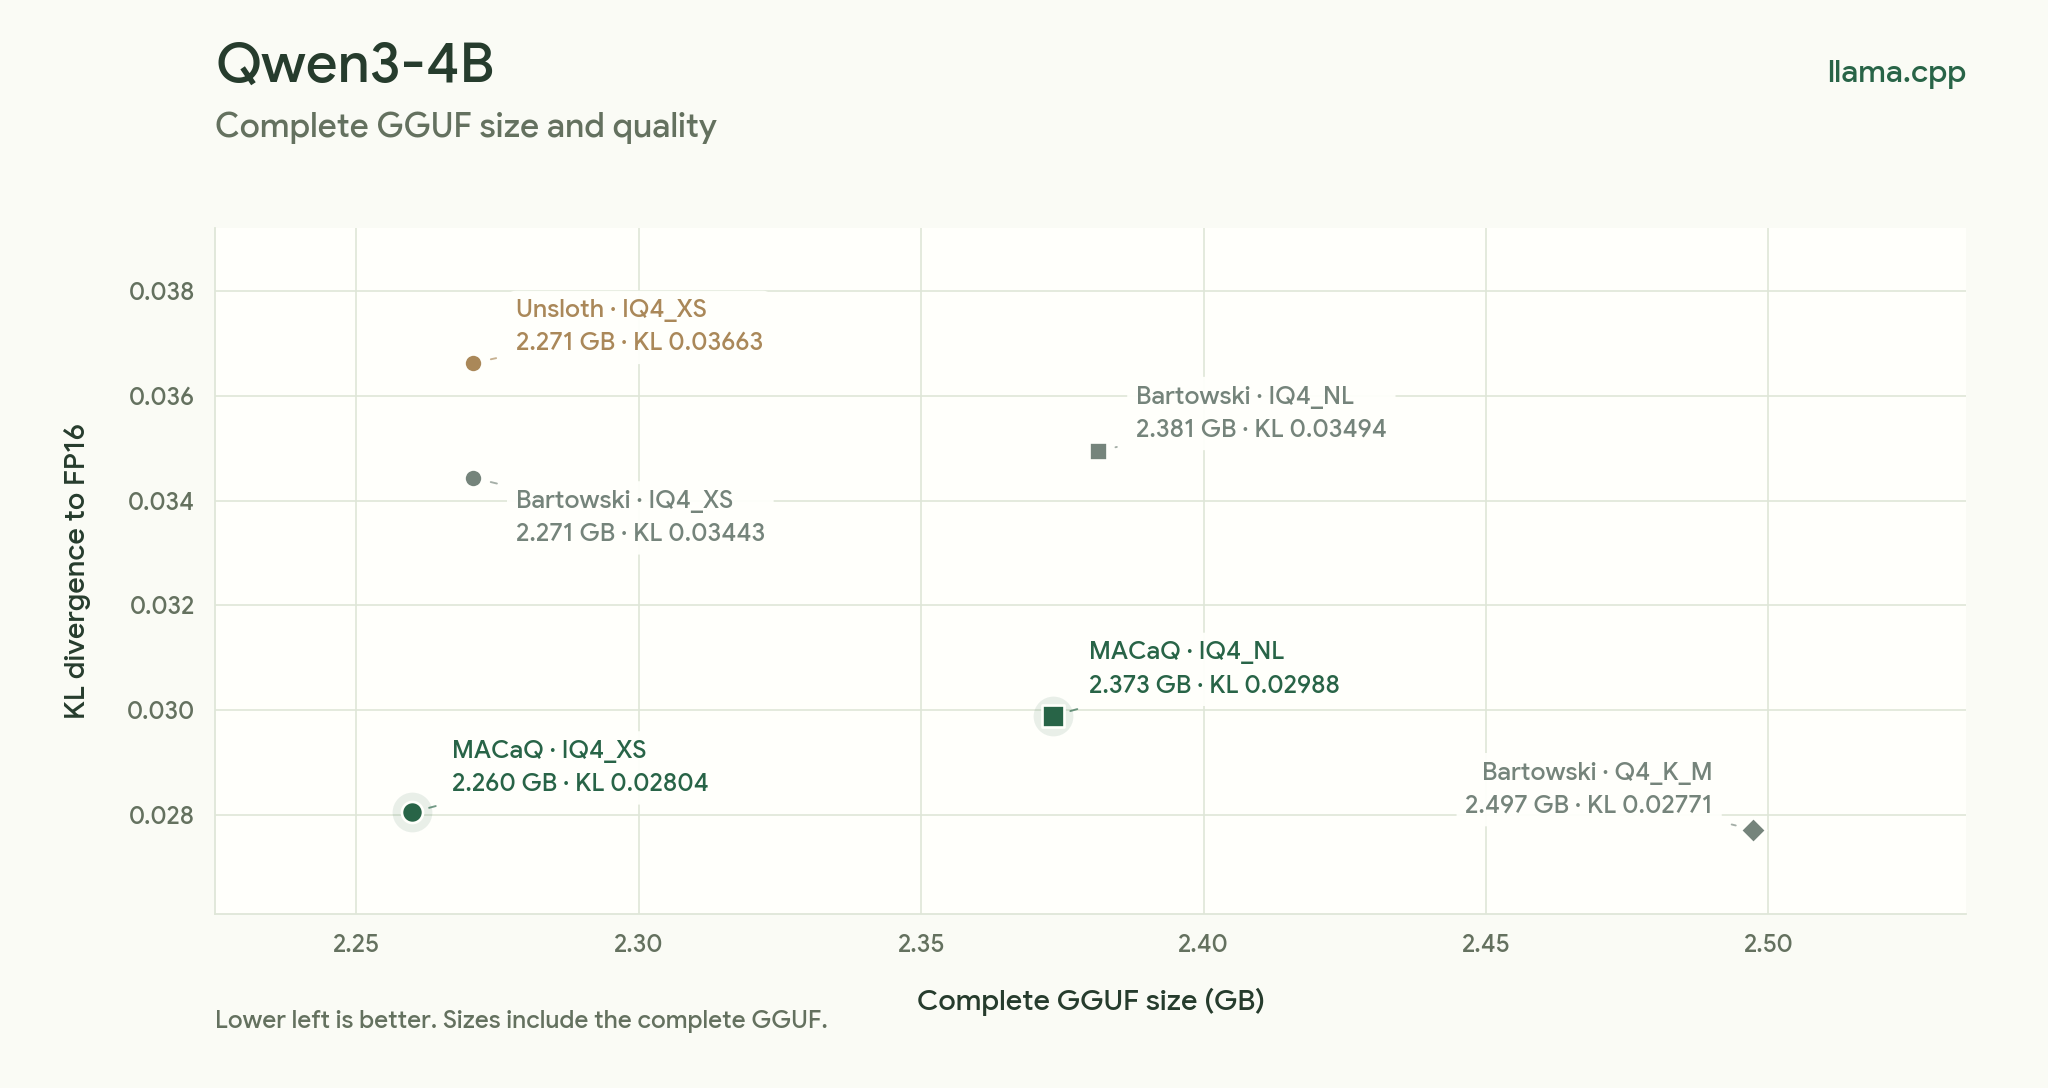
此图表提供了性能基准中提到的模型大小和重建质量(KL 散度)的视觉对比。
推理权衡与硬件集成
虽然 MACaQ 显著提高了推理速度,但在精度上存在可衡量的权衡。对于 Qwen3.8-27B 模型,从 BF16 切换到 MACaQ W4A4 精度导致困惑度从 2.8463 轻微增加到 2.8994,但这一变化被解码速度的大幅提升所抵消。
对于使用华为 Ascend 硬件的用户,该项目通过 CANN 拉取请求(pull requests)提供特定的稠密和分组矩阵乘法(matmul)内核。这确保了量化优势可以在专门的 NPU(神经网络处理器)架构上得到充分实现。
Hacker News 读者的反应
- 替代方案: 一位评论者表示,比起官方产品页面,他们更倾向于使用 GitHub,因为它可以更方便地导航并直接访问代码。 评论 ↗
- 质疑: 另一位用户对华为产品的第三方托管可靠性表示担忧,认为中国以外平台上的内容可能随时被移除。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗