运行高容量 AI 工作负载的组织可以通过从托管 API 转向自托管模型减少约 80% 的成本,这一转变正将传统的平台工程转变为专门的推理工程领域。这一转变是由对数据隐私、低延迟的需求以及开放模型日益增长的性能驱动的,例如 DeepSeek 的 R1,它在数学和代码基准测试中已达到前沿模型的水平。
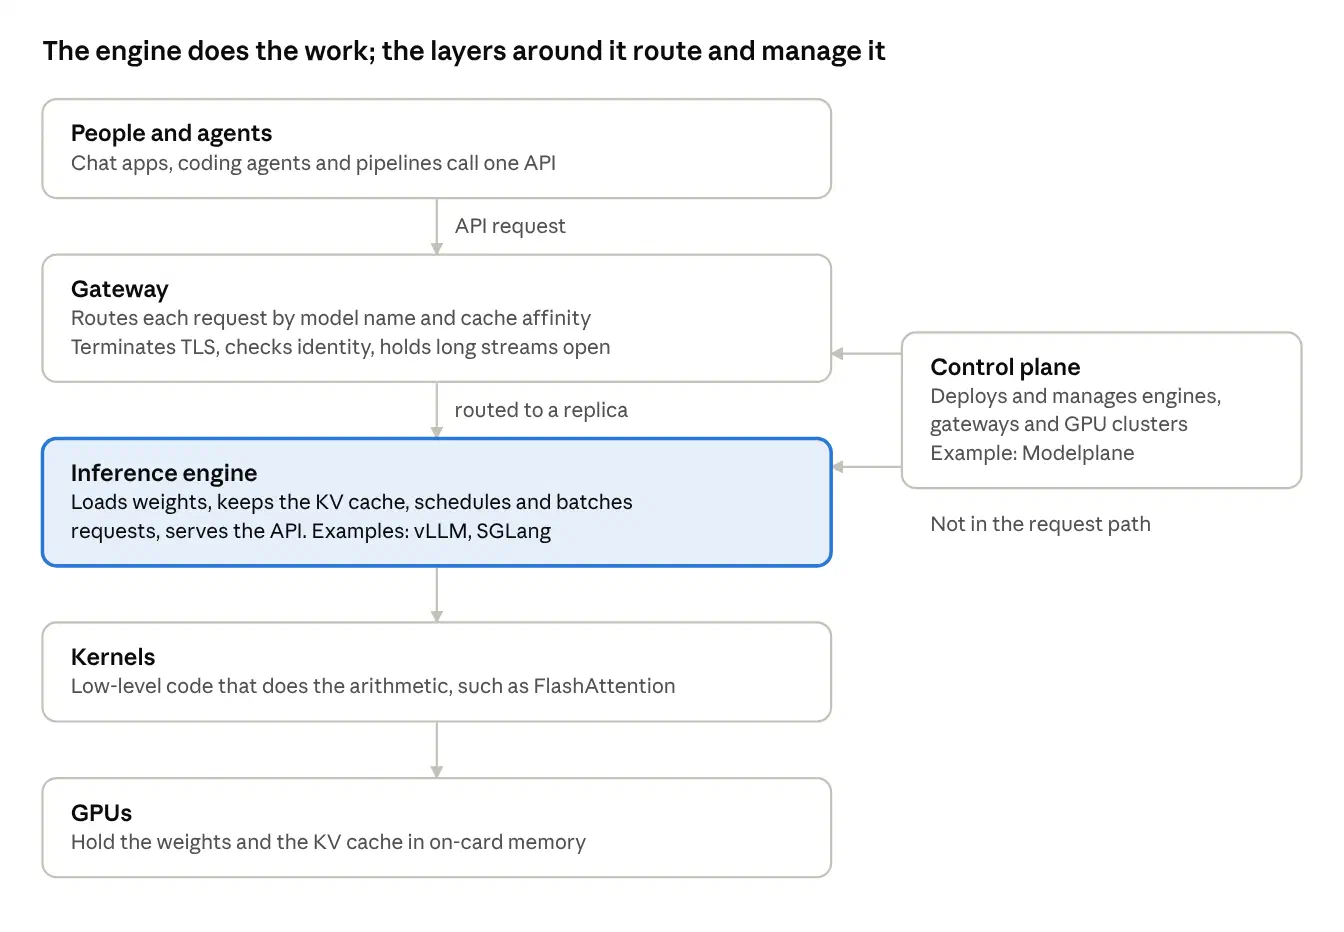
此图展示了列表中提到的推理栈的四层架构。
向自托管转变
随着企业寻求内部运行模型以保护源代码和敏感数据,平台团队正日益成为推理团队。虽然托管 API 通常足以满足早期产品开发,但随着模型账单上涨,且开放模型(目前在 Hugging Face 上已有超过两百万个)变得与封闭系统具有竞争力,自托管变得更加可行。
HN Digest 根据 docs.modelplane.ai 报告的数据绘制;数值按原文显示。
推理工程的主要目标是管理这些模型的生命周期:选择合适的硬件、优化 GPU 内存并确保高可用性。这项工作与标准的基础设施管理不同,因为 AI 能力的价格下降很大程度上归功于模型服务方式的改进,而非仅仅是 GPU 硬件的改进。
此视觉效果代表了推理栈中的控制平面层,负责管理模型生命周期和硬件优化。
“固定水平的 AI 能力价格每年下降约 10 倍,而其中大部分源于模型如何被服务,而非更好的 GPU。”
— modelplane/docs/content/guides/inference-guide.md at release-0.7 · modelplaneai/modelplane
推理引擎的机制
推理引擎(如 vLLM 或 SGLang)的功能类似于连接了 GPU 的状态数据库服务器。它在启动时将模型权重加载到 GPU 内存中——这一过程可能耗时数分钟——并为每一个正在进行的对话维护 KV(键值)缓存。与使用系统内存的标准数据库不同,推理引擎必须将工作集保存在昂贵且有限的 GPU 内存中。
KV 缓存是一个关键组件,它存储对话中每个 token 的注意力键和值,以避免重新计算历史记录。对于像 Llama 3 70B 这样的模型,单个 128K token 的对话可能需要约 40 GB 的缓存,这往往成为单个 GPU 能服务的并发用户数量的主要瓶颈。
性能瓶颈与权衡
模型请求在两个具有相反瓶颈的阶段运行: “预填充”阶段并行读取整个输入,受限于计算能力;而“解码”阶段逐个生成 token,受限于内存带宽。由于这些阶段受不同的硬件限制约束,旨在提高首个 token 速度(TTFT)的优化可能对后续 token 的速度(每秒 token 数)几乎没有影响。
工程师必须在延迟和吞吐量之间平衡权衡。将更多请求合并批处理会增加每秒服务的总 token 数(吞吐量),但会降低单个用户的响应时间(延迟)。这反映了数据库调优中交易处理与分析查询之间的经典权衡。
Hacker News 读者的反应
- 亲身经验: 一位评论者分享了他们使用智能体手动构建集群服务栈的经验,指出他们能够处理内核缓存重用和引擎错误修复等复杂任务。 评论 ↗
- 质疑: 另一位读者表示担忧,认为该指南可能缺乏平台工程师所需的必要基础知识,并建议对 Transformer 架构和 KV 缓存内部机制的深入理解是该职位的核心要求。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗