IBM 宣布了 Nighthawk r3,这是一款旨在 520 个可编程量子比特上准确执行 10,000 次量子操作的下一代量子处理器。这一进展旨在解决更大、更复杂的问题,同时保持当前硬件的高速性能,使 IBM 距离其容错量子计算的目标更近一步。
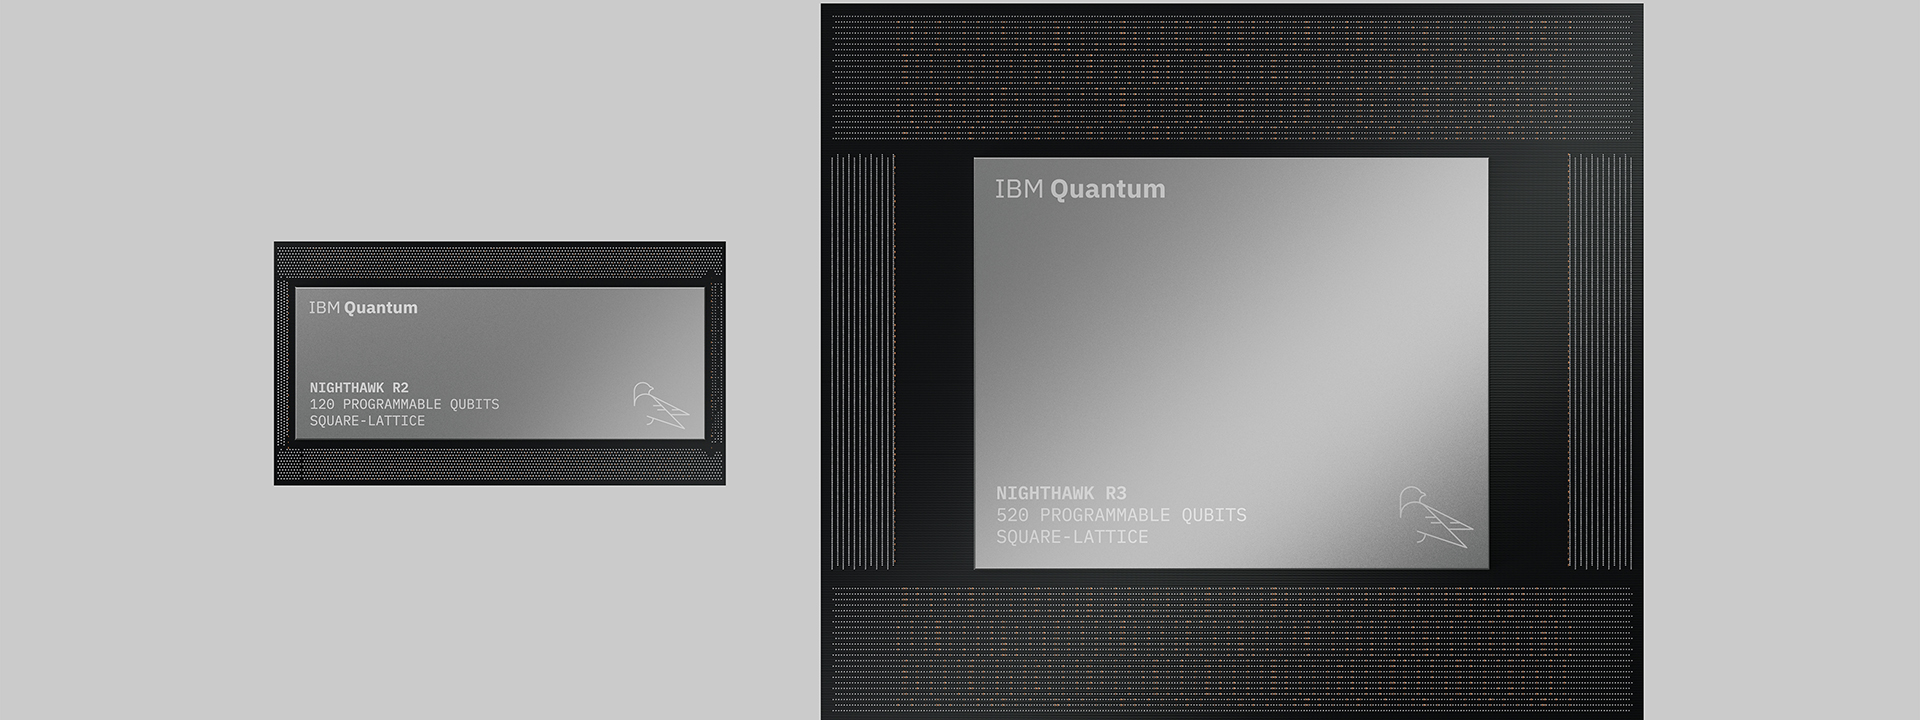
此横幅图像展示了文章开头讨论的 Nighthawk 处理器架构。
Nighthawk r2 的高速性能
当前的 Nighthawk r2 处理器作为即将推出的 r3 型号的基础,利用高速量子比特重置技术来减少电路执行之间的时间。这使得系统能够支持在 120 个量子比特上进行超过 7,500 次量子操作的准确计算。
诸如 E.ON 和 Algorithmiq 等合作伙伴报告称,使用 r2 取得了显著的性能提升。例如,E.ON 在用于能源网优化的量子机器学习中实现了 15 倍的加速,而 Algorithmiq 执行电路的速度比之前的 Heron 处理器快 8 倍。
“Nighthawk 已经向我们展示了现状。随着我们将此架构扩展到更大、更强大的量子计算机,随着我们与经典资源更紧密地整合并迈向容错,量子计算的能力将达到新的水平。”
— IBM Quantum Nighthawk Demonstrates New Levels of Speed and Quality, with Plans to Scale Beyond 1,000 Qubits in 2027
模块化架构与 l-couplers
为了突破单芯片的限制,Nighthawk r3 引入了 10 个被称为 l-couplers 的芯片到芯片互连。这些组件旨在将多个处理器连接成一个更大的单一系统,同时保持 r2 架构的方格点连接和快速操作。
IBM 已经通过使用四个 l-couplers 连接 Nighthawk r1 处理器证明了这种模块化的可行性。该测试实现了 99.3% 的量子状态传输保真度,更接近可靠大规模计算所需的 99.9% 目标。
集成量子与经典计算
IBM 正朝着一个统一的环境迈进,其中量子工作流直接与经典高性能计算 (HPC) 集成。这种集成对于处理工业相关应用所需的量子纠错和噪声学习层至关重要。
IBM Quantum Platform 现在允许用户将量子工作流连接到从个人笔记本电脑到超级计算机的各种资源。在其中一个案例中,Cleveland Clinic 和 RIKEN 使用这种自动化处理了 6.08 亿个样本用于生物建模,完成任务的速度比没有自动化工作流时快 33 倍。
扩展挑战与路线图
虽然 Nighthawk r3 为更大系统提供了路径,但向容错的转变仍是一个长期目标。当前的架构侧重于提高速度和质量,使那些可能需要数百万或数十亿个样本的高要求工作负载在合理的时间范围内变得可行。
2027 年的一个关键技术里程碑涉及将两个 Nighthawk r3 处理器连接成一个拥有超过 1,000 个量子比特的单一系统。这种模块化方法旨在解决日益复杂的问题,这些问题对于经典计算机模拟来说具有显著挑战。
此截图捕捉了主要来源对 Nighthawk r3 技术规格的展示。
Hacker News 读者的反应
- 技术补充: 一位曾与稀释制冷机合作的评论者对数据中心规模运行此类系统所需的高能耗和氦气稀缺表示担忧。 评论 ↗
- 质疑: 几位评论者对这些机器的实际用途表示怀疑,其中一人质疑该处理器是否能取得超出经典计算机能力的成果,另一个人则预测由于未实现的商业预期将出现“量子寒冬”。 评论 ↗
- 技术补充: 一位评论者澄清,在这种情况下“可编程量子比特”可能指的是可以施加逻辑门的物理量子比特,而不是纠错后的逻辑量子比特,并指出不可编程的量子比特用于去除泄漏。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗