e-means 项目引入了一种现代优化规则,与最先进的 k-means 实现相比,它在 GPU 上实现了 10–45 倍的墙钟时间缩减,在 CPU 上实现了 8–15 倍的缩减。通过将传统的全批量 Lloyd 算法替换为使用指数移动平均(EMA)的小批量方法,该方法同时提高了聚类质量和训练速度。
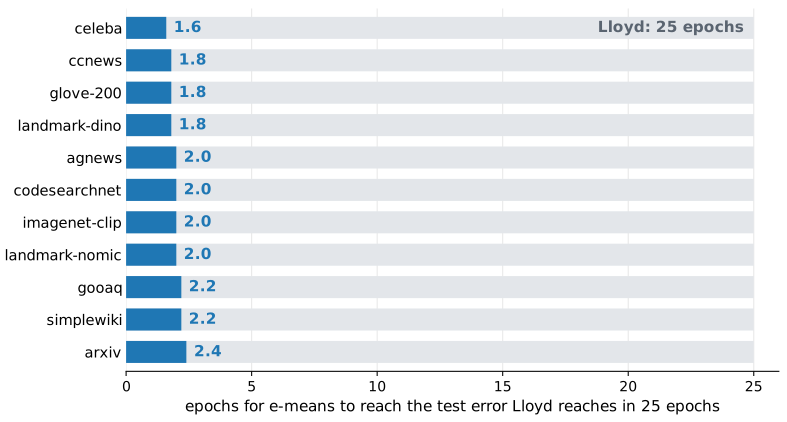
此图展示了 e-means 为达到与传统 Lloyd 算法相同的测试损失所需的 epoch 的显著减少。
从全批量到指数移动平均
传统的 k-means 通常依赖于 Lloyd 算法,该算法要求在每次迭代中对整个数据集进行完整遍历以更新质心。虽然准确,但这种方法对于海量数据集来说速度较慢,并且由于其损失总是单调递减,很容易陷入局部最小值。
e-means 用使用指数移动平均(EMA)的小批量更新规则取代了这一过程。它不是从头重新计算统计数据,而是以 alpha 的速率更新每个簇的点数总和和计数,允许质心追踪最近的分配而非整个历史记录。这种方法比梯度下降更稳定,因为 EMA 更新保证了质心始终保持在分配点的凸包内。
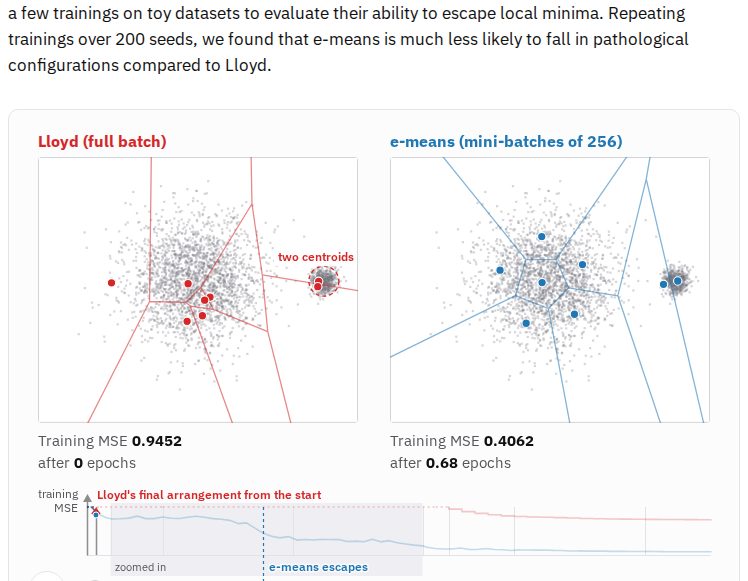
该图演示了指数移动平均(EMA)更新规则如何提供一种稳定且有效的替代传统方法的方法。
“e-means 同时实现了更好的速度和更低的损失。”
— e-means: 10x faster k-means at equal loss - Blog
自动缩放定律与鲁棒性
小批量 k-means 的一个重大障碍是需要调整批量大小和步长等超参数。e-means 通过使用缩放定律,根据问题的特征(点数、簇数和目标 epoch)自动推导出这些值,从而解决了这一问题。这确保了算法在无需人工干预的情况下也能达到最佳性能。
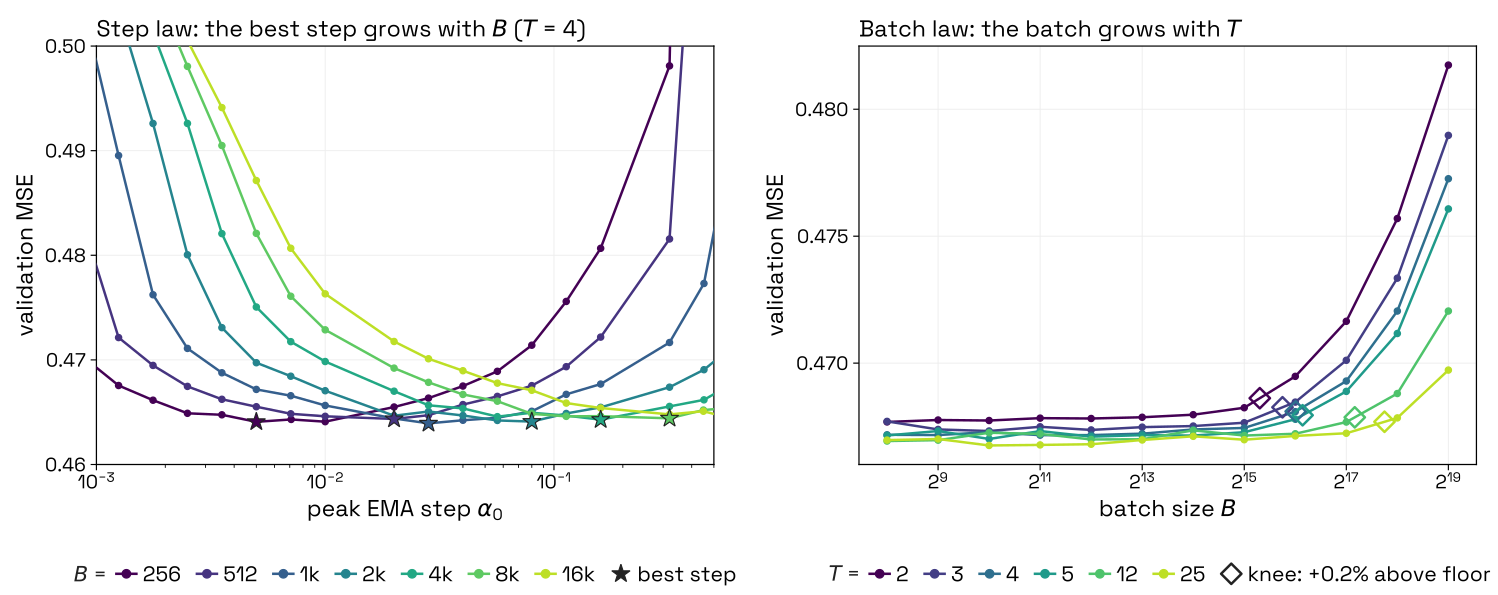
该项目利用这些缩放定律来消除小批量 k-means 中手动调整超参数的需要。
该项目还通过实施“死簇复活”策略提高了聚类的可靠性。当一个簇最终没有被分配任何点时,e-means 通过分裂一个大型活跃簇来复活它,而不是简单地重新采样一个随机点。这保留了代码簿的容量,并防止有效簇数在训练过程中缩小。
性能增益与权衡
在 24 个不同数据集上的实验验证表明,e-means 始终能达到比 Lloyd 算法更低的测试损失。例如,在 VIBE 嵌入基准测试中,e-means 在 1.6 到 2.4 个 epoch 内达到了目标误差,相比标准实现所需的 25 个 epoch 实现了巨大的缩减。
虽然算法上的变化为这些增益奠定了基础,但该项目还利用了专门的内核来确保这些改进能体现为墙钟时间的加速。主要的权衡是,该方法的效率依赖于这些优化内核,将所需的 epoch 减少转化为在 GPU 等硬件上的实际时间节省。
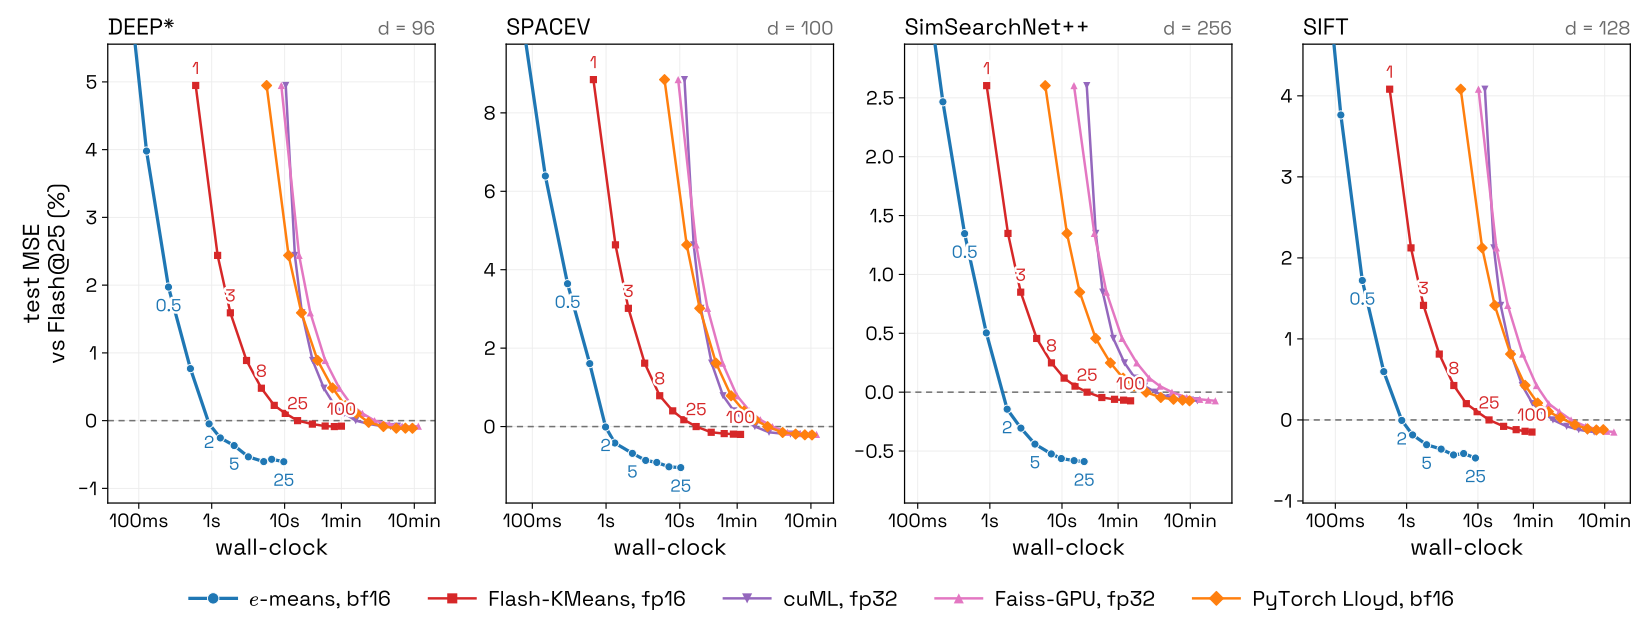
此视觉效果展示了通过将算法改进与专门的 GPU 内核相结合所实现的实际墙钟加速。
由 HN Digest 根据 e-means.github.io 报告的数据绘制;数值与源文件一致。