与 AI Agent 合作的专业人士面临的主要挑战是,在每个新会话中重新解释上下文、过去的决策以及特定客户的规则所带来的巨大时间成本。为了解决这个问题,用户正在开发自定义架构,将 Agent 的记忆视为持久的、结构化的资产,而非瞬时的对话。
上下文漂移问题
Hacker News 上的原贴描述了一个工作流,其中主要的成本涉及在多个客户之间向 AI Agent 重新解释上下文和过去的决策。他们正在探索是否要构建一个工具来解决这个问题,特别是寻求处理来自聊天、电子邮件和工单等各种来源的上下文的方法。
Hacker News 上的评论者指出,许多人已经构建了类似的工具来解决这些问题。目标是确保 Agent 的“记忆”在会话之间持久存在,这样用户就不必重复之前工作中已经确立的指令。
“对我来说,主要的成本是重新解释我们已经执行过的上下文、过去决策和客户规则。”
— Ask HN: How do you manage your AI agents' context across clients and projects?
持久化存储与共享记忆
几位评论者建议将上下文移入结构化文件或数据库。一位用户提议使用 Open Knowledge Format (OKF) 来记录每笔交易,允许任何 AI 模型读取历史记录。另一种方法涉及使用本地 SQLite 数据库来存储元数据,并使用一个在每个会话结束时更新的“running topic.md”文件,为特定主题构建持久的上下文。
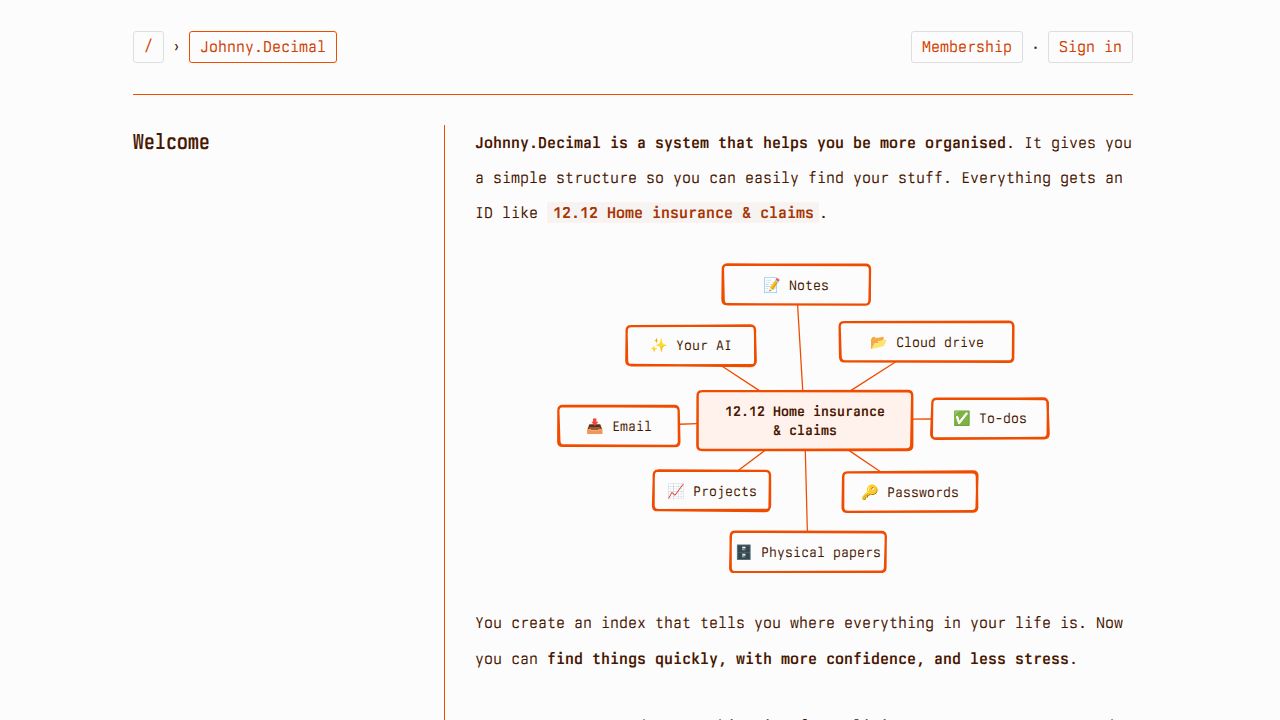
其他方法包括使用版本控制的文件,例如被 git 忽略的 Architecture Decision Record (ADR) 目录或状态文档来恢复工作。一些用户利用“Johnny.Decimal”系统,其中业务的每个部分都有一个明确的 ID,链接到 Markdown 笔记和磁盘上的文件夹,允许 Agent 通过 CLI 访问人类可读的“共享记忆”。
隔离与多客户架构
专业人士的一个关键担忧是防止“上下文污染”,即一个客户的数据泄露到另一个客户。一位评论者描述了一种“层蛋糕”架构,其中上下文被组织成根、Agent、客户和项目层。Agent 加载并拼接来自这些特定子树的指令,确保为“客户 A”工作的 Agent 无法访问“客户 B”的子树。
其他用户通过让 Agent 指向特定的“示例”项目来学习风格,或使用特定项目的 issue tracker 来管理隔离。一些人使用“守门人”脚本,在允许 Agent 开始新一轮工作之前,验证项目维基是否已更新了新发现。
权衡与技术限制
虽然这些方法提高了一致性,但它们在成本和复杂性方面带来了权衡。例如,在项目维基上使用语义搜索以确保 Agent 永远不会忘记重要细节,在 Token 使用方面可能非常昂贵。然而,一些用户认为,为了能够完美重现项目的任何阶段,这种成本是值得的。
讨论还强调了技术摩擦,例如 Agent 循环在终端界面上的局限性。一些用户更喜欢在 Podman 容器中运行 Agent,或使用本地 Web 服务器来同时管理多个模型(如 Claude 和 Codex),同时保持在每周的使用限额内。