当前的人工智能模型在学习效率上显著低于人类,表现出大约 10,000,000 倍的样本效率差距。虽然人类拥有约 100 万亿个参数且仅从 2 亿个 token 中学习,但目前的 AI 模型(如遵循 Chinchilla 准则的模型)使用的 token 与参数比例为 20:1。为了弥补这一差距,Q 的研究人员建议模型必须扩大七个数量级,甚至可能达到千万亿参数的规模。
超越固定尺寸的缩放
标准的缩放定律(如 Chinchilla 准则)建议针对固定数据集采用固定的模型规模——具体为每个参数 20 个 token。然而,随着高质量训练数据的供应成为瓶颈,模型将越来越多地在多轮次、数据受限模式下进行训练。
新研究发现,当数据集保持固定时,计算最优的模型规模会随着计算预算的增加而继续增长。在这种模式下,研究人员发现,在 10^29 FLOPs 时,集成模型应保持每 token 超过 300 个参数,这比之前的准则有了巨大的增长。
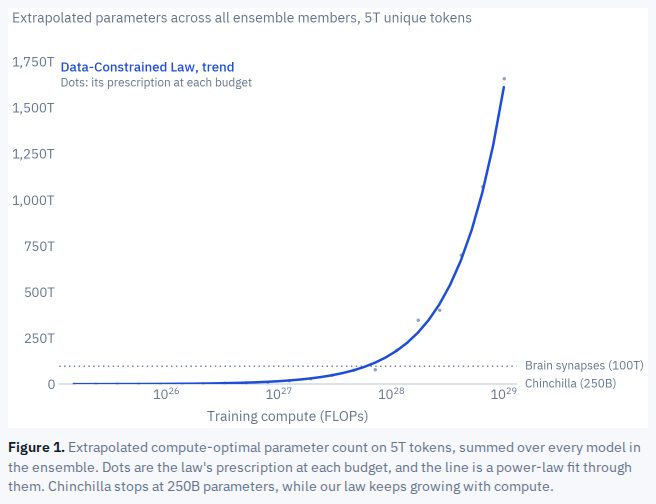
此图可视化了核心发现:在固定数据集上训练时,模型规模应显著大于之前的准则。
“AI 与人类之间的 token 与参数差距因此达到了 10,000,000 倍,缩小样本效率差距的一个重要步骤可能是填补这一差距。”
— Quadrillion-parameter transformers and how to train them – Q
超参数缩放与权重衰减
新定律的一个关键发现是超参数如何适应在多轮次训练中训练的更大模型。之前的数据受限定律将权重衰减固定,这导致随着计算量增加,预测损失也会增加。
研究人员拟合了幂律,显示最佳权重衰减随轮次和模型规模的增加而剧烈增长。他们的定律在拟合计算量的 16 倍处仍接近最优,而之前的启发式方法未能考虑到这些变量之间的相互作用。
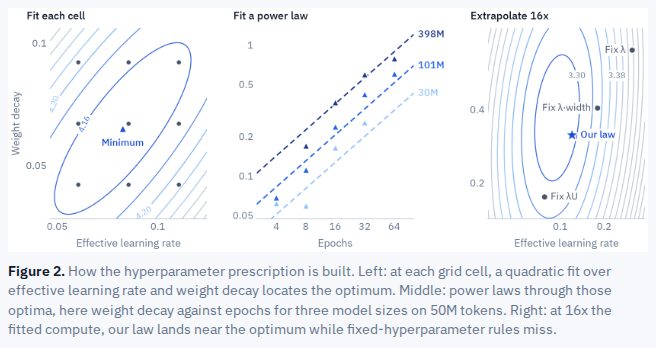
该图表解释了拟合超参数幂律的方法,这是新缩放定律的关键组成部分。
集成作为缩放维度
为了进一步提高样本效率,研究人员将集成(ensembling)作为一等缩放维度纳入其中。他们利用了“快照集成”,即保存单次训练运行中的检查点并平均其预测结果,从而在不增加额外训练计算的情况下获得性能提升。
对于相对于数据集而言非常大的计算预算,该定律建议将额外的计算分配给“深度集成(deep ensembling)”——即使用不同的种子训练独立的模型。这种方法减少了过拟合,并允许损失随着计算量的增加而继续下降,而之前的配方在这一点上最终会出现性能下降。
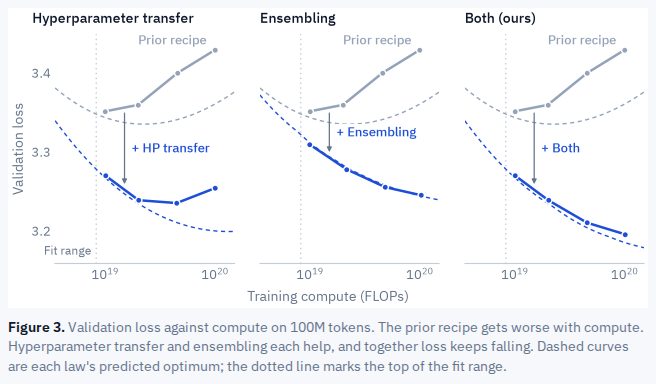
此视觉效果支持了集成作为提高样本效率的一等缩放维度的主张。
通往千万亿参数之路
这些缩放定律的最终目标是达到千万亿参数规模,以匹配类人学习效率。虽然当前研究提供了在有限数据集上达到这些规模的数学准则,但作者指出,这一转变将需要硬件和算法方面的重大进步。
目前的模型大约小了七个数量级,无法匹配人类大脑的效率。缩小这一差距代表了 Transformer 模型设计和训练方式的根本转变。
Hacker News 读者的反应
- 替代方案: 一位评论者认为,将人类学习与 Transformer 训练进行比较是错误的,因为人类拥有源于进化的强大归纳偏置,而不是从随机初始化的权重开始。 评论 ↗
- 质疑: 另一位评论者对用于人类学习的数据数字表示怀疑,认为人类通过视觉和触觉等感官接收到显著更多的数据。 评论 ↗
- 疑问: 一位评论者提出了一个问题,关于人类大脑接收到的复杂输入是否容易被 token 化。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗