Chimera 语音合成器摒弃了传统的基于采样的合成方式,转而使用物理建模来模拟人类声道的生物力学。该引擎不是播放录制的语音或歌曲片段,而是计算空气流经模拟气道(包括肺部、声带、嘴唇和鼻子)的物理特性,从而实时生成声音。
物理建模 vs. 采样合成
大多数现代语音合成器依赖于拼接预录制的音频采样或使用神经网络来预测波形。Chimera 采取了不同的方法,即对发声器官的物理属性进行建模。每一个产生的声音都是模拟气道的结果,其中包括鸣管(用于鸟类)、声带以及分支状的声道。
由 HN Digest 根据 github.com 报告的数据绘制的图表;数值按来源显示。
通过模拟这些物理结构,该软件可以连续地混合不同的体型——如男性、女性和儿童。界面实时动画化这些状态,显示气道压力、气流以及声带的特定频谱等变量。
“一款在浏览器中运行的物理建模语音合成器。每一个声音都来自模拟的气道(肺部、声带或鸣管、分支状声道、嘴唇、鼻子),而非来自采样。”
— GitHub - jamesondh/chimera-vocal-synth: the ultimate vocal synthesizer - sing, speak, beatbox, and more
技术架构与交互
核心引擎使用 Rust 构建,以确保实时确定性和性能。它被编译为 WebAssembly (Wasm) 以在浏览器的 AudioWorklet 中运行,允许复杂的物理计算以低延迟发生。相同的代码库也用于原生测试以及用于离线渲染和诊断的命令行界面 (CLI)。
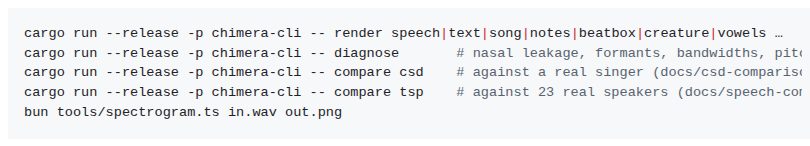
这张图片展示了技术架构部分提到的基于 Rust 的代码库。
该项目提供几种不同的音频生成模式。用户可以通过输入英文文本或 IPA 进行“Speak(说话)”,系统将其转换为手势和韵律。对于“Singing(唱歌)”,该工具提供钢琴卷帘窗,其中辅音会自动定时落在节拍之前。“Beatbox(节奏口技)”模式使用按键和步进式序列器将鼓声映射到特定的发音手势。
应用与视觉反馈
Chimera 的一个关键功能是其视觉反馈,它提供了一个实时的头部剖面图。这允许用户在操作声音时看到舌头、嘴唇和下颌的物理位置。这种发音手势的视觉映射可能对语言学习或语音矫正训练等应用非常有用,在这些应用中,理解语音的物理力学机制是有益的。
该系统还通过其“Bestiary”模式探索非人类的鸣叫声。通过调整模拟气道的参数,该软件可以复制各种动物的声音,包括鳄鱼或大象。虽然该项目提供了高度的表达控制,但源材料并未指明 WebAssembly 实现与原生 Rust 执行相比的具体延迟开销。
Hacker News 读者的反应
- 替代方案: 一位评论者分享了他们使用该工具产生特定泛音的经验,指出他们能够通过模拟解剖位置来实现某些结果。 评论 ↗
- 替代方案: 另一位用户建议该技术可以实际应用于跨性别者的语音矫正训练,或用于辅助语言学习。 评论 ↗
- 质疑: 一位评论者报告了技术困难,称引擎在移动设备上未能正常加载,且仅产生噪音。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗