研究人员发现标准多 Token 预测(MTP)训练中存在一个根本性缺陷,即梯度的“残余”部分会干扰下一 Token 和多 Token 的学习,且这一问题随着模型规模的扩大而加剧。通过引入 Soft-MTP(仅需一行代码更改),他们可以将有用的 KL 自蒸馏信号从这些噪声中分离出来,从而在各种模型规模上实现更低的困惑度和更快的投机解码。
,
标准 MTP 训练中的缺陷
多 Token 预测(MTP)是一种常用的技术,用于提高下游性能并通过投机解码实现更快的推理。然而,标准 MTP 训练存在梯度分解问题:交叉熵梯度包含一个有用的 KL 自蒸馏项和一个信噪比较低的残余项。
这种噪声残余掩盖了有用的 KL 信号,阻碍了模型有效学习的能力。随着模型规模的增加,这种干扰变得越来越严重,成为了扩展 MTP 能力的瓶颈。
— Multi-Token Prediction Done Right
> “Soft-MTP 实际上是 MTP 优化的‘免费午餐’。”
KL 梯度恢复技巧
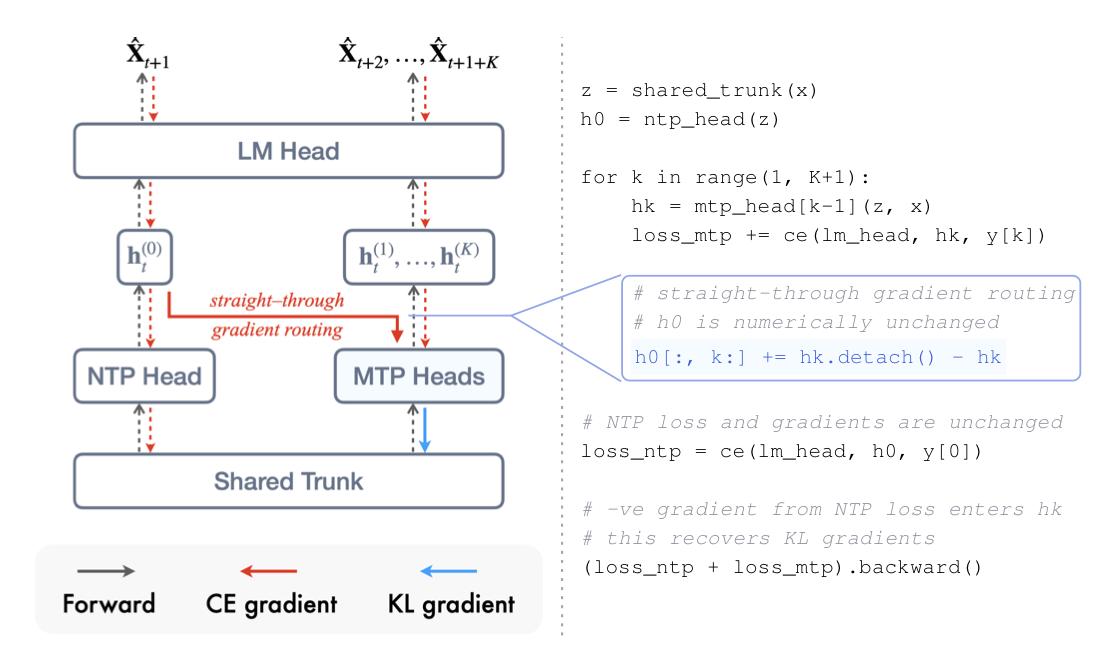
此图说明了 Soft-MTP 的核心机制,特别是它如何处理梯度路由以改进多 Token 预测训练。
Soft-MTP 通过实施“KL 梯度恢复技巧”来解决这一问题。当两个分布共享线性输出头时,可以通过直通梯度路由结合它们的交叉熵梯度,精确地恢复它们 KL 散度的梯度。
这种方法在计算上是高效的,因为它不需要通常用于直接 KL 散度最小化的庞大词表大小的 Logit 矩阵。它与标准的融合交叉熵内核兼容,使其成为优化的“免费午餐”。
该实现是单一的函数更改,支持 DeepSeek 风格和 Meta 风格的 MTP 架构。它重用现有的 NTP 和 MTP 交叉熵计算,仅反向传播所需的 KL 自蒸馏信号。
性能提升与权衡
在 1.67 亿到 12 亿参数的模型上的测试表明,Soft-MTP 一致优于标准 MTP。关键改进包括在所有测试规模上更低的下一 Token 预测(NTP)困惑度和更高的零样本准确率。
对于更大的模型(6.89 亿参数及以上),Soft-MTP 还实现了更低的 MTP 困惑度。此外,该方法在微调后展示了更优越的数学和代码推理能力。