一个由两人组成的实验室发布了一个名为 Pyramid-JiT (P-JiT) 的文本到图像模型,旨在作为更高效的生成式视频模型的概念验证。该项目的主要目标是解决视频生成中高昂的计算成本问题,这些成本通常是由注意力机制的平方复杂度驱动的。通过放弃传统的变分自编码器 (VAEs) 将图像压缩到潜空间,研究人员旨在绕过 VAE 压缩的经验上限,并在像素空间环境中更高效地进行学习。
P-JiT 架构通过使用 32x32 的 token 缩减来实现这一目标,与 FLUX-2 等标准模型相比,这代表了注意力上下文窗口的 4 倍缩减。为了加速收敛,团队在噪声计划上实施了“课程”学习:模型首先在高噪声样本上进行训练以学习基本结构,然后再扩大分布以捕捉细粒度的细节。训练方案涉及 6.6 亿个样本,利用了一个 20 亿参数的 Diffusion Transformer (DiT) 和一个冻结的 Qwen3.5-4B 文本编码器。在 H100 GPU 上进行预训练和后训练的总计算成本约为 21,038 美元。
虽然该模型在人像和风景方面展示了高质量的生成结果,但其较小的规模在复杂场景生成中引入了特定的权衡。研究人员指出,该模型在处理多人互动、多个实体(如一堆螺丝刀或一群海鸥)以及世界知识方面表现挣扎。此外,由于模型未在渲染文本上进行训练,它无法生成信息图或海报。这些局限性被认为是 2B 参数规模的预期后果,团队建议可以通过训练更大的模型并应用进一步的后训练技术,如有限差分流优化 (FDFO) 来缓解这些问题。
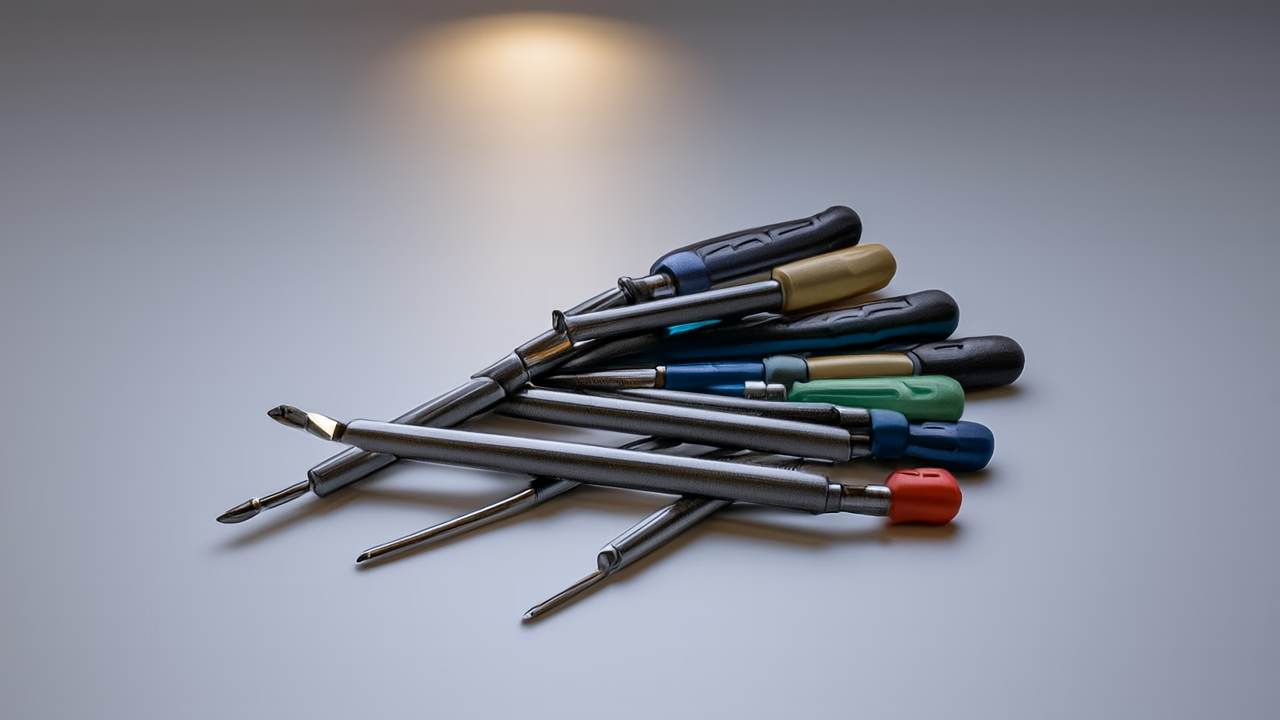
这张图片展示了模型在单个场景中生成多个不同实体时的困难。
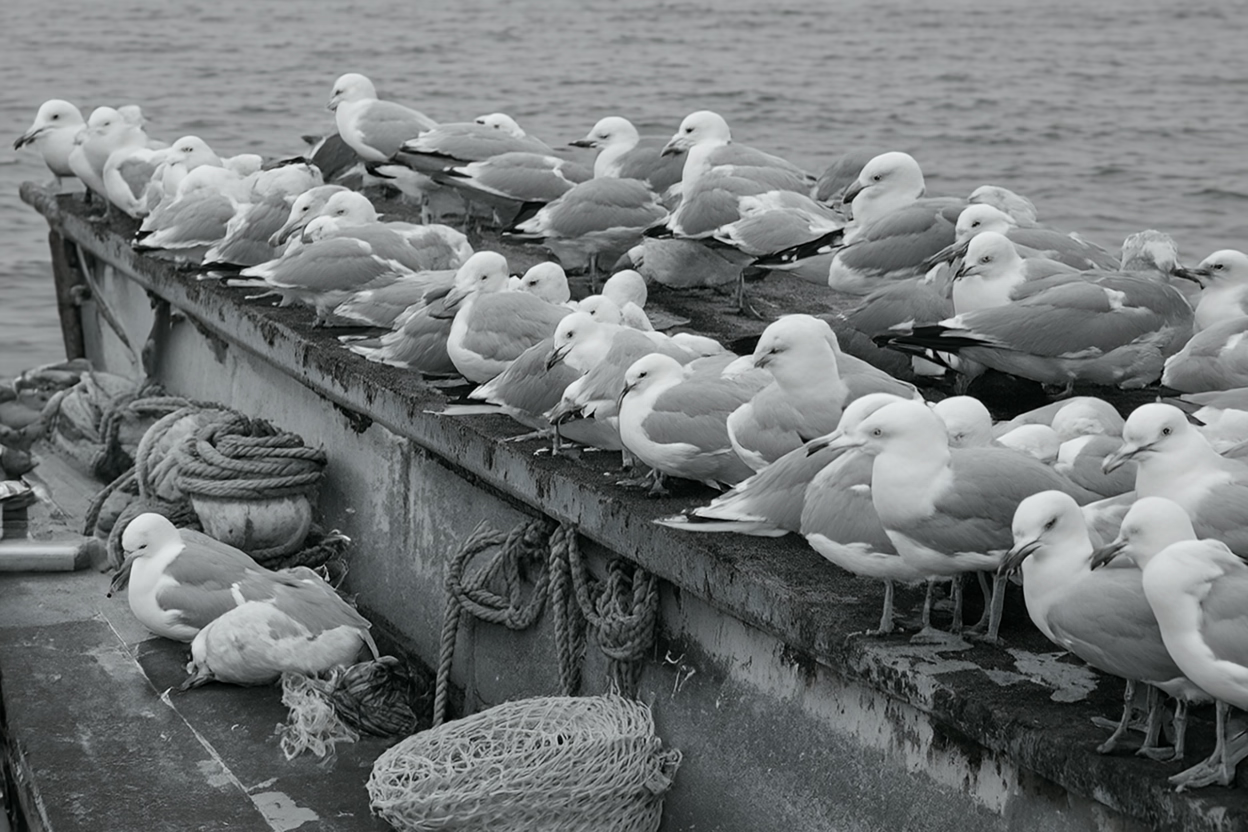
此视觉效果展示了文中提到的关于人群和多个实体的特定局限性。
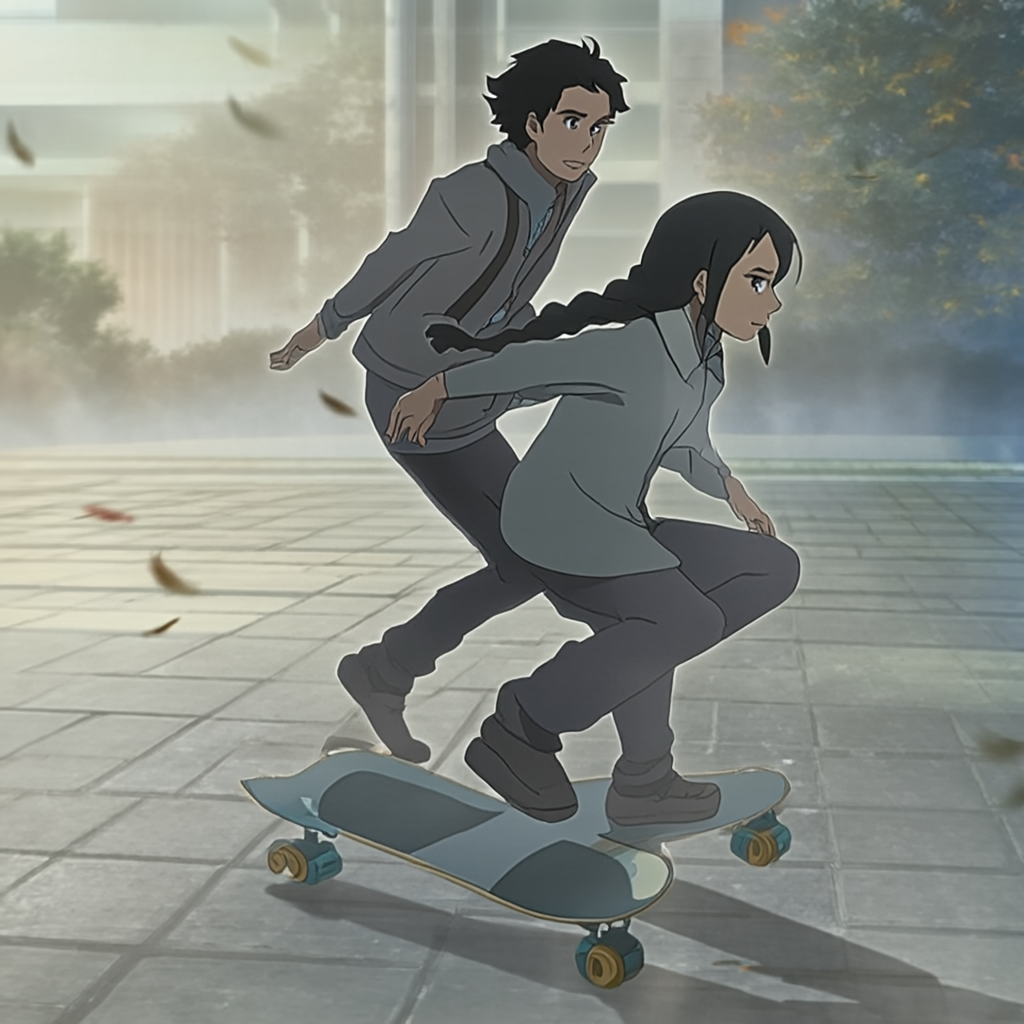
这张图片提供了模型在处理多人互动方面的具体示例。