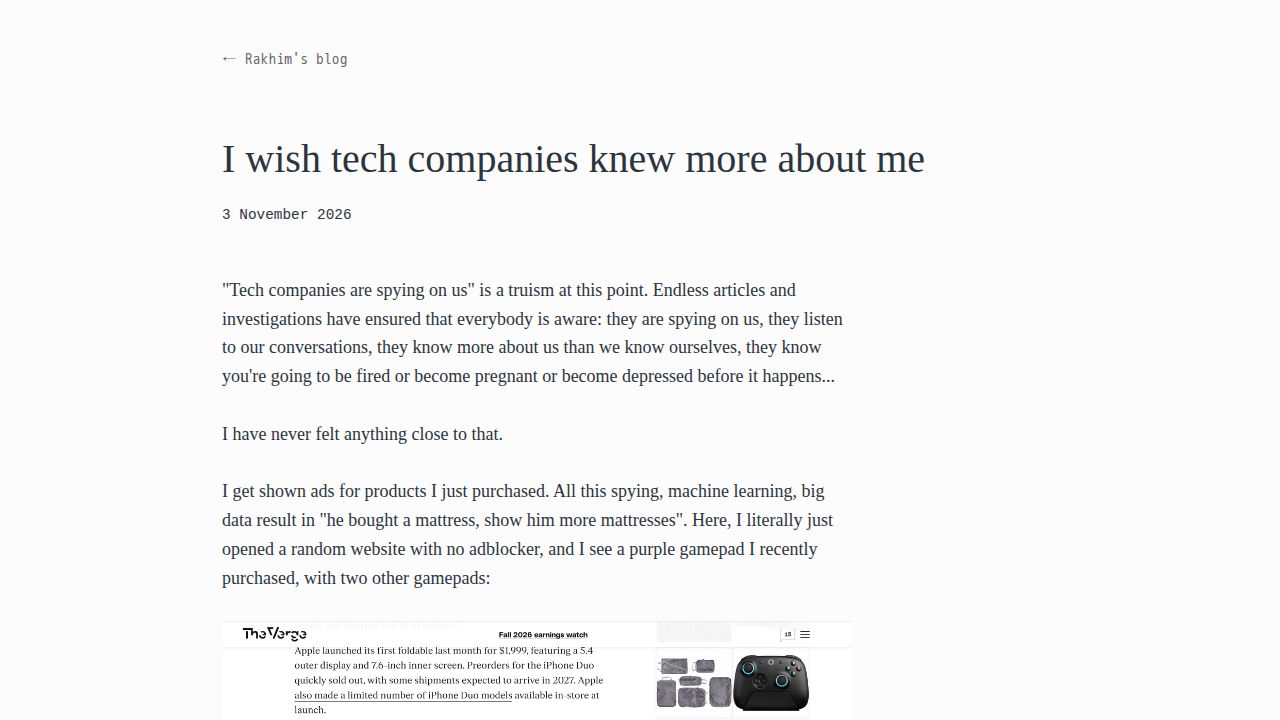
现代数字生活被一个悖论所定义:科技公司拥有海量的个人数据,但用户体验往往感觉与这些知识脱节。例如,一个用户可能被广泛追踪到足以推送他们已经购买过的产品广告,或者收到他们根本没有意图使用的服务的营销信息。这表明,虽然数据收集无处不在,但这些数据的应用往往仍处于“反应式”状态——即针对最近的操作触发通用的反应,而不是反映对用户生活和偏好的更深层次理解。
当服务优先考虑地理假设而非明确的用户设置时,也会产生技术摩擦。一个用户的系统区域、浏览器语言和账户设置可能全部设置为英语,但在旅行或从特定地区浏览时,却发现自己被重定向到芬兰语着陆页,或被强制进入德语界面。这些失败表明平台在数据优先级排序上的崩溃:系统可能默认采用广泛的基于位置的启发式算法,而不是尊重用户手动配置的特定偏好。这造成了一种令人沮丧的体验,软件似乎“意识不到”用户声明的身份,尽管它拥有访问用户账户资料的权限。
此外,机器学习算法往往难以识别细微的行为模式。一个用户可能多年来一直跳过 Techno 播放列表中的每一个人声轨道,但算法可能无法识别这一特定偏好。同样,对特定家电安装说明的一次搜索,可能会被误解为对家用电器长期感兴趣,从而导致大量无关推荐的涌入。这突显了当前预测模型的一个重大局限:它们往往难以区分一次性的实用需求和持久的消费兴趣。虽然有人认为广告的目标是强制而非实用,但“糟糕”推荐的持续存在表明,从追踪用户到真正理解其上下文,对于许多平台来说仍是一个巨大的障碍。