腾讯发布了 Hy4,这是一款旨在处理软件工程、科学研究和财务分析等复杂现实生产力任务的旗舰级大语言模型(LLM)。该模型基于 Hunyuan 架构构建,拥有约一百万 token 的上下文窗口,并在开发过程中专注于与各种工业应用的深度协同设计。虽然最初的预览版本是在 Apache 2.0 许可证下发布的,但腾讯表示 Hy4 模型的完整权重将在未来几天内向公众开放,这可能使其成为市场上的领先开放权重模型。
在 Plotly 最近进行的数据分析基准测试中,Hy4 在一项旨在测试多轮工具调用和数据推理的专门考试中获得了 42 分(98%)。这一表现使 Hy4 处于“成本-精度前沿”,这一类别模型能够提供比同类模型更低价格的高精度。具体而言,Hy4 被确定为得分在 42 分或以上的模型中最具成本效益的模型,完成整场考试的成本约为 2.11 美元。这种效率部分归功于其极高的缓存命中率;在测试期间,2270 万输入 token 中的 91% 是从缓存中提供的,与没有类似缓存优势的模型相比,这显著降低了单次查询的成本。
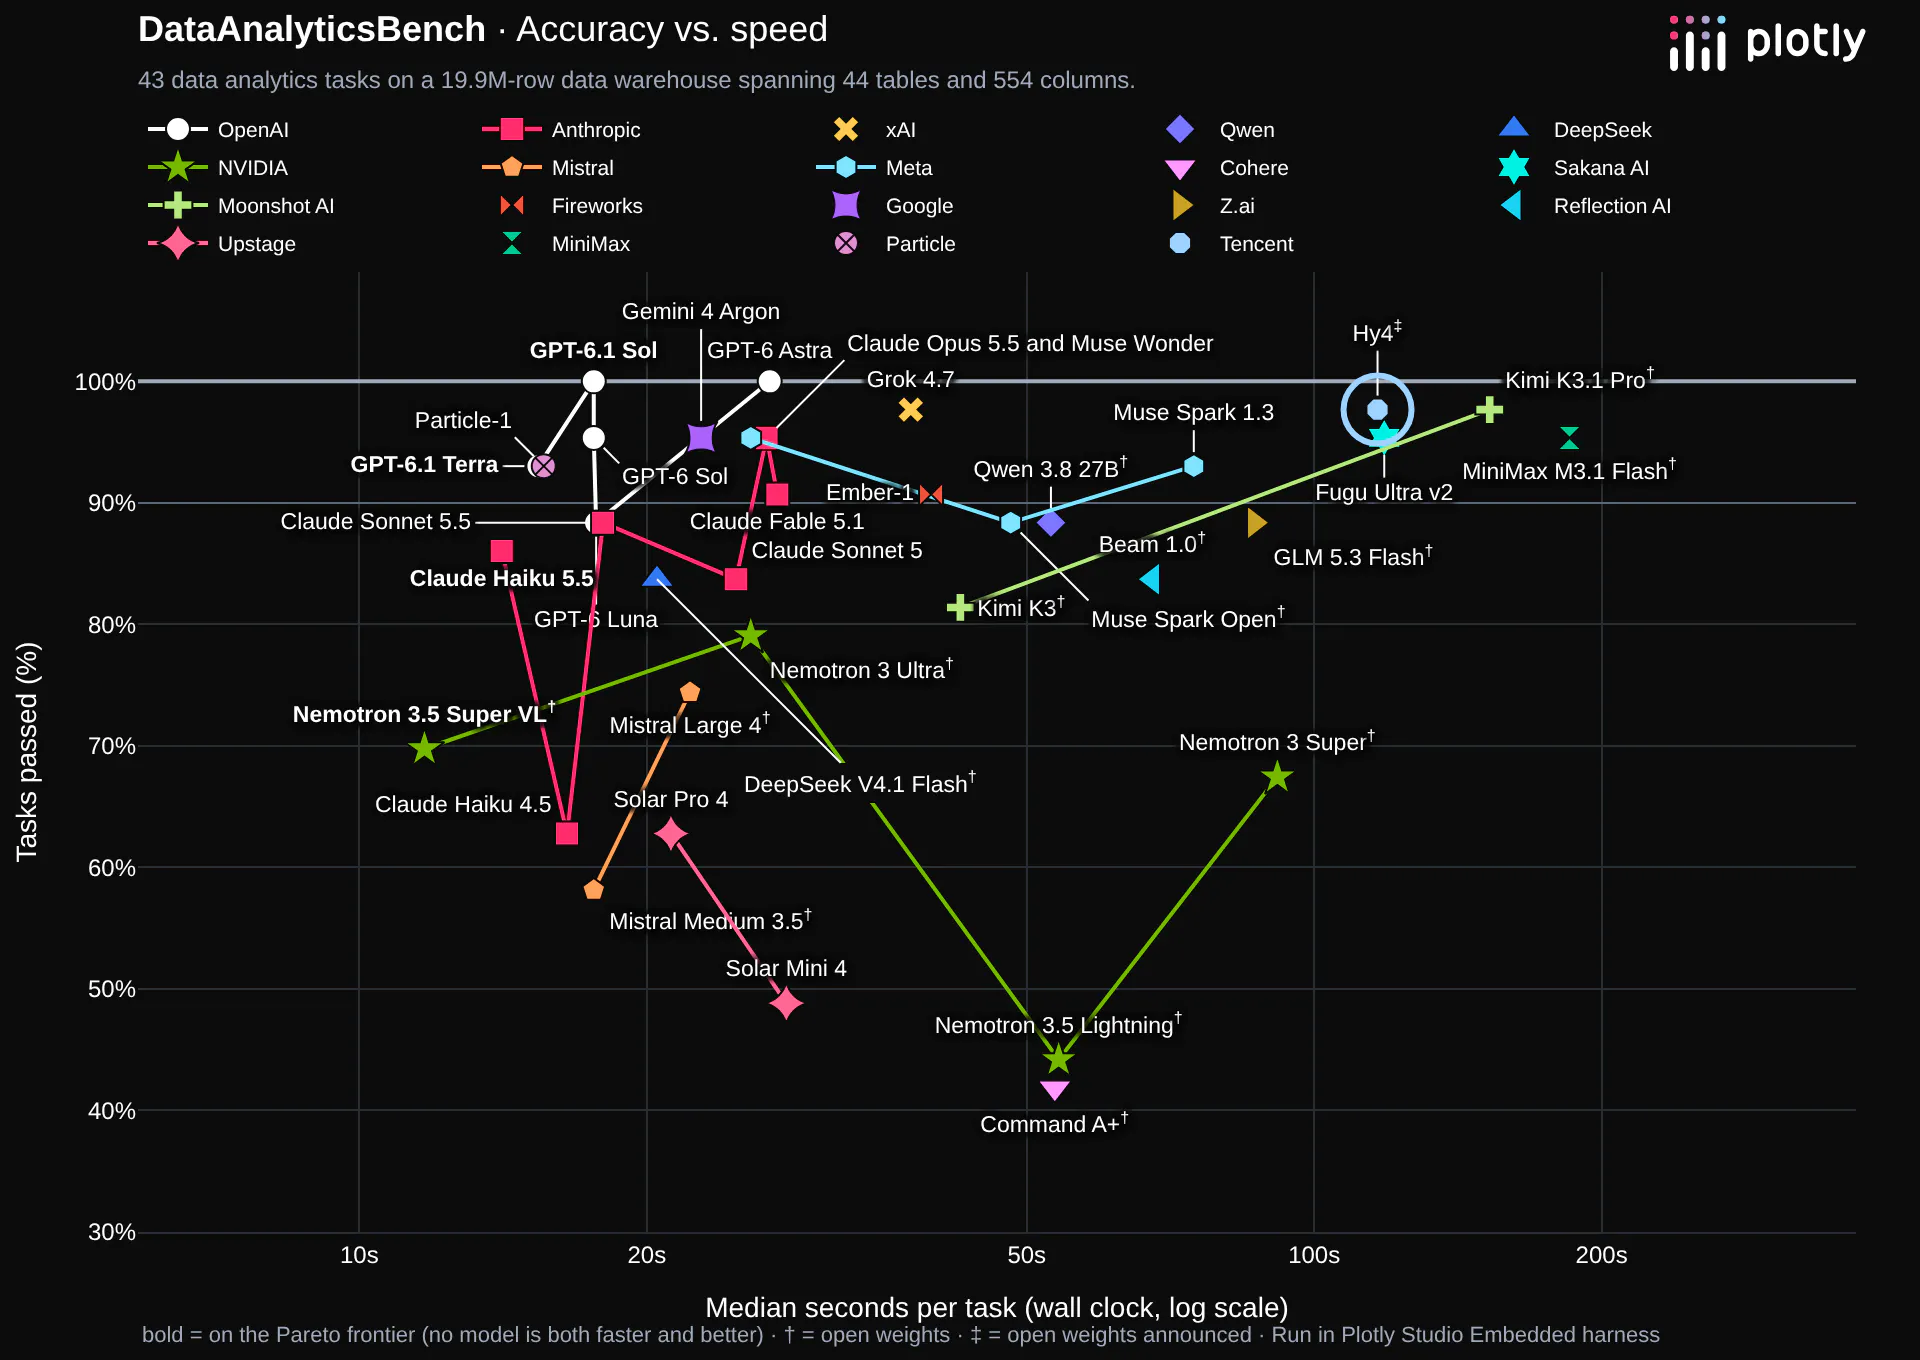
此图表说明了定义 Hy4 性能特征的高准确性与较慢处理速度之间的具体权衡。
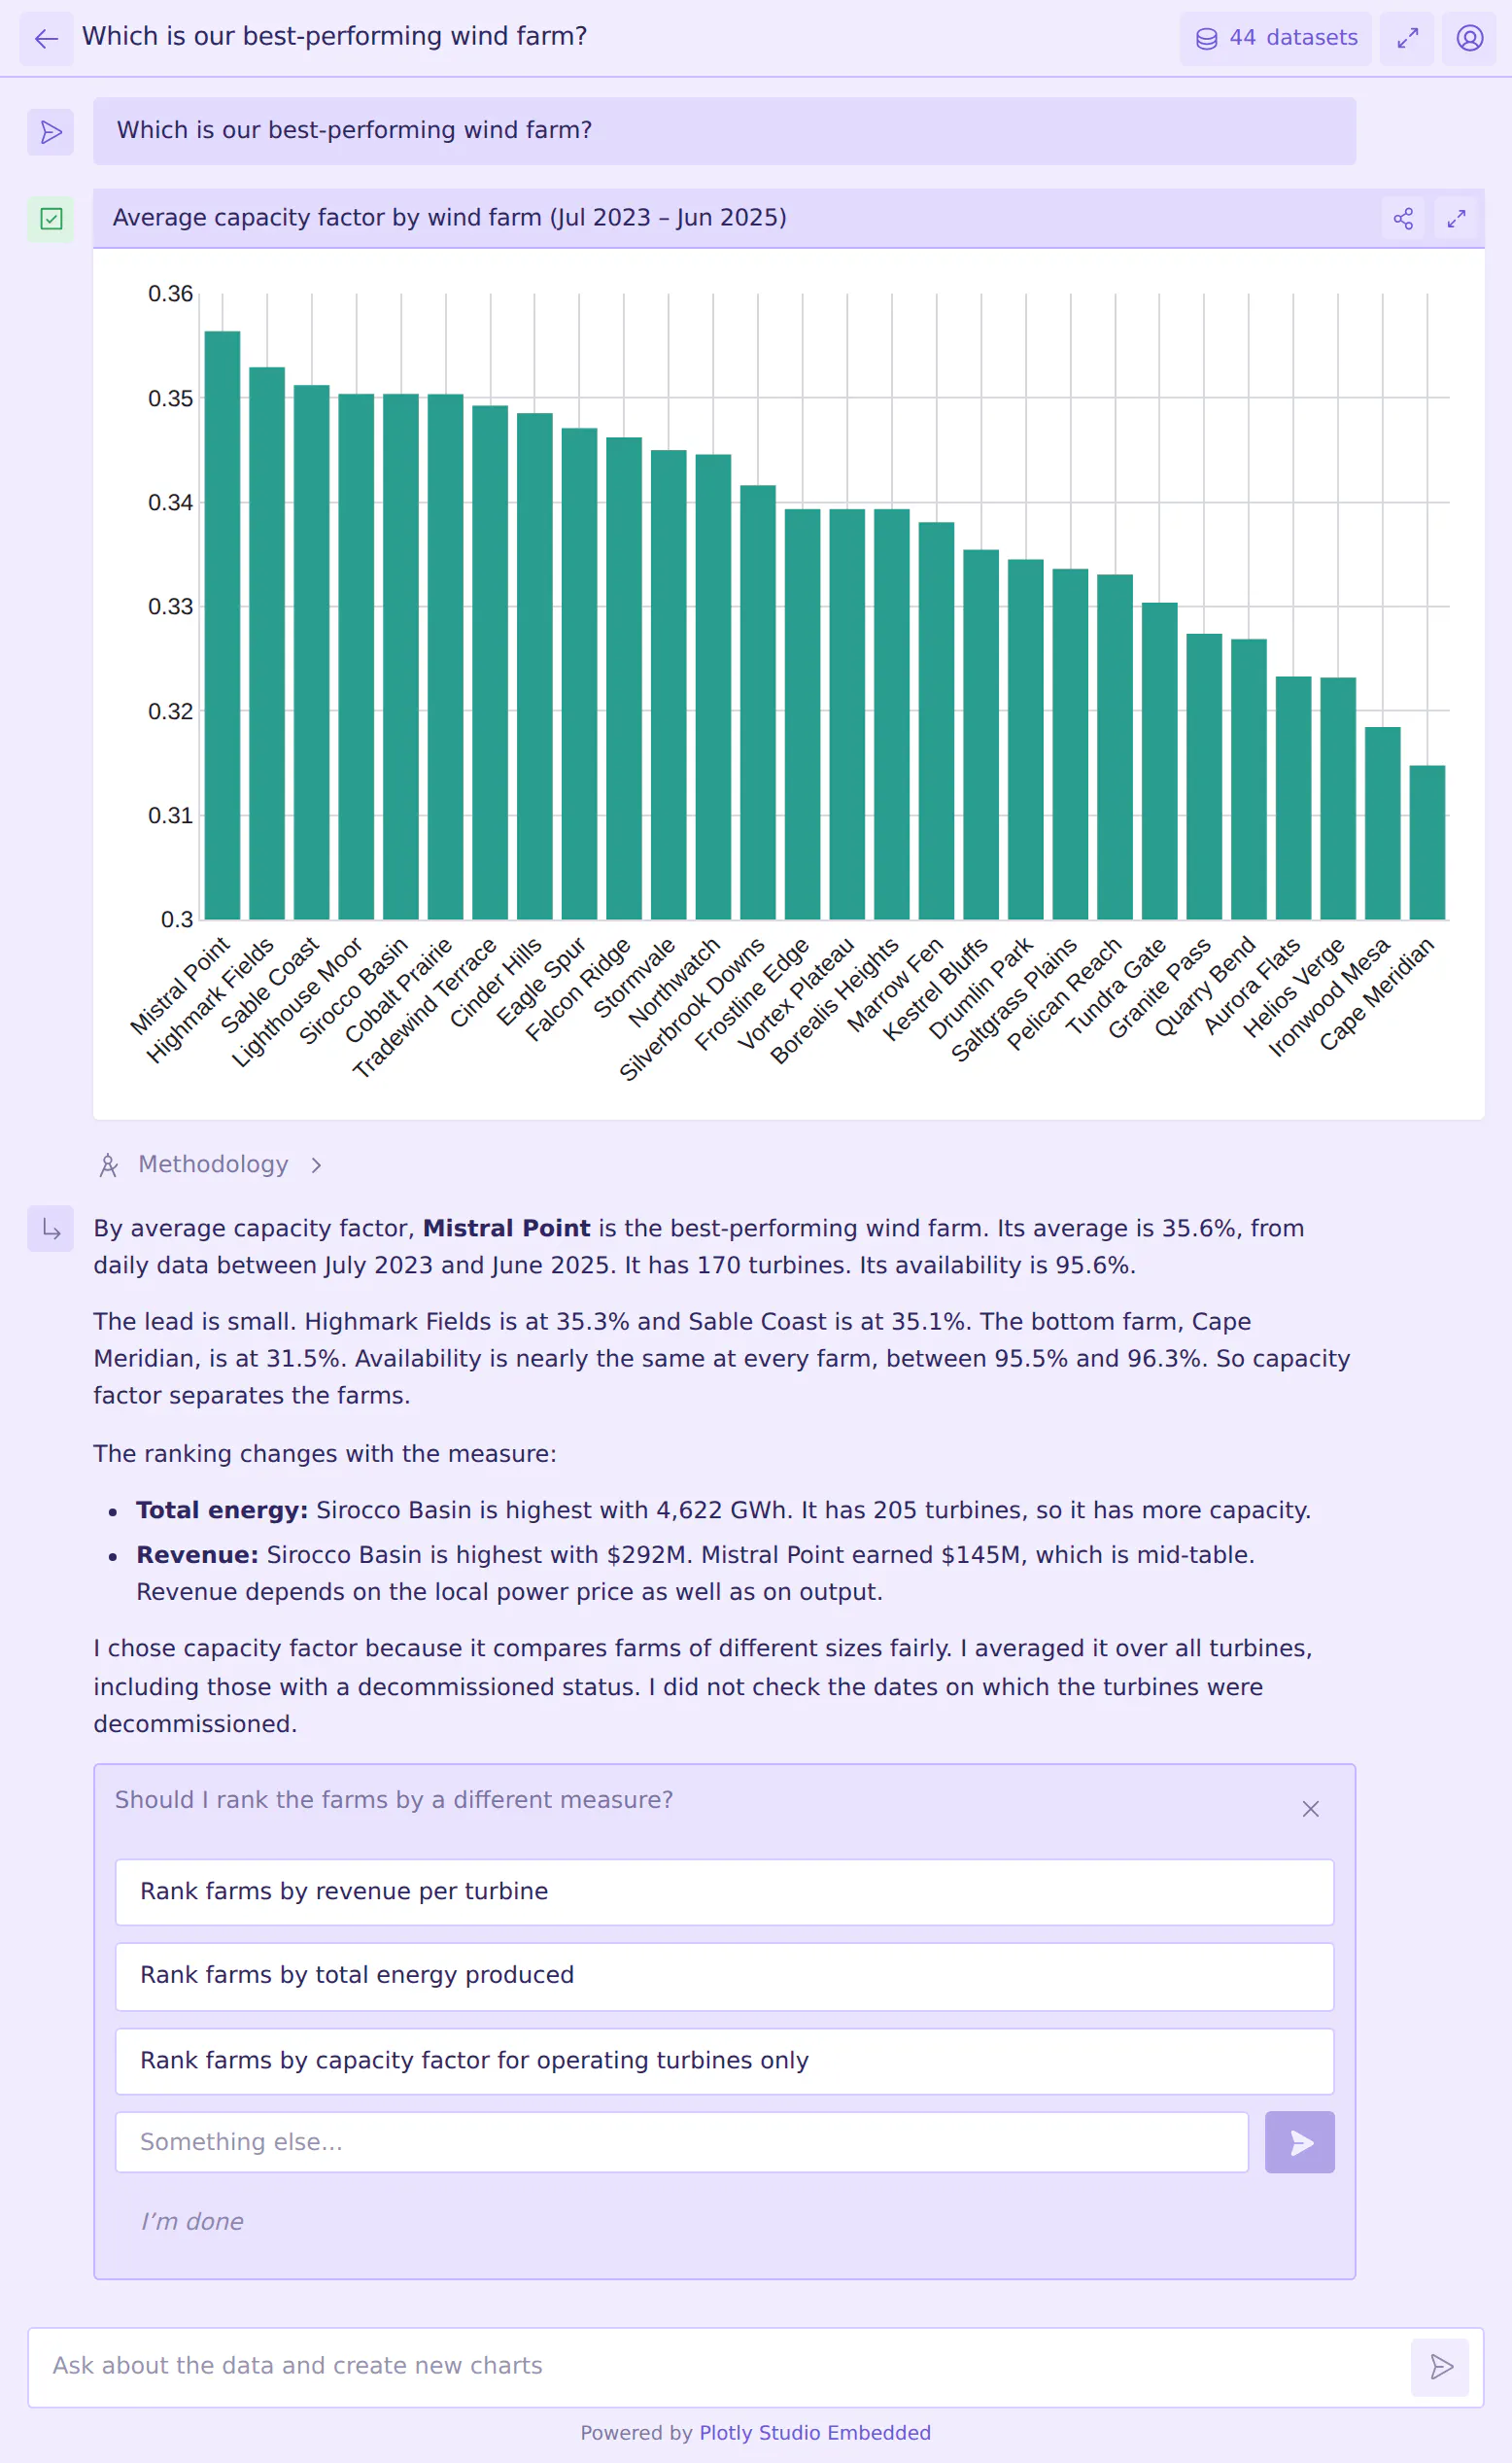
此视觉效果展示了 Hy4 在 Plotly 基准测试期间接受测试的复杂数据推理和工具调用任务类型。
然而,Hy4 的高精度伴随着明显的速度权衡。它是测试中最慢的模型之一,每题的中位处理时间为 117 秒,比 GPT-6.1 Sol 慢六倍以上。这种延迟是模型“彻底”行为的直接结果;Hy4 会进行广泛的内部交叉检查,通常每道题运行 24 到 64 次查询,以验证计数、趋势和假设。虽然这种详尽的方法使其能够胜任识别统计陷阱和审计数据质量,但它也可能导致处理时间的极端离群值,例如单次查询运行了近一个小时。对于生产环境,这些结果表明,虽然 Hy4 在复杂推理方面高度可靠,但用户可能需要实施特定的时间限制来管理其详尽的验证周期。