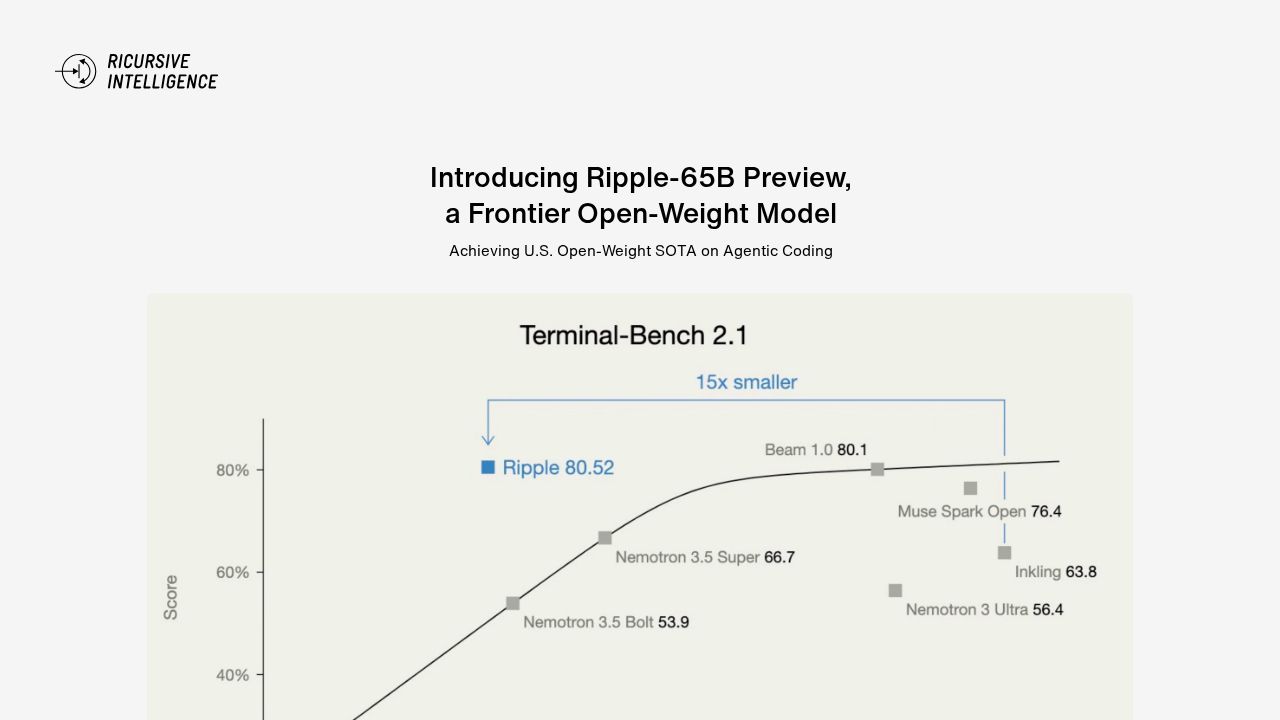
Ripple-65B 是一个在美国开发的开放权重大语言模型 (LLM),专门设计用于在“智能代理编程”方面表现出色——即 AI 作为自主代理来编写、调试和执行代码的任务。开发者将该模型定位为尖端 (SOTA) 解决方案,这一说法是指其在帕累托曲线上的位置,该曲线衡量模型性能与其物理尺寸之间的最佳平衡。通过提供开放权重版本,该项目旨在为需要本地推理或对模型架构具有特定透明度要求的开发者提供高性能的替代方案。
在原始性能方面,Ripple-65B 在 Terminal Bench 2.1 上获得了 80.5 的分数,该指标用于评估模型处理命令行和基于终端的编程任务的能力。然而,其相对于其他模型的地位是复杂的。例如,Qwen 3.8 Flash Next 模型——虽然规模更大,但利用混合专家 (MoE) 架构来保持高效——获得了更高的 84.3 分。相反,Qwen 3.8-27B 模型得分较低,为 73.0。这些数字表明,虽然 Ripple-65B 在某些参数内具有竞争力,但它面临着来自国际模型的激烈竞争,这些模型可能在速度和准确性方面提供不同的权衡。
该模型的声明在基准测试选择和对比模型方面受到了审查。一些观察人士指出,性能数据似乎通过忽略同等规模类别中更优的模型(如 Beam 1.0 或 Nemotron 3.5 Super),转而选择竞争能力较弱的基准模型,从而偏向于 Ripple-65B。此外,“美国”品牌引发了关于特定数据来源的疑问,以及该模型的性能是源于独特的国内训练集,还是仅仅是对编程领域的特定优化。由于在本次预览中,完整的训练数据和权重并未经过公开审计,其“智能代理”能力的准确程度仍是社区持续评估的一个焦点。