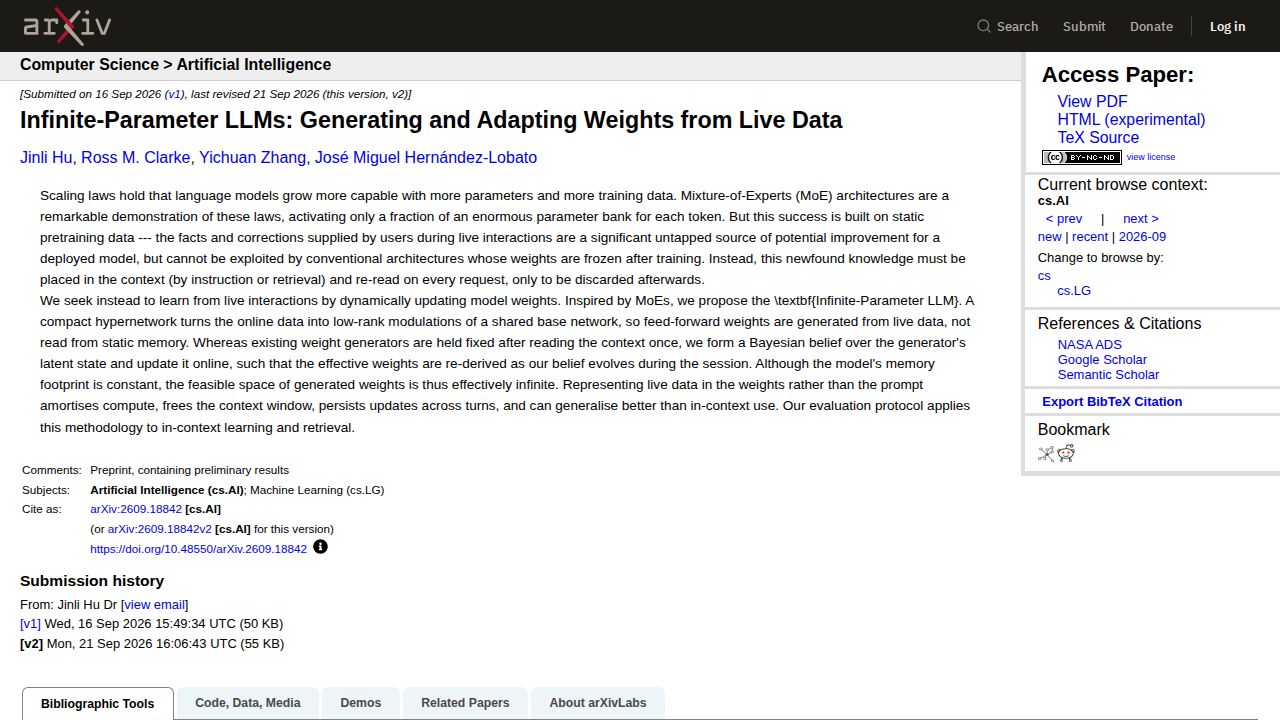
目前的各种大语言模型(LLMs)通常建立在预训练阶段后便被冻结的静态权重之上。虽然这些模型可以在对话过程中处理用户提供的新信息,但它们是通过将这些数据放入“上下文窗口”来实现的——这是一个在每次请求时被读取并在之后被丢弃的临时内存空间。这意味着,如果没有经过单独的、高成本的重新训练或微调过程,模型就无法从实时交互中真正“学习”或内化新的事实或修正。
为了解决这个问题,研究人员提出了“无限参数LLM”。该架构使用一个紧凑的超网络(hypernetwork),将实时数据转化为共享基础网络的低秩调制。模型不再从固定的内存库中读取权重,而是从实时接收到的数据中动态生成前馈权重。这种方法的一个关键区别是使用了关于生成器潜在状态的贝叶斯信念。与以往可能在读取一次提示词后就冻结的权重生成方法不同,该系统在线更新其信念,允许有效权重随着模型在整个会话过程中内部状态的演变而重新推导。
与标准的上下文学习相比,这种方法具有几个实际优势。通过将实时数据表示在权重本身中,模型可以摊销计算成本,为其他任务腾出上下文窗口的空间,并可能更有效地泛化新信息。然而,向持续学习的转变也引入了新的复杂性。研究人员和观察者指出,在不断的权重更新过程中保持模型稳定性是一个重大挑战,因为当模型不断演变时可能会出现不可预测的行为。此外,持续学习模型可能会面临独特的安全风险,例如“投毒”,即特定的用户输入可能会将模型推向不同会话中的非预期行为或偏见。
虽然所提出的架构为能够从每一次交互中真正学习的模型提供了一条路径,但目前该研究仍处于预印本阶段,仅有初步结果。将这种“无限”权重空间与传统的混合专家模型(MoE)或低秩自适应(LoRA)技术进行对比的具体性能基准,仍是随着技术成熟而需要进一步研究的领域。