矩阵乘法的简单嵌套循环运行速度可能仅为 OpenBLAS 等专业库的 1.1%,因为它未能考虑到 CPU 如何将数据获取到缓存中。为了弥合高级代码与高性能内核之间的差距,Csongor Kiss 正在构建 Cachet,这是一种硬件假设(例如缓冲区占据哪些内存层级)作为源代码显式组成部分的语言。
隐藏优化的问题
优化程序通常涉及两种做法:要么希望编译器足够聪明到能够处理数据流,要么通过手动重写代码来匹配硬件。在后一种情况下,抽象层会崩溃,开发人员必须手动管理缓存驻留和向量化等复杂细节。
在这两种情况下,关键决策往往是隐藏的。编译器基于内部硬件模型做出决策,而人类开发人员则将其保存在大脑中或注释里。Cachet 旨在将这些决策移入语言本身,允许编译器检查随着代码演变,程序员关于硬件的假设是否仍然成立。
“在 Cachet 中,缓冲区留在哪个缓存中、内存层级之间移动多少数据,以及硬件提供哪些指令,都是语言的一部分。”
— Write your own kernel optimiser | Csongor Kiss
收缩与调度
Cachet 使用“收缩”模型来定义计算。开发人员不再编写循环,而是为每个输出元素编写一个数学方程。例如,矩阵乘法由一个公式定义,其中自由索引决定输出,求和索引决定操作。
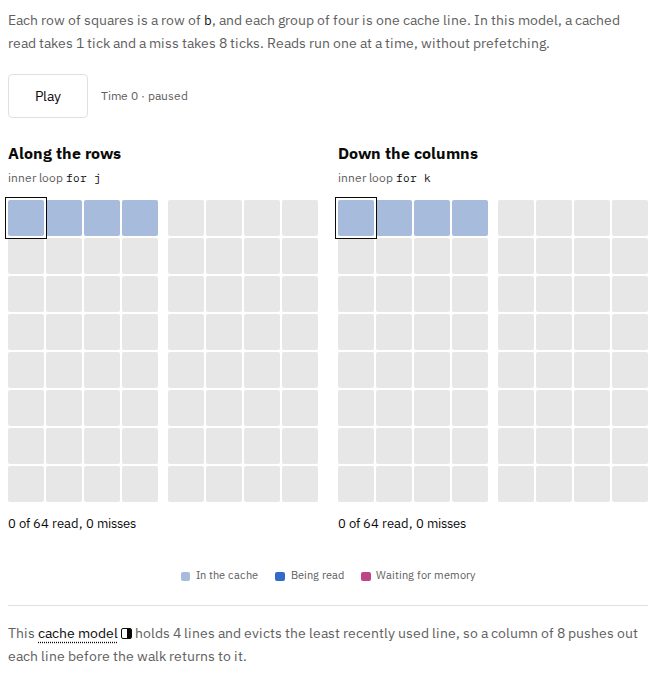
这张图片展示了 Cachet 旨在抽象为数学收缩的手动计算过程。
由 HN Digest 根据 blog.csongor.co.uk 报告的数据绘制;数值与源文件一致。
为了将此定义转化为快速程序,Cachet 使用“调度”——即一系列将收缩重写为优化循环嵌套的变换。编译器检查调度的每一步,以确保变换保留计算的原始含义,例如确保不同的输出不会以破坏数学逻辑的方式重叠。
可验证的重写与硬件映射
该系统使用“steps”库,其中每个重写操作都附带一个“证明配方”。这允许编译器验证某一变换(例如通过交换循环来提高缓存命中率)对于正在编译的特定程序在数学上是有效的。
这种方法允许进行复杂的优化,如“分块”(blocking),即在处理器对其执行多次操作时,将一块数据保留在缓存中。通过使这些步骤显式化,开发人员可以在编译器确保逻辑保持健全的同时,思考内存层级之间的数据移动。
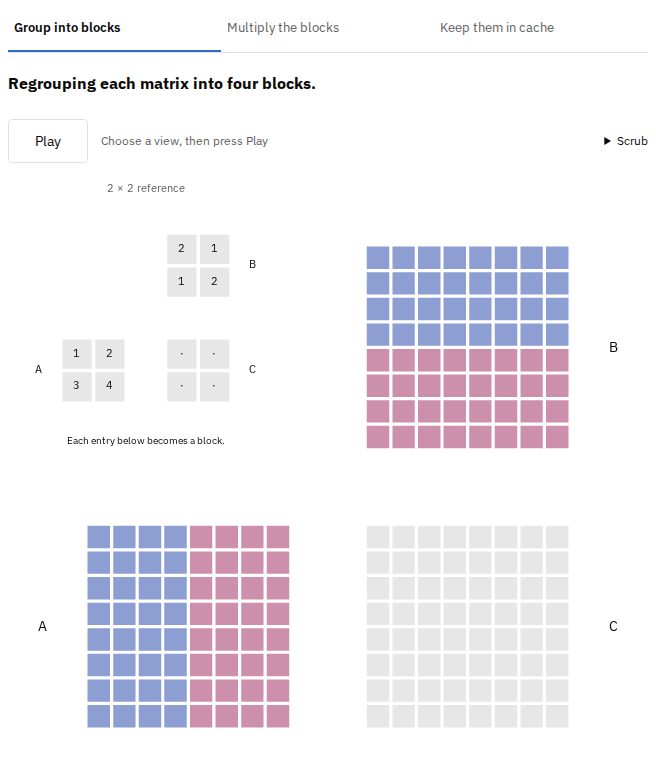
此图解释了输入重用的概念,这是文中提到的“分块”优化的关键组成部分。
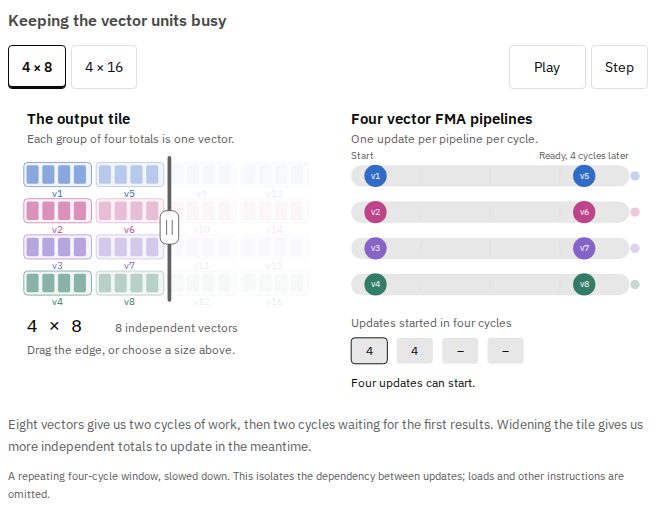
这张图片支持关于调整内核和硬件映射以获得最大性能的讨论。
权衡与当前限制
Cachet 的主要权衡是它要求程序员对底层硬件架构有更深入的理解。虽然这通过在编译时捕捉性能退化提供了安全性,但它比标准的高级库需要更多的前期架构知识。
目前,该工具可以验证针对 NVIDIA H100 硬件的程序,但尚未具备为该特定平台构建程序的能力。目标仍然是提供一个框架,使性能成为一种刻意的、可验证的选择,而不是“聪明”编译器的副作用。