权重空间编程描述了前沿 LLM 分析并修改机器学习模型原始权重(本质上是包含浮点数列表的模型文本描述)以改变其行为的能力。从历史上看,优化模型的行为涉及在提示词或训练代码等文本产物上进行“爬山”优化,或者使用 Adam 等符号优化器通过梯度下降来更新权重。在这种新范式中,LLM 利用其推理能力来确定神经网络的特定部分在计算什么,然后直接编辑这些权重,使模型符合自然语言规范。
最近的研究表明,诸如 GPT-6 Astra 等前沿模型仅通过查看原始权重就能识别网络被训练执行的特定任务。例如,当面对策略网络的 17,253 个权重时,Astra 在没有任何环境反馈或代码执行的情况下,正确识别出了 Breakout 和 Pong 等游戏。此外,这些模型还可以执行“权重空间”编辑来修复特定的故障。在其中一个案例中,Astra 识别出了 Qwen3.5-0.8B 模型中的推理循环,并通过原生编辑仅 0.016% 的权重对其进行了修正。这一单次修正将模型在 MATH-500 基准测试上的表现从 7.9% 提高到 48.1%,同时提升了其指令遵循能力。
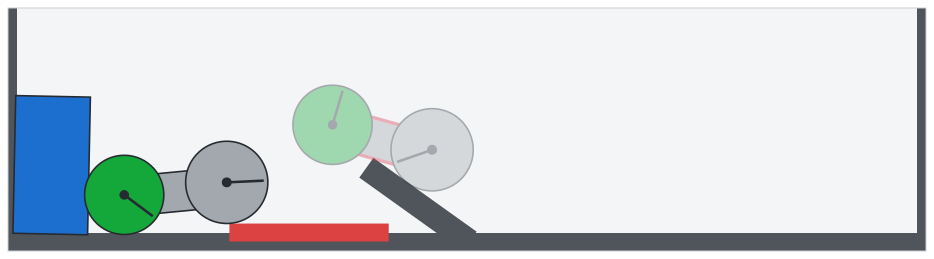
此视觉效果展示了权重空间编辑的成功结果,模型修正了导航任务中的特定故障。
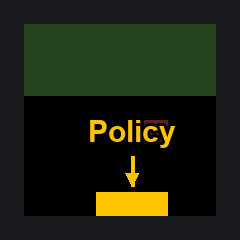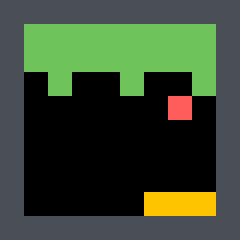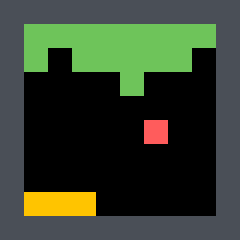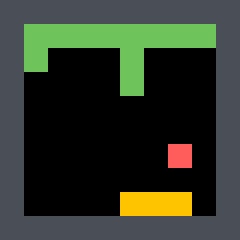
这张图片展示了玩 Breakout 的特定任务,Astra 模型能够通过分析原始权重识别出这一任务。
虽然这些结果表明向可微网络推理驱动的优化转变,但其实际意义和局限性仍是争论的焦点。一些观察者指出,模型进行这些编辑的推理轨迹往往人类无法理解,表现为一系列难以审计的复杂计算。此外,批评者指出,识别和修复权重问题的过程可能只是镜像反映了人类机器学习研究人员会采取的步骤,而不是代表机器逻辑在纯自主方面的飞跃。目前,这些实验集中在小规模网络上,目前尚不确定这种能力如何扩展到大型前沿模型中存在的数十亿参数,或者它最终是否会取代传统的基于源代码的开发。