一个处理来自每个收银机销售收据的系统面临着一个反复出现的问题:特定日期的报告永远无法真正最终确定,因为来自离线收银机的收据可能会延迟数周到达,而且 Kafka 的“至少一次”交付机制经常导致相同的收据被计算两次。为了解决这个问题,工程师们放弃了容易受到流异常干扰的传统“累加和”模型,转向一种将聚合视为源文档确定性函数的架构。
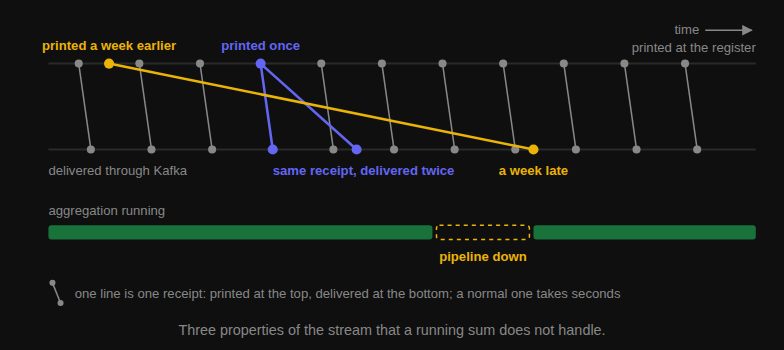
此视觉效果解释了工程师确定的导致数据不一致的具体流异常,如重复和延迟到达。
累加和的失败
标准的聚合流水线通常依赖“物化视图”,在数据到达时将其值添加到总计中。然而,当流中包含重复文档时,这种方法就会失效;系统会第二次添加该总和,且没有任何办法来识别或减去重复项。同样,如果一个文档延迟一个月到达,已经“关闭”该周期的累加和很难在没有复杂逻辑的情况下将其纳入。
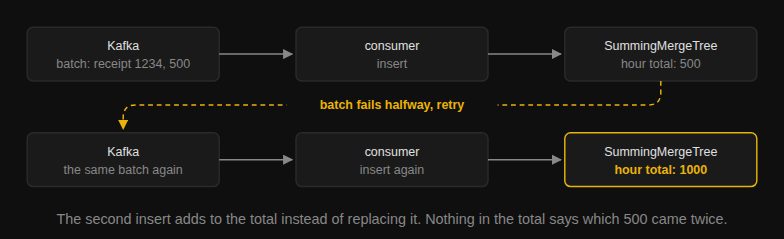
此图像展示了文中提到的“插入时累加”方法的特定失败模式。
工程师们测试了四种不同的方法来解决这个问题。他们尝试从宽表中重新计算,但由于数据不是按日期排序的,数据库必须读取 4600 万行数据才能找到所需的 508,000 条记录。他们还尝试在内存中保留每个已见键的字典,但键集太大,无法放入生产内存,导致系统完全崩溃。
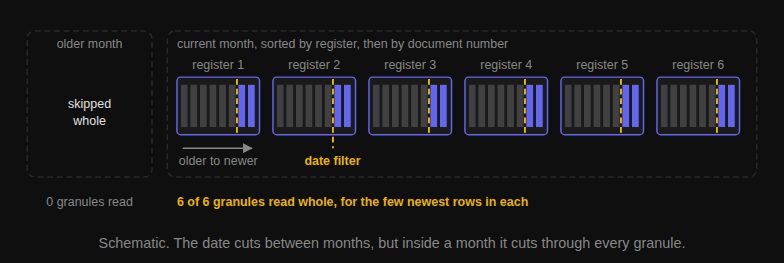
此图表支持了关于从宽表中重新计算需要读取数百万行无关数据的解释。
由 HN Digest 根据 alnovis.io 报告的数据绘制;数值按源文件显示。
“聚合不是插入内容的累加和,而是其文档的函数。”
— An Aggregate Is a Function, Not a Sum | Alexander Novikov
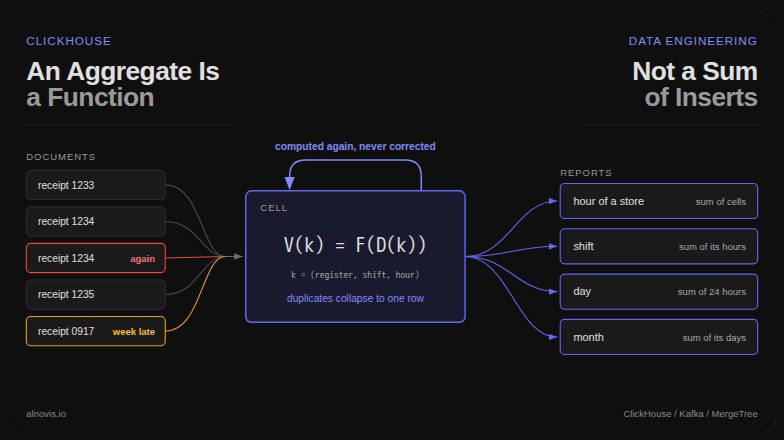
此图像作为文章核心论点的主要视觉效果:将聚合视为源文档的确定性函数。
Cell 模型与函数式聚合
解决方案是将聚合视为其文档的函数。系统定义了一个“Cell”——聚合的最小单位,例如特定收银机的班次和小时。每个文档恰好属于一个 Cell。该 Cell 的值通过对属于该键的文档进行分组并应用折叠操作(如求和或求最大值)来计算。
由于值是文档的函数,重新计算它是幂等的。如果一个文档被交付两次,系统在计算过程中会根据其唯一 ID 对其进行折叠。如果一个文档延迟到达,它只需将相应的 Cell 标记为“脏”,以便在下一次重计算过程中处理。这消除了对复杂且占用大量内存的去重表的需求。
利用窄表和日志进行优化
为了在 ClickHouse 中实现高效处理,团队使用了一个仅包含度量所需列的“窄表”,并按收银机和文档编号排序。这种布局确保了单个 Cell 的所有文档都相邻排列,允许系统执行短范围扫描而非全表扫描。在测试中,与宽表相比,这减少了 30 到 37 倍的读取行数。
“脏标记”日志跟踪哪些 Cell 需要重新计算。当插入文档时,会在 `ReplacingMergeTree` 中写入一个标记。后台进程将最后一次标记的时间与最后一次成功重计算的时间进行比较。如果标记比最后一次重计算更新,则该 Cell 将被添加到下一个处理批次中。这允许系统通过简单地从上次中断处继续执行来自动从故障中恢复。