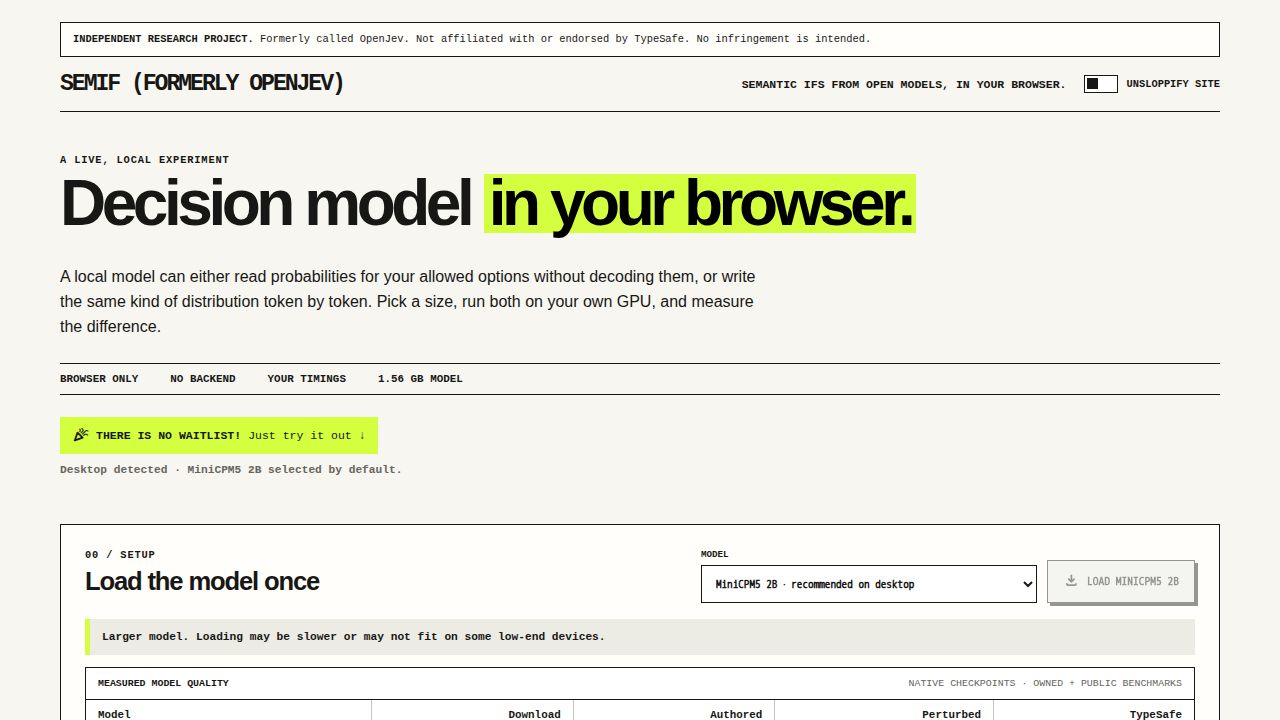
OpenJev 是 'Jev' 接口的开源重现版本,该系统由 TypeSafe 设计用于“运行时定义的语义决策”。与针对生成对话文本进行优化的标准大语言模型(LLMs)不同,Jev 被描述为一个非生成式、非指令微调的分类器。它的功能更像是一个高度复杂的 BERT 式模型版本,专门经过调整以针对一组预定义选项提供带有置信度的评分。这种方法使其能够作为一个可靠的决策者,通过保证不会生成特定提供集之外的 token,从而智能地驱动状态机。
Jev 与标准“结构化输出”(例如强制 LLM 输出 JSON)之间的技术区别在于“seq-to-1”范式。虽然标准 LLM 执行的是“seq-to-seq”任务——即模型必须预测一系列 token——但 Jev 专注于从固定词汇中选择最佳的单一选项。这种转变显著降低了与生成长字符串相关的计算开销和延迟。然而,由于 OpenJev 是该接口的开源重现而非原始专有模型的直接复制,它利用了一种特定的技术“技巧”来实现这些结果。它发送一个一次性的请求来建立共享状态,依赖于像 SGLang 这样的推理引擎将该状态保留在前缀缓存中,然后发送独立的提问请求,并将生成的评分转换为允许的答案 token 的概率。
虽然 OpenJev 在速度和成本方面比全规模 LLM 具有显著优势,但在推理深度方面存在明显的权衡。用户注意到,在这些实现中使用的较小模型可能缺乏像 Qwen 或 GPT-4 等大型模型中所具备的“知识和直觉推理”。此外,虽然该系统旨在更具确定性,但它仍易受提示词注入的影响,用户可以通过操纵输入来强制特定的分类。在复杂的逻辑测试中,OpenJev 框架中使用的较小模型可能会产生“抛硬币”式的答案,这突显了高速分类与大型生成模型深度推理能力之间的界限。