大型语言模型 (LLM) Agent 在进行可靠分析时经常面临困难,因为它们缺乏对组织数据格局的结构化理解。虽然 Agent 可以检索文档或查询数据库,但它们往往缺乏足够的上下文来了解特定数据存储在何处、其定义意味着什么,或者它如何与其他实体相关联。NVIDIA 的 Auto Ontology 通过提供一个位于原始数据和 AI Agent 之间的语义层来解决这一问题。该层充当知识图谱,协调不同系统之间不一致的定义,确保 Agent 的推理是基于经过认证的业务逻辑,而非仅仅是原始的、可能存在歧义的数据点。
该框架作为一个多组件堆栈运行,使用 FastAPI 后端、Next.js 前端,以及配备 pgvector 用于向量存储的 Postgres 数据库。它允许开发人员从现有元数据中发现并生成企业本体,提供一种将 Agent “锚定”在可信关系中的方法。一个关键的技术特性是其能够将自然语言问题转换为 SQL 查询,并根据经过认证的定义和血缘关系进行验证。这一过程确保了生成的答案包含溯源信息,使 AI 的输出更具可解释性。该系统还支持 Model Triplets——用于推理、实体提取和嵌入的特定配置——这些配置可以通过 NVIDIA NIM 端点或自托管实例进行托管。
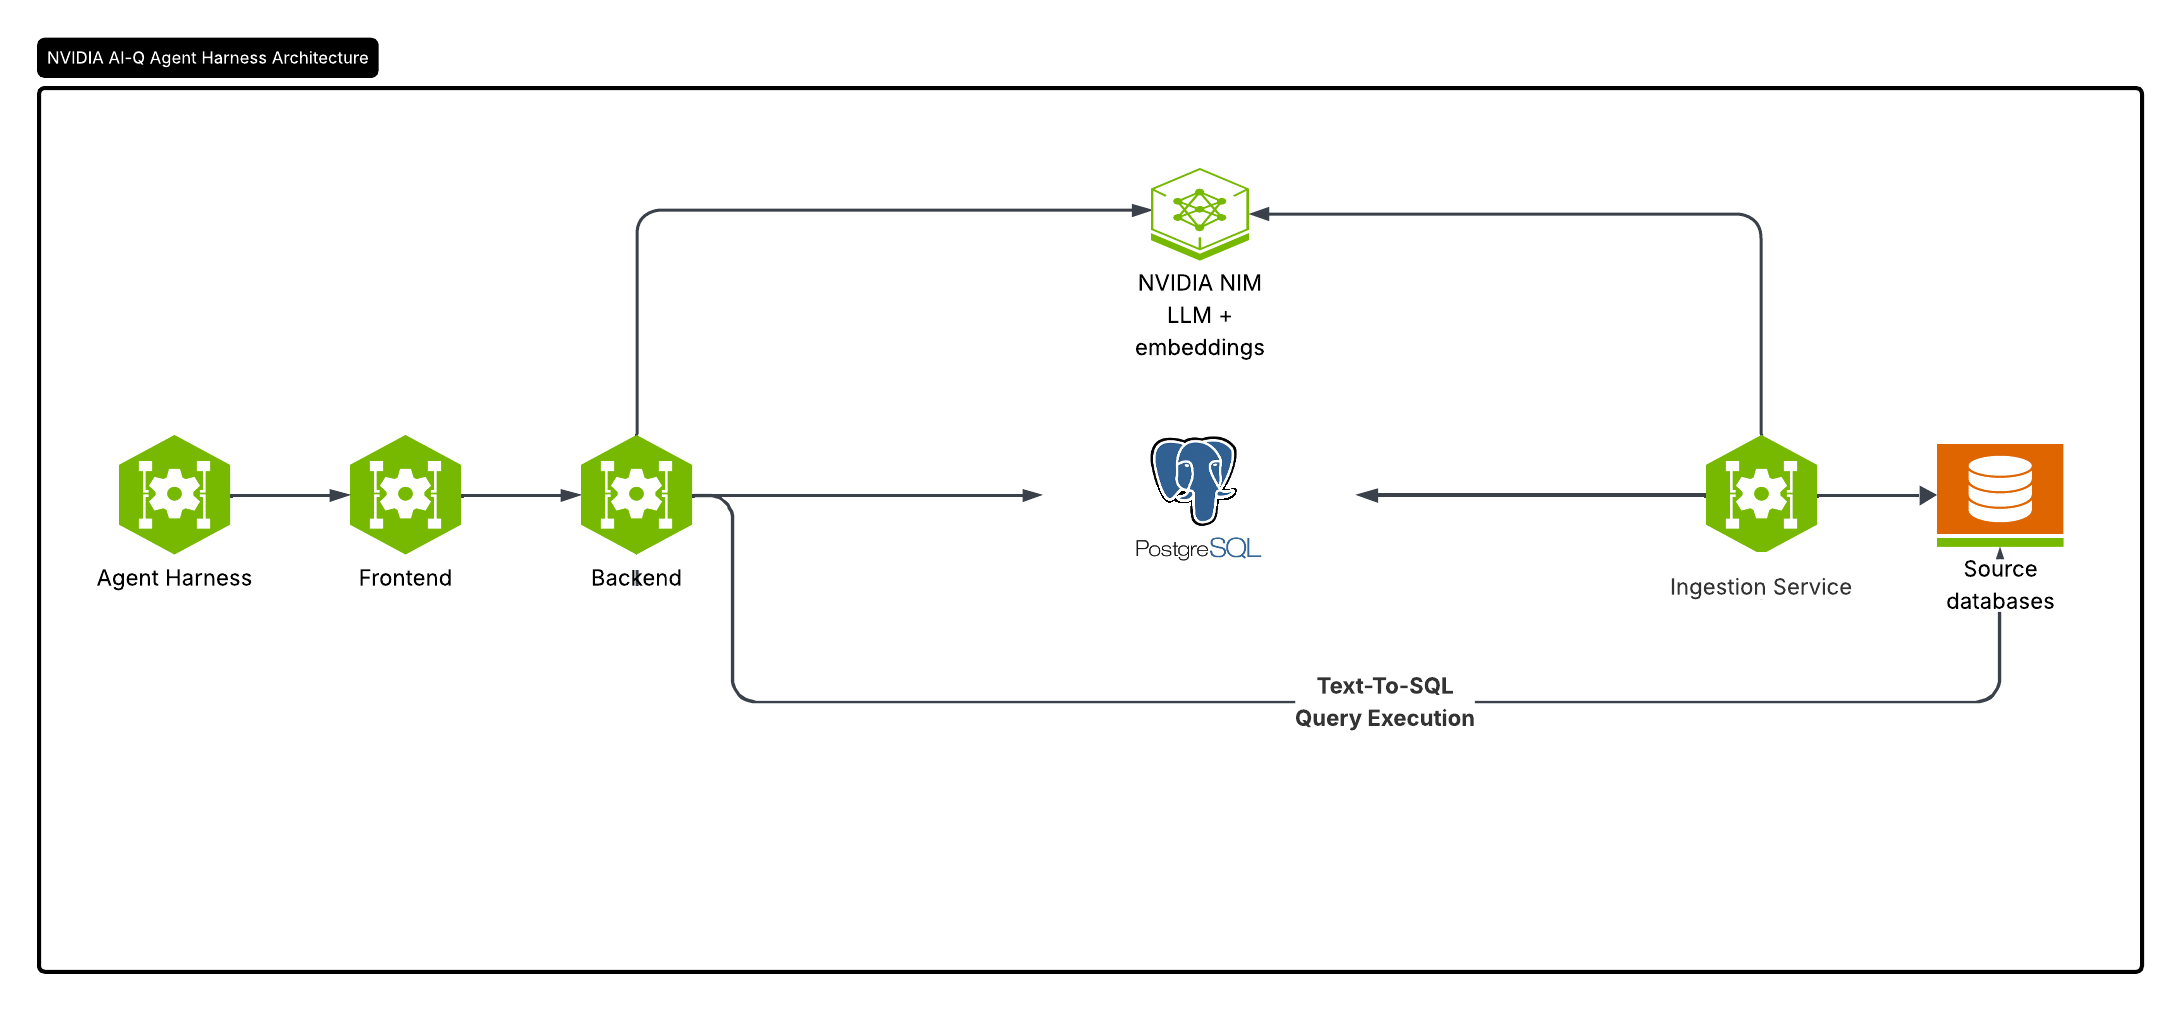
该框架作为一个多组件堆栈运行,使用 FastAPI 后端、Next.js 前端,以及配备 pgvector 用于向量存储的 Postgres 数据库。
尽管该框架专注于可靠性,但它也引入了特定的操作要求和限制。用户必须手动配置源数据库(如 Snowflake、Databricks 或 DuckDB)的连接字符串,并通过环境变量管理 Model Triplets。虽然系统提供用于聊天和数据编目的 Web UI,但目前它不接受外部贡献,这意味着其增长取决于 NVIDIA 的内部开发。此外,虽然该框架旨在解决 Agent 分析中“不可靠”的特性,但用于自动协调不同系统之间冲突定义的具体逻辑仍是内部实现细节,并未在公共仓库中完全详述。该系统旨在通过 Model Context Protocol (MCP) 进行扩展,使其能够与 Claude Desktop 或 Cursor 等流行的 Agent 框架集成。
证据: 1. 主要来源 (GitHub - NVIDIA/auto-ontology) 确立了该框架通过从企业元数据构建推理层,实现“确定性查询生成”和“更好的上下文检索”。 2. 主要来源还详细说明了技术堆栈,包括使用 FastAPI 作为后端、Next.js 作为前端,以及与 NVIDIA NIM 进行推理的集成。 3. 主要来源明确指出,该框架允许根据经过认证的定义“验证”生成的查询,并在每个答案中返回溯源信息。
编辑意见: - evidence_sufficient: true - source_limited: true - submission_only: false - discussion_digest: false - editorial_angle_research: - 问题 1:Auto Ontology 具体如何处理两个不同源数据库之间冲突的元数据定义? - 回答 1:来源指出它“协调跨系统的定义”以提供“可信的业务含义”,但提供的文档中并未详细说明此项协调的具体算法逻辑。 - 问题 2:Auto Ontology 的 text-to-SQL 生成与标准 RAG 相比的具体性能基准是什么? - 回答 2:来源提到了 text-to-SQL 基准测试 (BIRD) 并提供了评估仓库的链接,但在主要文档中并未列出具体的对比分数。