随着编码代理加速软件开发速度,主要的瓶颈已从编写代码转向验证新代码在实时环境中是否正常运行。Momentic 是一家获得 Y Combinator 支持的初创公司,通过提供一个代理式质量平台来解决这一问题,用户可以在其中用纯英文描述用户流程。该平台随后会对应用程序运行这些测试,以验证关键路径并在 Bug 到达生产环境之前识别回归问题。
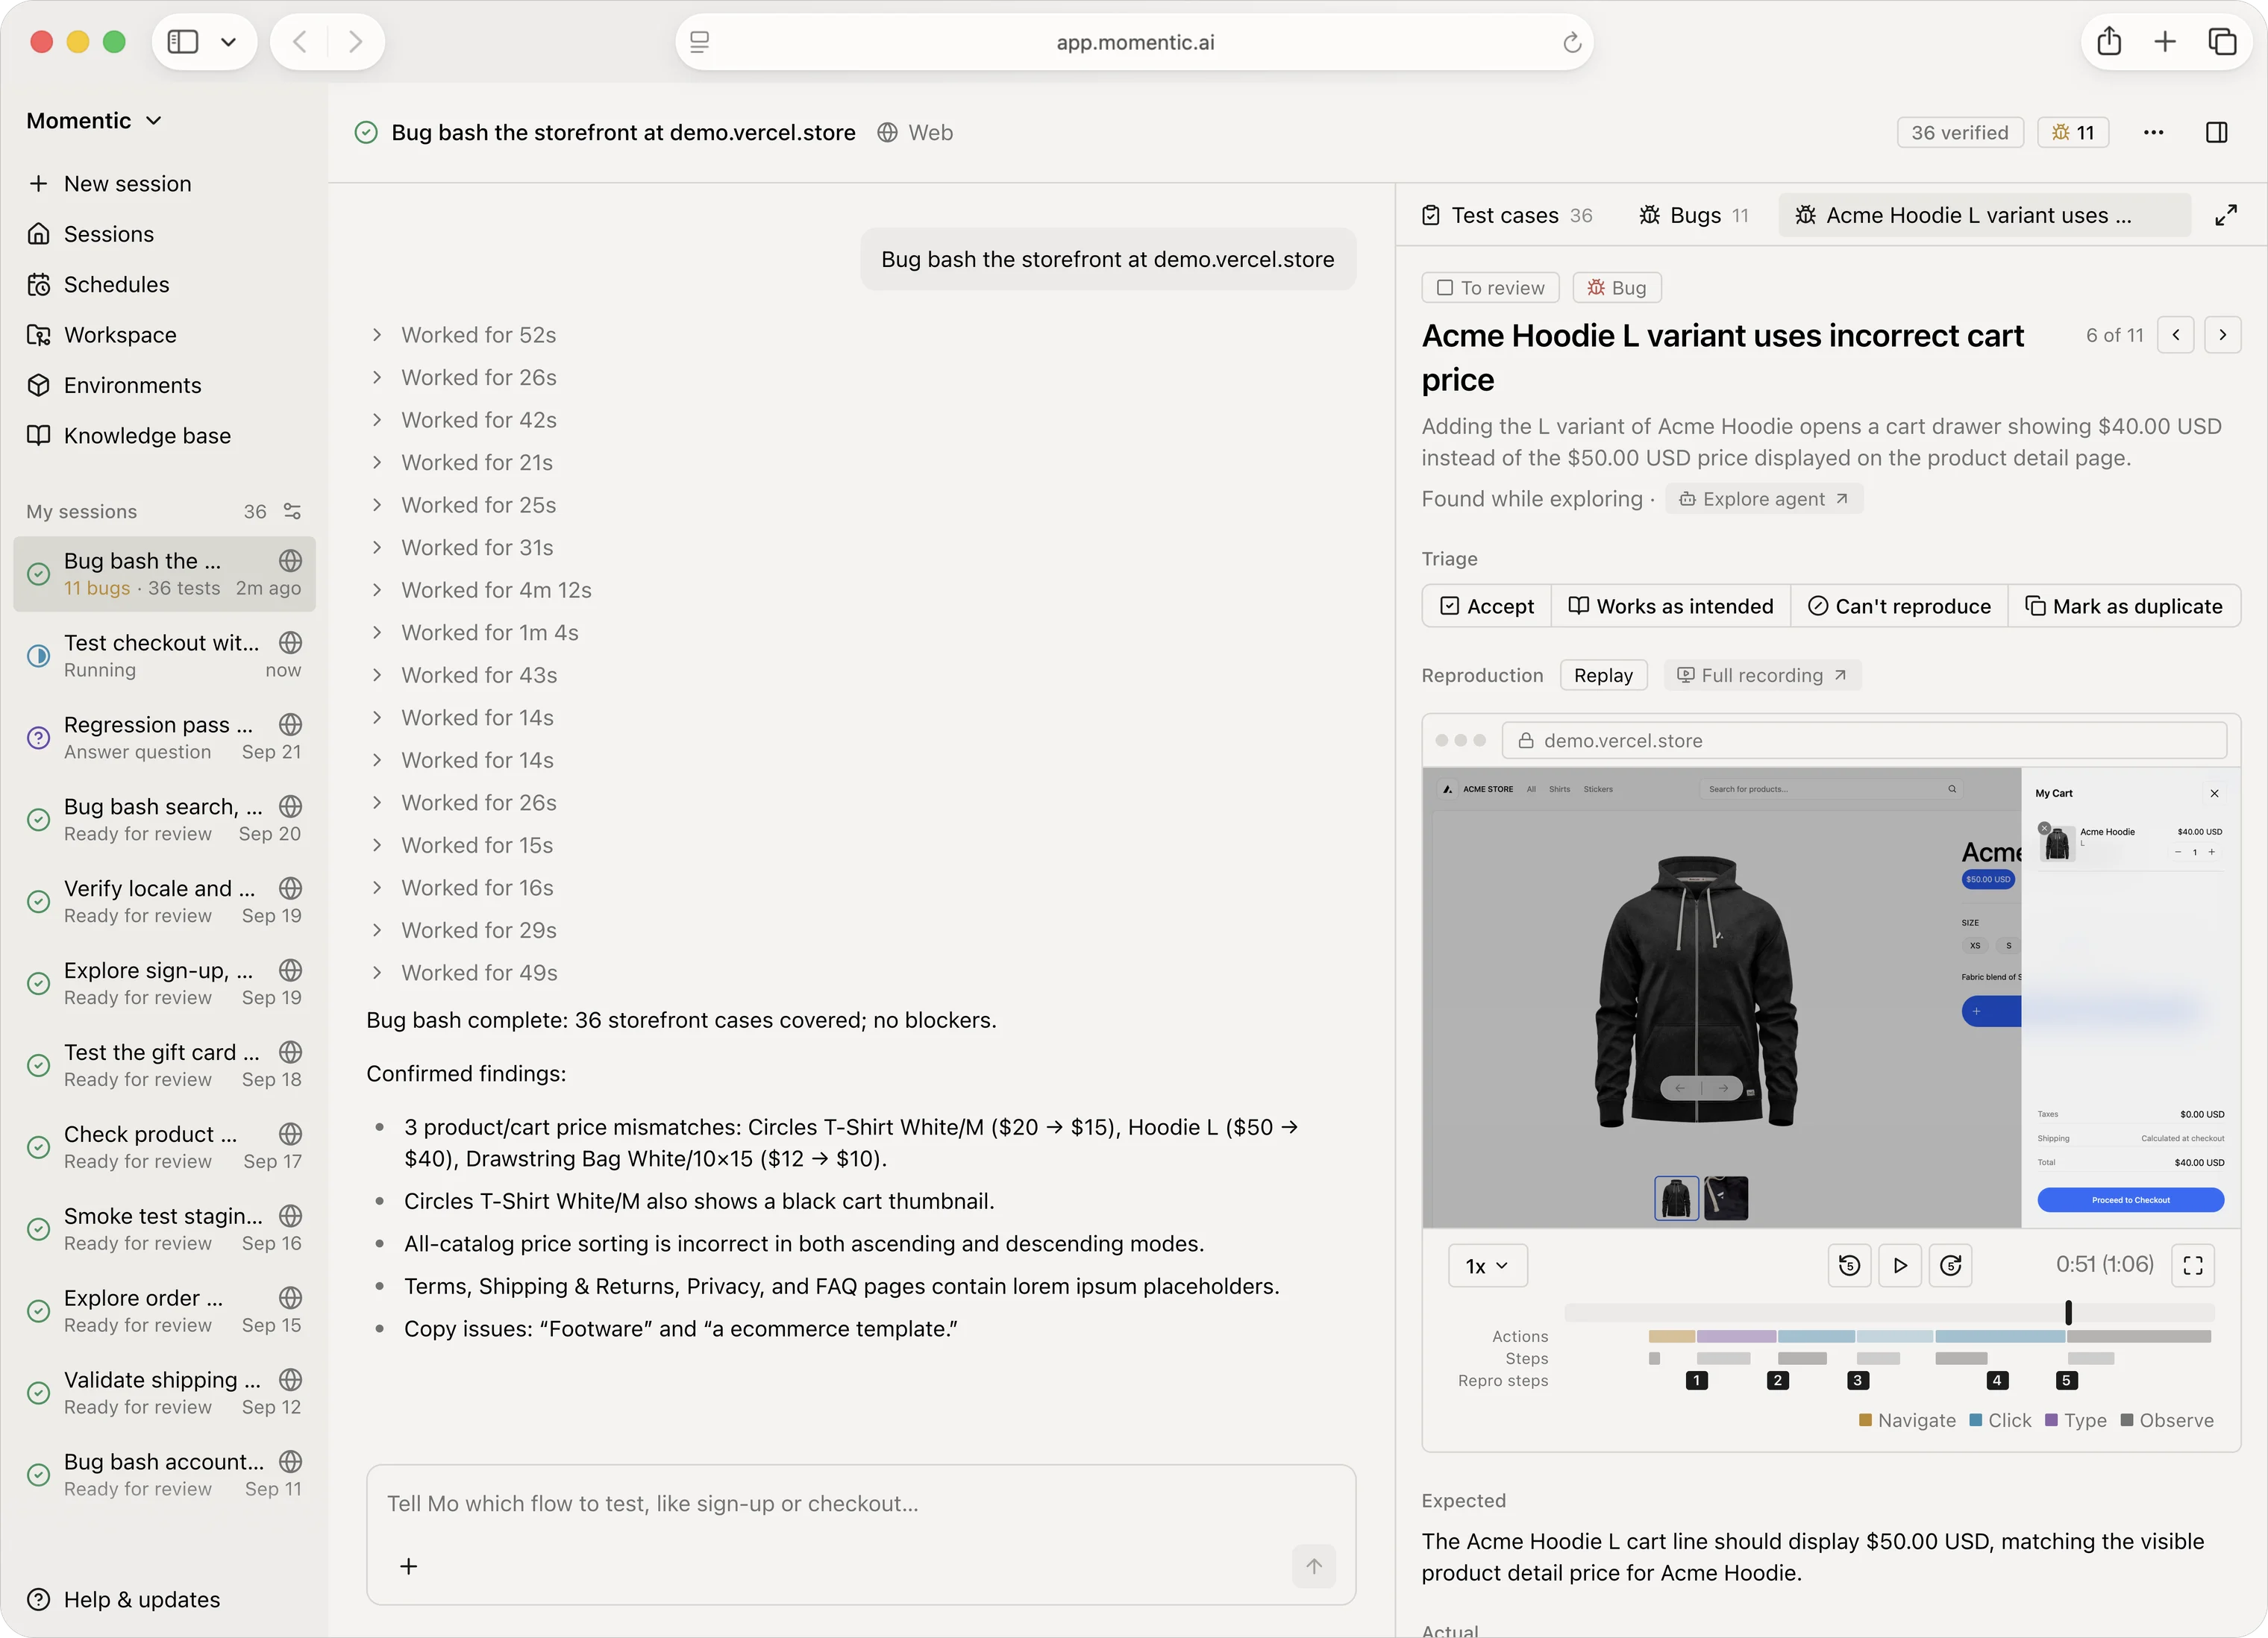
这张图片展示了代理式质量平台,用户可以在其中描述流程,而平台负责识别回归问题。
为了评估其性能,Momentic 建立了一个名为 'QA Bench' 的第一方基准测试。该测试将 Mo 与其他知名代理(包括 Codex、Claude Code 和 Devin)进行对比,测试对象是四个流行开源应用程序(Gitea、Metabase、Twenty 和 Saleor)中 1,396 个由人工标记的 Bug。在基准测试期间,代理被限制访问应用程序源代码或互联网,迫使其依赖与实时 UI 的交互。在对该套件进行 60 分钟的测试过程中,Mo 匹配了 269.3 个参考 Bug,显著优于次优配置 Codex (86.3) 和最佳 Claude Code 配置 (59.0)。
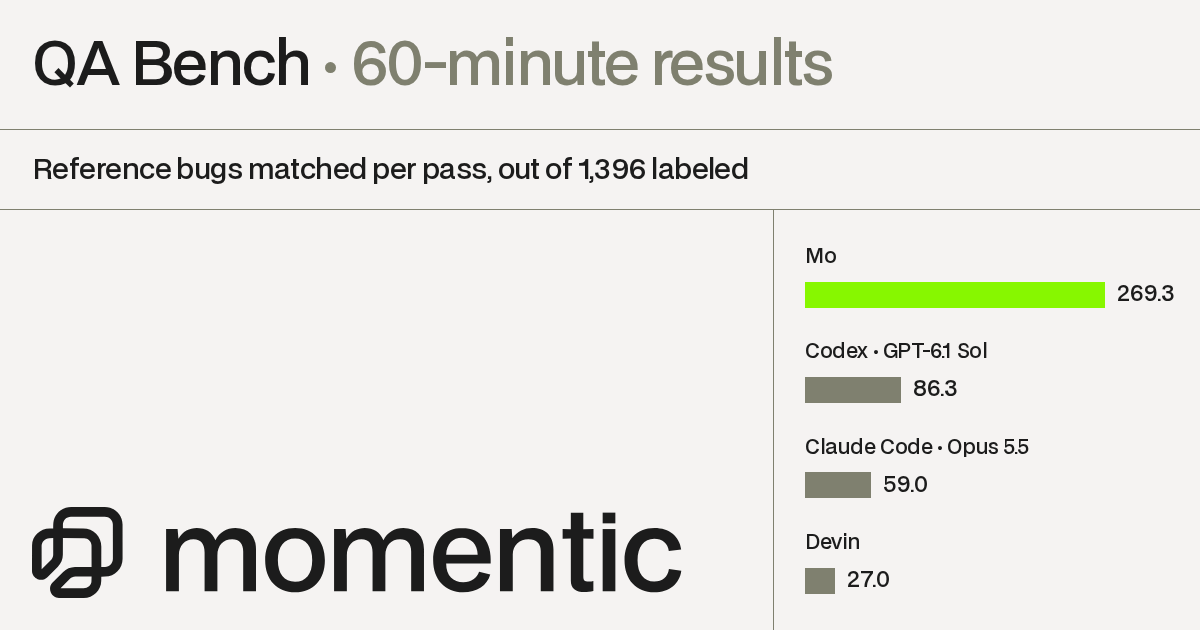
该图表提供了 60 分钟基准测试期间不同编码代理 Bug 召回性能的视觉对比。
Mo 的性能优势源于其专门的架构。与通用编码代理不同,Mo 利用“知识库”,开发人员可以在其中定义特定于产品的术语、业务规则和预期行为。这种上下文允许代理在测试运行期间做出更明智的决策。此外,该平台具有“自动修复”功能,可识别 UI 更改何时破坏了测试,并提出对测试文件的修复建议。虽然 Mo 在基准测试中实现了最高的召回率 (19.3%),但其每个匹配 Bug 的成本 ($2.67) 高于最精确的 Codex 配置 ($0.80),但仍低于 Claude Code Opus 配置 ($4.09)。
由于 QA Bench 是由 Momentic 进行的第一方评估,其结果受限于平台自身的评分系统。该基准测试使用 LLM 裁判将代理报告与参考集进行匹配,与独立的第三方测试相比,这可能会引入偏差。此外,虽然 Mo 展示了高召回率,但单次运行仍会导致大部分标记的 Bug 未被发现,这表明该代理目前最适合用于识别高优先级的回归问题,而非进行详尽的 Bug 猎取。