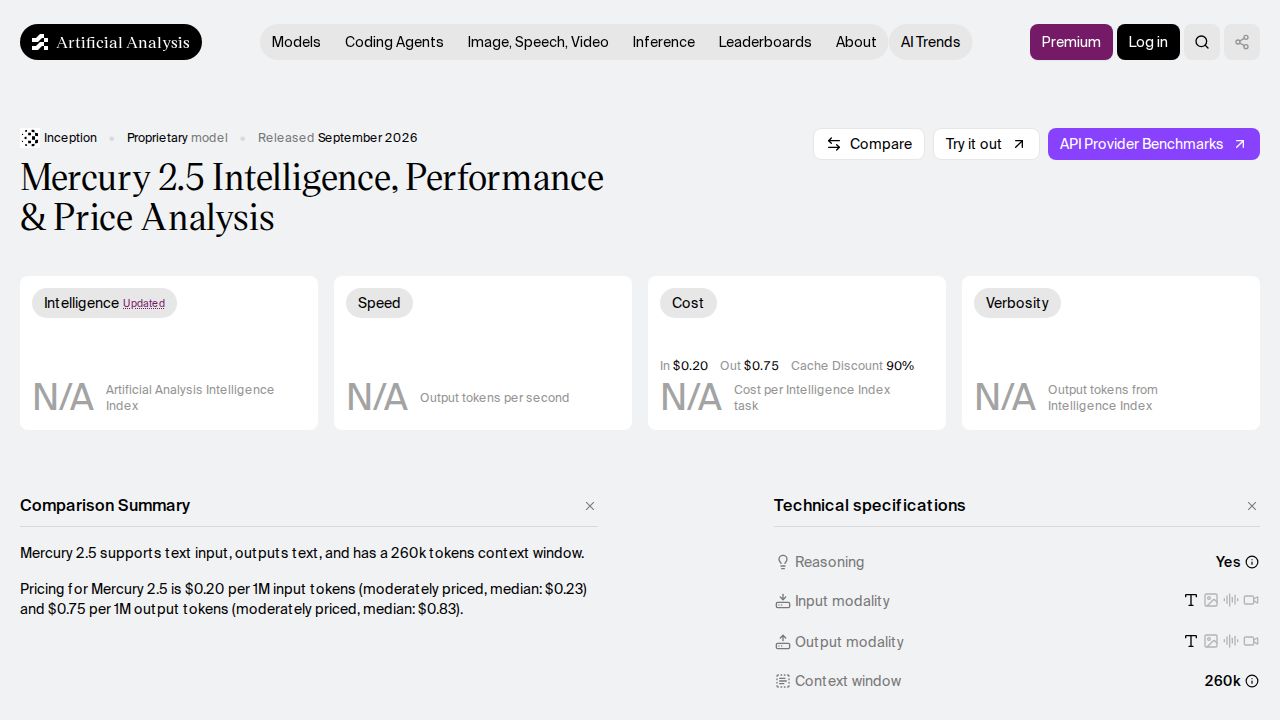
Mercury 2.5 因其显著的推理速度引起了广泛关注,达到了每秒 770 个 Token 的基准。这一性能使其成为大语言模型 (LLM) 领域中的高速选择,在实时应用中,快速的 Token 生成是一个关键指标。然而,该模型的主要吸引力——速度——伴随着认知性能上的显著权衡。根据来源数据,Mercury 2.5 的智能水平被描述为“低于平均水平”,其表现往往不如更小但能力更强的模型,例如 GPT-OSS-20B 或各种 14B 参数模型。
用户和观察者对优先考虑速度而非准确性的模型在实际应用中的表现提出了质疑。一位评论者指出,该模型的智能水平明显低于前沿 AI 产品,这表明高速度可能无法弥补推理能力的不足。此外,还强调了一些特定的技术限制,例如该模型在处理诸如工具调用 (tool calling) 等复杂任务时表现挣扎。此外,一些用户对该模型采用的“扩散 LLM (diffusion LLM)”方法表示怀疑,认为它可能并不代表可行的“帕累托前沿 (Pareto frontier)”——即在不牺牲智能的情况下无法进一步提高速度的状态。
与其他高速替代方案相比,Mercury 2.5 面临着激烈的竞争。例如,据报道 Cerebras gpt-oss-120b 模型可达到每秒 1400 个 Token 的速度,尽管它因在工具调用方面“崩溃”以及高昂的运营成本而受到批评。此外,一些用户指出,Mercury 2.5 的定价(0.25 至 0.75 美元)可能不如 DeepSeek v4 Flash 或 Qwen 3.8-flash-next 等其他开放权重模型具有竞争力,后两者可以在保持更高智能的同时以更低的成本提供服务。这些因素留下了一个开放性问题:Mercury 2.5 是否占据了独特的细分市场,还是其速度被性能限制所掩盖。