Apple 采用了一套复杂但私有的系统,用于管理其键盘和自动纠错引擎中的粗俗内容和敏感内容。该系统的核心是 Lexicon.framework,这是一个私有框架,负责管理位于系统语言数据文件夹中的各语言词典。这些词典中的每个单词都关联了两个 32 位标志字段:一个用于表示“粗俗程度”层级,另一个用于表示“主题”位掩码。虽然 Apple 没有提供这些标志的公开 API,但可以通过私有的 C 函数访问它们,从而揭示操作系统是如何对语言进行分类的。
该系统将内容分为三个主要层级:“粗俗”(脏话和性俚语)、“冒犯”(针对特定人群的侮辱性词汇)以及“敏感”(轻微脏话、侮辱、毒品、武器和生理功能)。此外,单词还会被分配到多达 11 个主题标志中,例如排泄、身体部位、毒品、政治和宗教。例如,虽然像“Trump”这样的词被标记在敏感层级,但它同时也带有政治主题标志。这些标志是独立工作的;一个单词可以拥有主题标志而未被分配到粗俗层级,这可能作为排名引擎处理该词时的谨慎提示。
为了平衡这些标志与用户意图,macOS 在 `~/Library/Keyboard/VulgarWordUsage.db` 维护了一个本地 SQLite 数据库。该数据库追踪系统已识别为粗俗的词汇的使用情况,记录每个应用程序和每个接收者的使用次数。其目标是让键盘能够“学习”用户的习惯——例如,识别出用户可能会在即时通讯应用中对亲近朋友使用脏话,但在给同事写电子邮件时,系统应引导用户选择“干净”的替代词。然而,这些数据填充的确切机制仍有些模糊;在某些测试中,标准的文本输入并未触发数据库中的新条目,这表明记录功能可能仅限于特定的应用程序或设置。
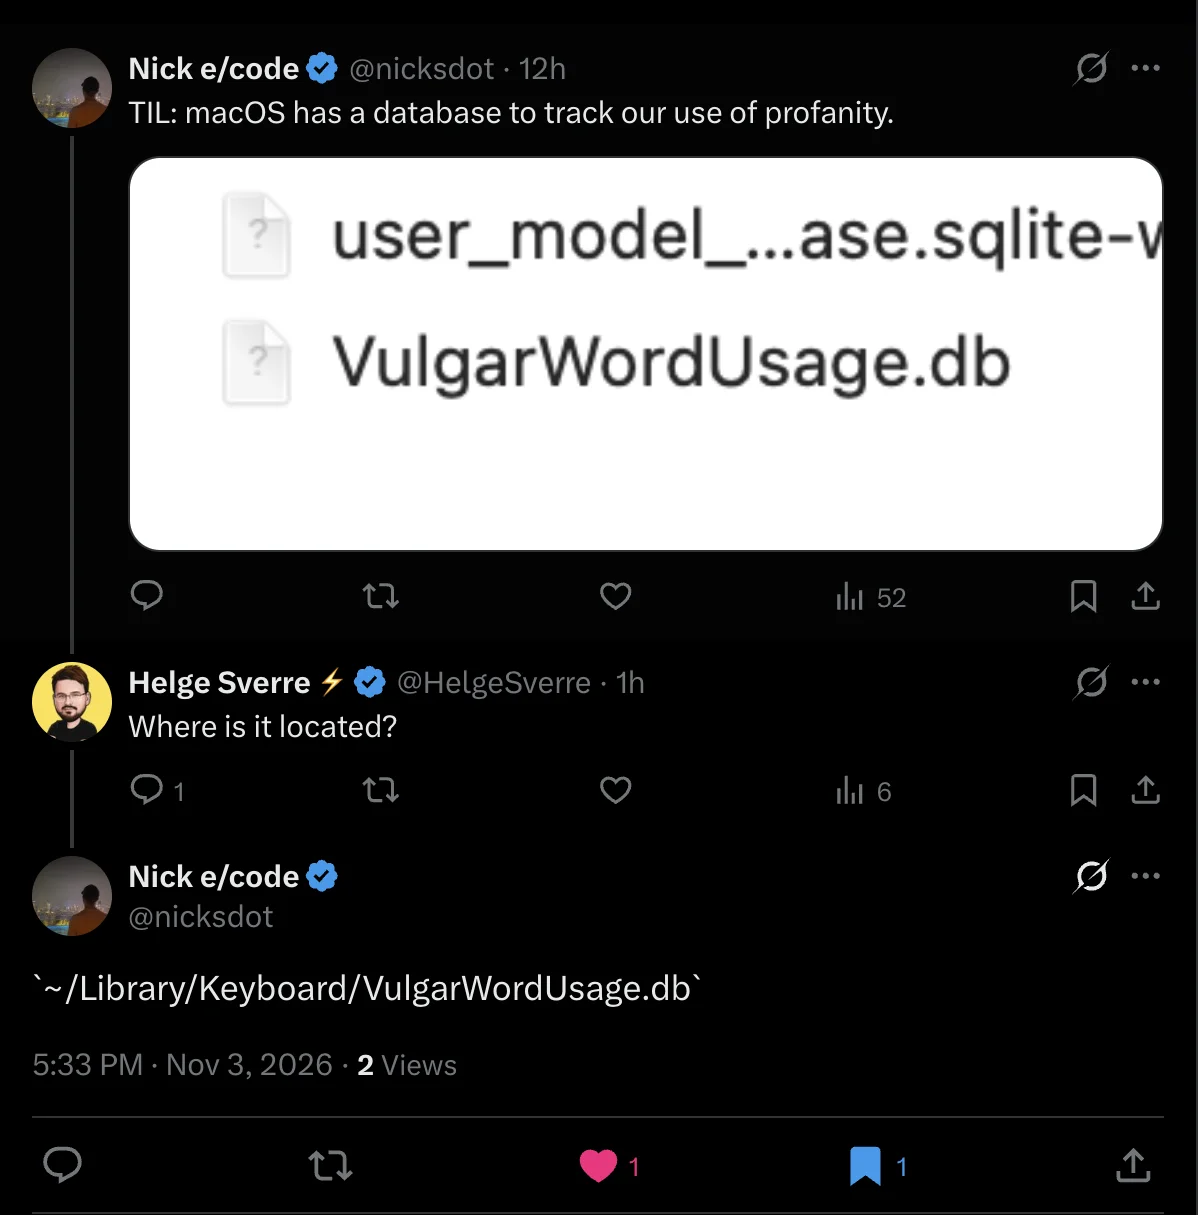
图片显示了文章讨论的本地词汇追踪中提到的特定文件路径和数据库名称。
由于这些框架是私有的,因此没有关于确定这些分类的具体逻辑的官方文档。数据转储结果显示,某些条目似乎是人工挑选而非基于规则的,例如将“Oedipus”包含在粗俗层级中,或将“niggardly”包含在冒犯层级中。这凸显了一种权衡:Apple 优先考虑提供经过策划的“安全”自动纠错体验,而非纯粹的算法方法,即使这会导致一些语言上的怪异现象或对常见名称和术语的主观分类。该系统的最终目标是确保,如果用户输入一个粗俗词汇,键盘只有在用户已建立在该特定语境下使用该词的模式时,才会建议该词。