“权重空间编程”的概念暗示了神经网络优化方式的转变。与其依赖于使用梯度下降迭代更新权重的 Adam 或 Muon 等符号优化器,该前提是前沿大语言模型(LLMs)可以根据自然语言目标直接对权重进行推理和修改。来自 MIT CSAIL 等研究人员的最新研究声称,GPT-6 Astra 模型能够识别网络权重中的缺陷——例如 Qwen3.5-0.8B 模型中的推理循环——并通过编辑极小比例(0.016%)的权重来修复这些缺陷,且无需使用梯度。据称,这允许实现显著的性能飞跃,例如将 MATH-500 分数从 7.9% 提高到 48.1%。
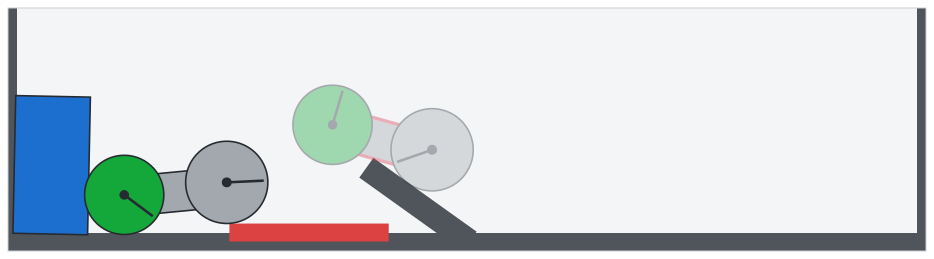
图像展示了在 Astra 权重编辑后,汽车跳跃任务成功的性能飞跃。
然而,对这些实验的技术审计揭示了 Astra 与小网络交互方式与大网络交互方式之间的区别。在涉及极小网络(权重数量在 17,000 到 172,000 之间)的实验中,Astra 确实能够直接“读取”原始权重。在这些案例中,原始浮点数被放入模型的上下文窗口中,并要求 Astra 识别网络的用途或修复特定的故障。由于权重数量足够少,可以作为提示词进行处理,因此模型能够执行一种直接权重分析。这展示了一种对权重空间的“整体”理解,模型能够将特定的数值模式与功能行为联系起来。
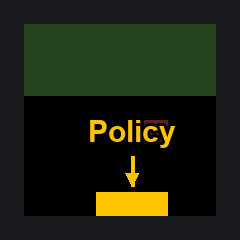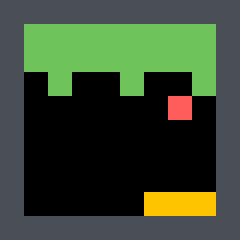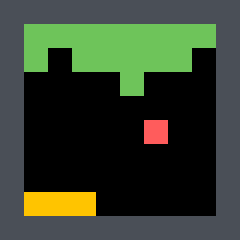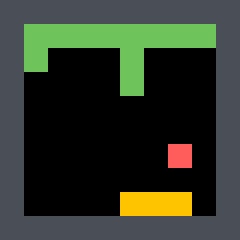
图像显示一个正在玩 Breakout 的网络,展示了可与权重模式相关的功能行为。
对于涉及 Qwen3.5-0.8B 模型且引起轰动的结果,其机制发生了显著变化。由于该规模的模型无法将其权重作为原始浮点数输入到提示词中,Astra 转而利用 Python 内核。在这种情况下,Astra 充当了编排者:它设计并执行 Python 代码,在 50 批练习题上运行模型,分析输出以识别问题,然后编写代码来修改权重。虽然这是一种复杂的机器学习工程形式,但它从根本上不同于直接“读取”权重。这一区别至关重要,因为这两个结果——在微型网络上的直接权重读取和在大模型上的工具辅助权重编辑——并非源于单一的统一技术。相反,它们代表了 LLM 与权重空间交互的两种不同方式:一种是作为数字的直接观察者,另一种是作为使用外部工具操纵这些数字的高级程序员。
这一区别凸显了 AI 能力中显著但细微的进步。虽然 Astra 自主设计并执行这些复杂机器学习工程任务的能力与以往模型相比是一个巨大的飞跃,但它并非单一的“魔法”能力。这一成就在于模型能够推理整个工程过程——识别故障、设计基于代码的解决方案并执行该解决方案——而不是像看到微型模型权重那样,拥有“看到”大模型权重的单一能力。对于研究人员和工程师来说,这意味着虽然“权重空间编程”是优化的一种可行路径,但随着目标网络规模的增加,实现这一目标的方法可能仍将保持混合状态,将模型的推理能力与程序化工具相结合。