随着 OpenAI 的开发速度加快,公司的 monorepo 面临着巨大的扩展挑战。Codex 和其他 AI 工具的集成使工程师能够并行执行更多工作,导致来自研究任务和 CI 环境的并发推送、合并和获取请求激增。这些需求最终导致现有的源码控制系统陷入困境,由于获取缓慢和合并失败,可靠性偶尔会降至 90% 以下。为了解决这个问题,OpenAI 工程师构建了 Pando,这是一个全新的 Git 仓库后端,旨在处理“代理规模”的工作——在这种模式下,人类工程师和 AI 代理同时与代码库进行交互。
Pando 的设计目标是对用户透明;它在驱动 monorepo 的同时,不需要工程师更改现有的 Git 工作流或工具。该系统通过重新思考传统 Git 服务中的两个核心限制来实现水平扩展。首先,它独立协调分支的更新。在许多标准系统中,所有对仓库的写入都被强加单一顺序,这意味着向一个分支的推送可能会等待与无关分支的推送。Pando 通过允许无关分支并行更新来消除这一瓶颈。其次,Pando 通过在不同客户端之间复用 'packfiles'(Git 用于多个对象的压缩格式)来优化读取吞吐量。服务器不再为每次获取生成唯一的 packfile,而是向多个客户端提供相同的字节,显著降低了 CPU 和磁盘 I/O。
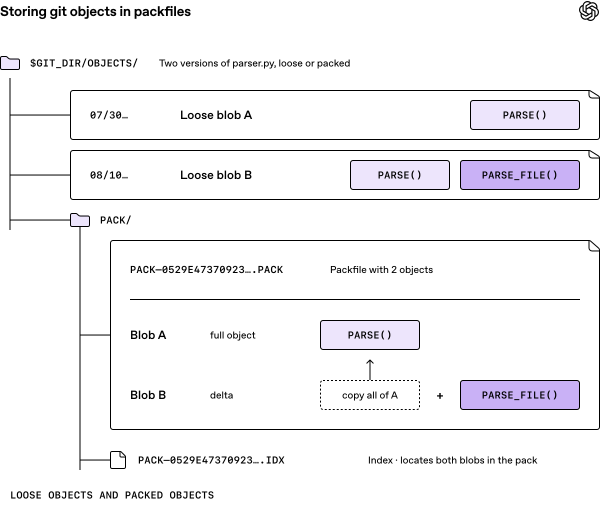
文章解释了 Pando 如何通过复用 packfiles(Git 用于多个对象的压缩格式)来优化读取吞吐量。
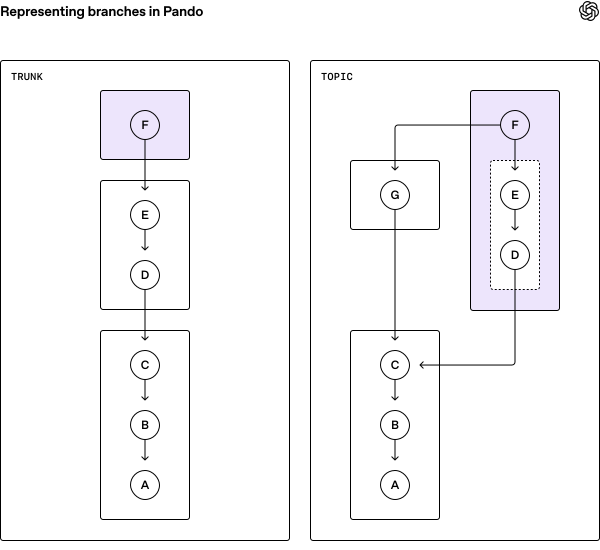
文章描述了 Pando 如何独立协调分支更新以消除传统 Git 服务中的瓶颈。
为了实现这一规模,Pando 采用了“因果一致性”模型,这涉及关于全库状态的特定权衡。由于 Pando 独立协调分支,它不提供整个仓库中所有引用在单一一致时间点的快照。例如,如果客户端在两个不同分支被更新时执行全量克隆,客户端可能会看到一个分支处于版本 A,另一个分支处于版本 B,即使它们在技术上是“同时”更新的。然而,Pando 保持了单个引用的可串行化,确保单个分支的更新保持一致。在生产环境中,这种架构将中位推送延迟降低了近 5 倍,目前每天处理近 1 PB 的 Git 数据。虽然该系统提供了高吞吐量,但目前利用该系统的具体 AI 代理数量仍未披露。