来自 MIT CSAIL 及其他机构的研究人员确定了一种他们称之为“权重空间编程”的新范式。传统上,优化神经网络涉及使用 Adam 或 Muon 等符号算法,根据梯度迭代更新权重。相比之下,权重空间编程涉及通用大语言模型对网络的原始数值权重进行推理,以识别特定的行为、故障或特征,然后手动编辑这些权重以实现预设的自然语言目标。
在一系列实验中,研究人员展示了 GPT-6 Astra 能够以惊人的准确度执行这些任务。例如,Astra 仅通过将 17,253 个原始权重作为文本读取,就能识别出一个小型神经网络被训练用于玩哪款电脑游戏(如 Breakout 或 Pong)。它还成功识别出了语言模型中间层中的“复制头”——即 Transformer 块中允许模型重复之前文本的特定组件。这些能力是在不允许模型运行前向传播或使用外部工具的情况下展示的,这表明 Astra 是在读取权重的底层几何结构和架构,而不仅仅是在计算输出。
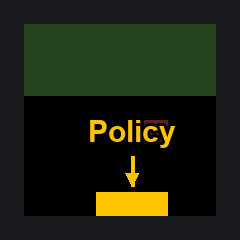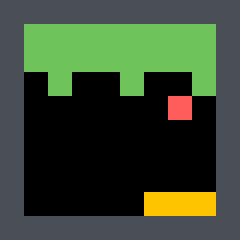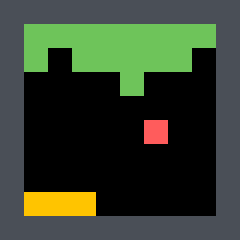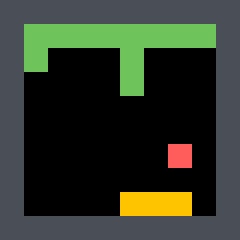
此视觉效果代表了 Astra 识别小型网络训练目标游戏的实验。
该技术最显著的应用涉及对模型故障的“一次性”修复。当被要求提高 Qwen3.5-0.8B 的数学性能时,Astra 识别出了导致推理循环的特定权重问题,并仅编辑了模型 0.016% 的权重。这一手动修正将该模型在 MATH-500 基准测试上的得分从 7.9% 提高到 48.1%,并使其指令遵循性能提升了三倍。同样,在汽车因局部最优策略卡在坡道上的物理控制任务中,Astra 编辑了 3.5% 的权重,在网络单元中添加了一条独立的路径,使汽车能够成功倒车并清除障碍。虽然这些结果令人振奋,但目前的研究集中在中小规模模型上,尚不确定这种权重空间推理是否能线性扩展到巨大的前沿模型,还是仅作为小型架构的专门能力存在。
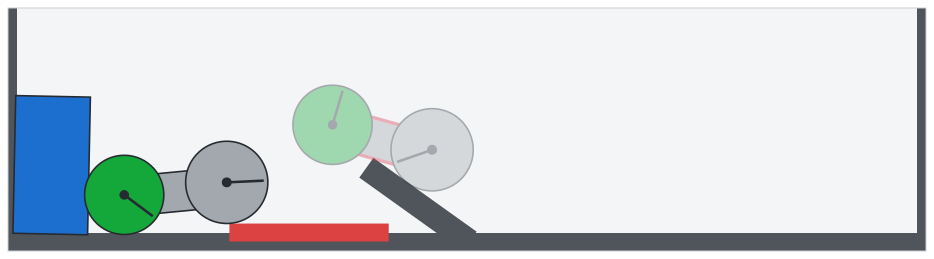
该图像展示了 Astra 编辑权重以允许汽车清除局部最优障碍的物理控制任务。