Demoscene 是一个专注于在严格的技术限制(如极小的文件大小或受限的硬件)下挑战计算机图形和音频极限的亚文化。平台 Datavorous 上的一位开发者最近开展了一个项目,利用机器学习来探索编程语言的“生产性”特征。通过将 Dweets(托管在 Dwitter.net 上、长度为 140 字符的 JavaScript 演示)中独特的、经过代码高尔夫(code-golfing)处理的语法视为一种语言系统,作者试图使用自回归模型来采样未完成代码的合理延续,从而有效地为创意编程创建一个“自动补全”工具。
为了实现这一目标,该开发者使用 Qwen2.5-Code-7B 作为基础模型。由于 Dweets 高度依赖于与标准编程不同的数学简写和代码高尔夫技巧,基础模型最初在处理这些语法时表现挣扎。作者对通过 Dwitter API 获取的 25,000 个 Dweets 数据集进行了持续预训练(CPT)。这一过程显著降低了模型的“惊奇度”(assigned to a token 的负对数概率),并将未见 Dweets 的困惑度从 28.63 降低到 8.57。这表明模型已成功内化了 Dwitter 生态系统的特定惯用语和结构。
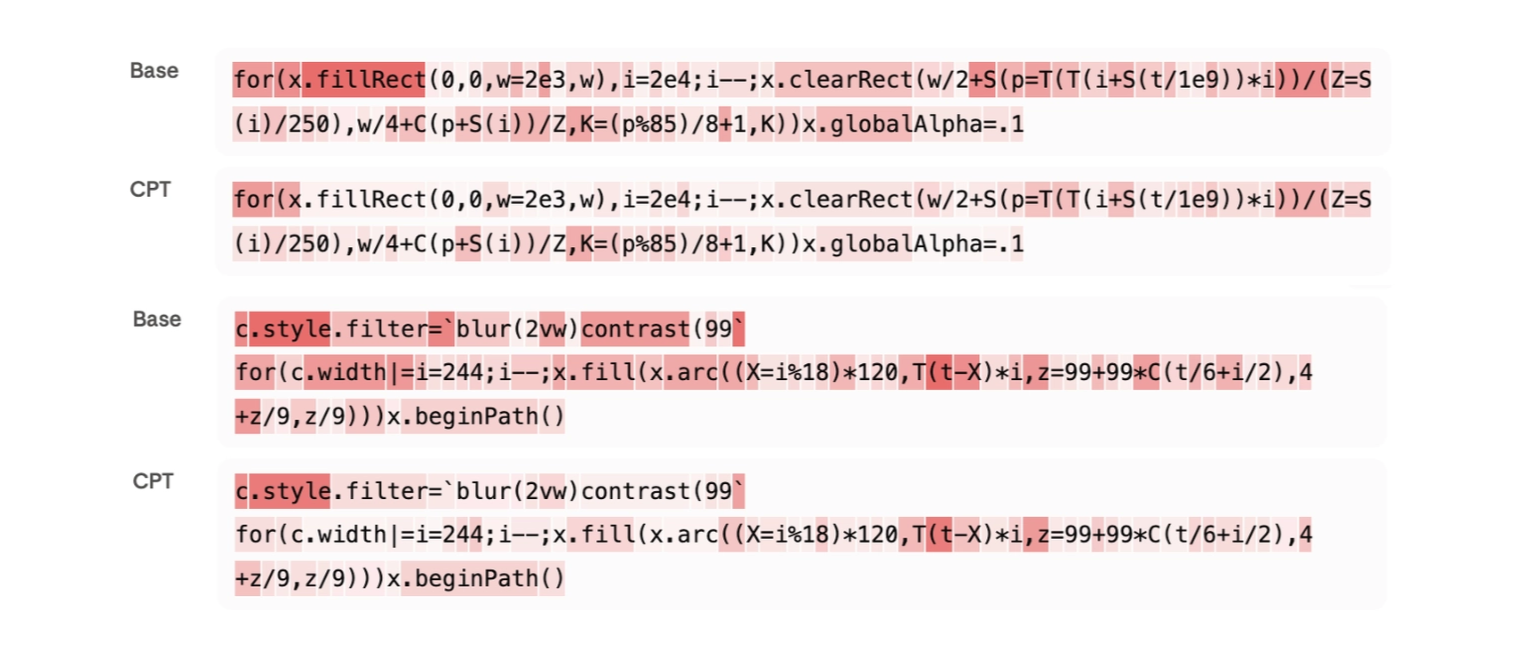
此图展示了通过在 Dweets 数据集上进行持续预训练所实现的困惑度和惊奇度的显著降低。
为了从单纯的语法正确转向美学质量,作者实施了课程训练策略。利用 Dwitter 内部的“惊艳度”评分,训练过程逐步增加高排名程序的权重,最终使排名前 1,000 的最受欢迎 Dweets 占据了约 67% 的采样概率。随后,作者使用 GRPO 算法进行了基于人类反馈的强化学习(RLHF)。作者充当奖励函数,手动检查并对约 40,000 个动画进行排序,以优化模型的策略。最终结果是一个允许用户从单个代码前缀生成多个视觉延续的工具,提供了一种在 Demoscene 空间中分支探索不同艺术方向的方法。
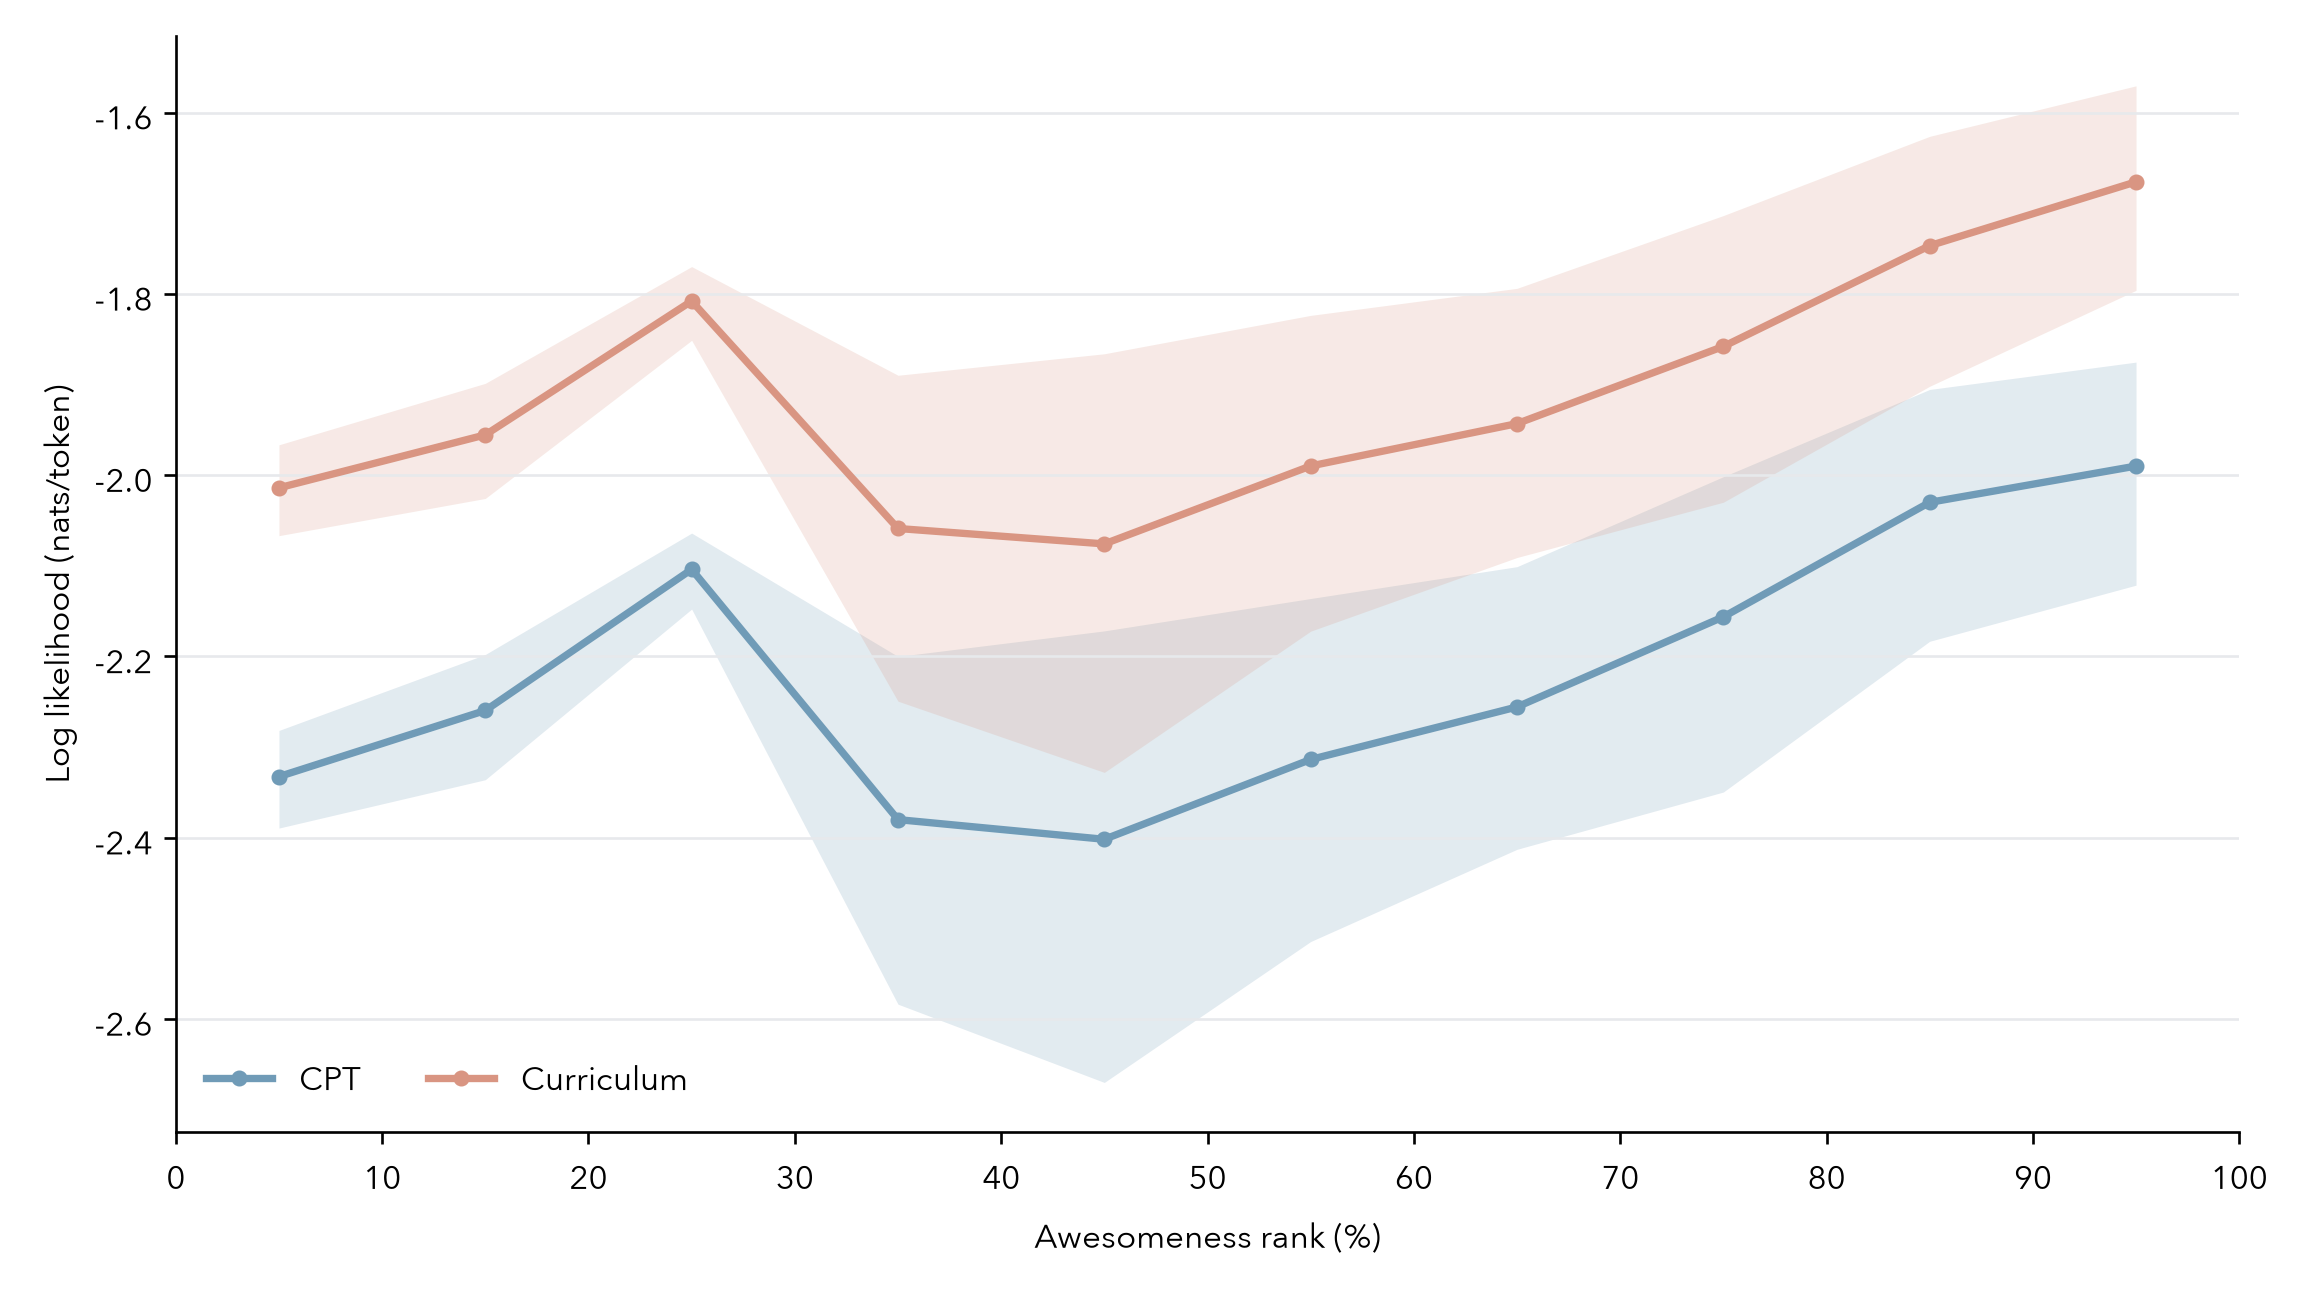
该图表可视化了训练策略如何影响模型在不同流行度层级生成高质量代码的能力。
虽然模型成功提高了“优美”代码出现的可能性,但作者指出,这种提升分布在所有的惊艳度等级中,包括那些在课程阶段从未见过的等级。该项目突显了从纯功能性代码生成向美学驱动合成的转变,模型在创作过程中充当协作伙伴。作者已在 HuggingFace 上发布了“Demoscener-7B”模型及相关数据集供进一步探索。
这种方法的一个局限性是奖励函数的主观性。虽然作者通过 RLHF 将个人审美注入到模型中,但第三方进行的盲选偏好测试确认了模型的输出是令人满意的,但“正确”的美学仍是一个变动的目标。此外,模型对 Dwitter JavaScript 环境特定特性的依赖意味着其创意输出目前仍受限于该特定平台的约束和能力。
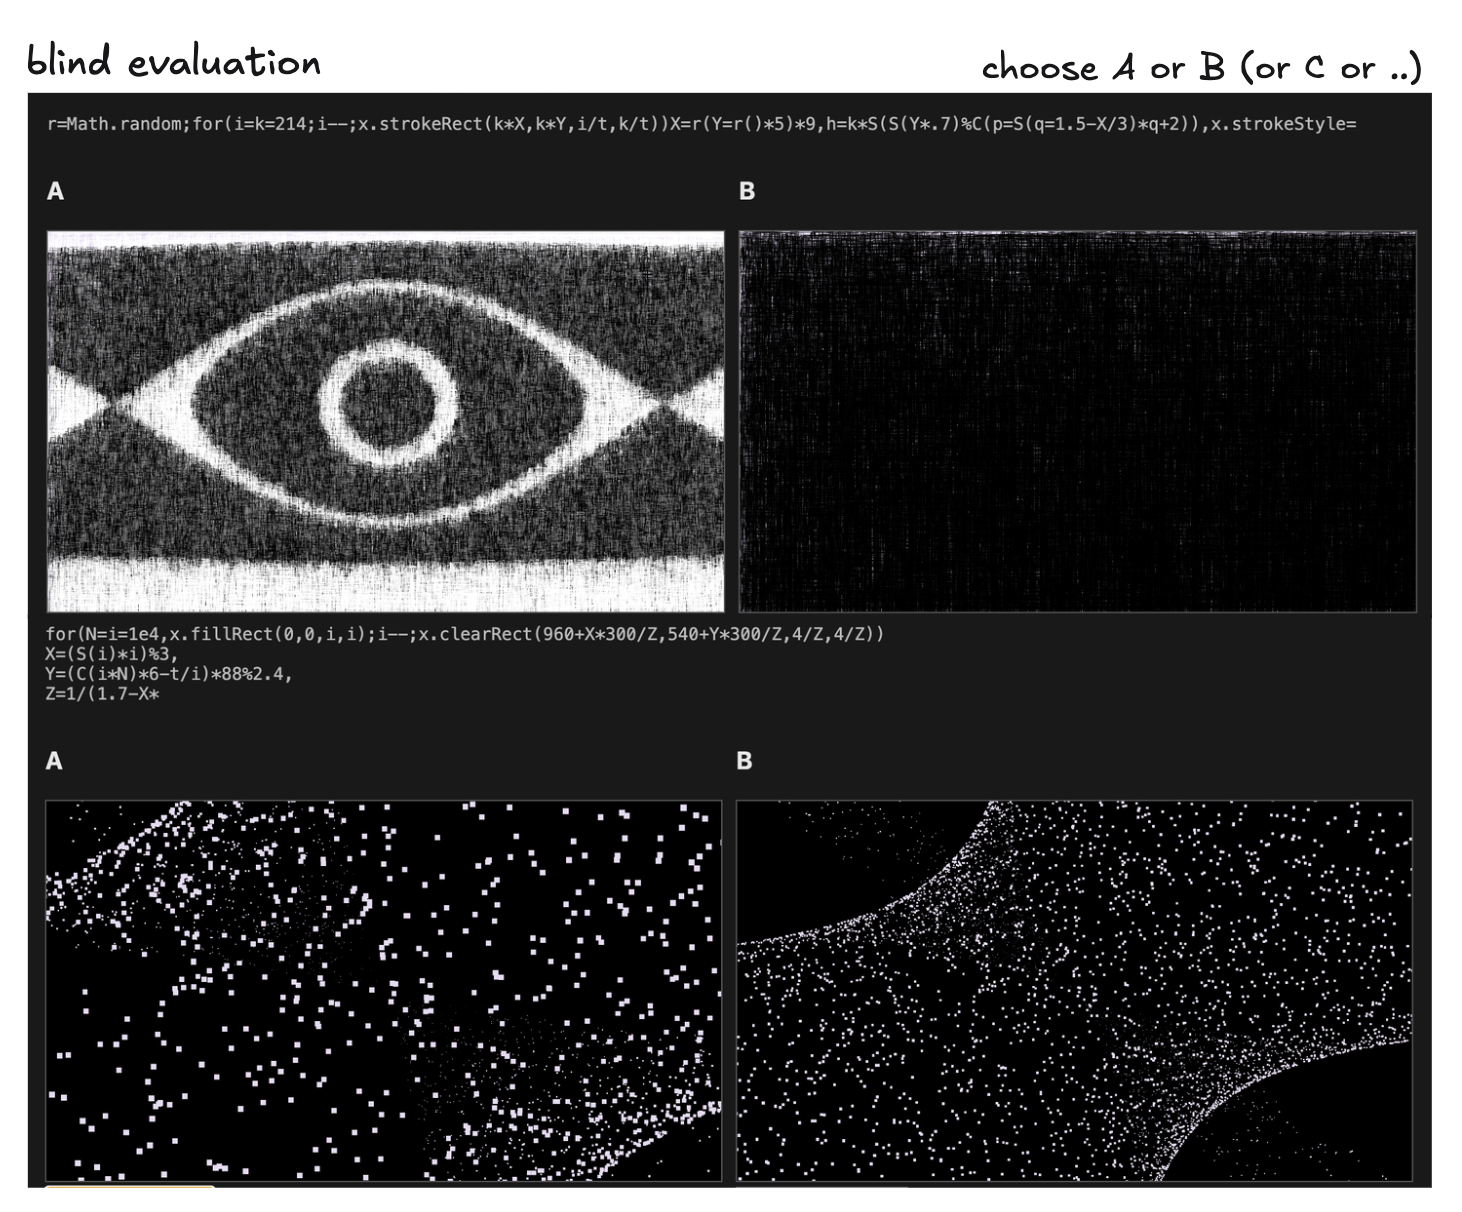
此图表提供了证据,证明人类参与的反馈和课程训练成功地将模型引导向更受青睐的美学。
最终,该项目展示了专门的数据集和人类参与的反馈如何引导大语言模型走向细分且高度受限的创意领域。通过将代码视为一种生产性语言,作者将一项技术挑战——完成复杂的、经过高尔夫处理的演示——转化为一个探索过程,其中 AI 建议下一个可能的视觉分支,允许人类创作者对最终输出进行策划和完善。