Figma 正在将其 AI 策略转向专门的后期训练,以应对迭代设计工作的细微差别。虽然前沿模型能够处理广泛的任务,但它们往往难以处理设计师每天执行的微小、非验证式编辑——例如调整按钮间距、更改特定颜色或根据反馈重做布局。为了解决这个问题,Figma 开发了一个设计智能体,该智能体使用专门针对 Figma 内部语法和设计系统资产进行训练的一方编辑模型。这使得智能体能够在画布上直接执行精确的迭代,在这些场景中,速度和准确性对于维持设计师的工作流至关重要。
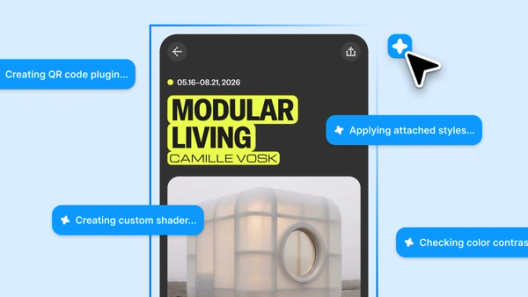
这张图片展示了设计智能体直接在画布上执行精确迭代的能力,例如调整间距和颜色。
这一方法的技术核心涉及使用 Figma 原生文件格式进行的监督微调 (SFT)。通过以原生结构表示设计,模型学会生成可以直接应用于画布的更改。Figma 构建了一个“自我修复”生成流水线,其中较大的“教师”模型尝试进行编辑,然后由确定性验证器和视觉模型裁判进行检查。如果编辑未能通过检查——例如导致文本重叠或图标裁剪——流水线将利用评估器反馈来修正输出。这种方法使早期基于超过 250,000 个示例训练的 Llama 3.3 70B 模型,在特定的编辑任务上能够与顶级模型相媲美。
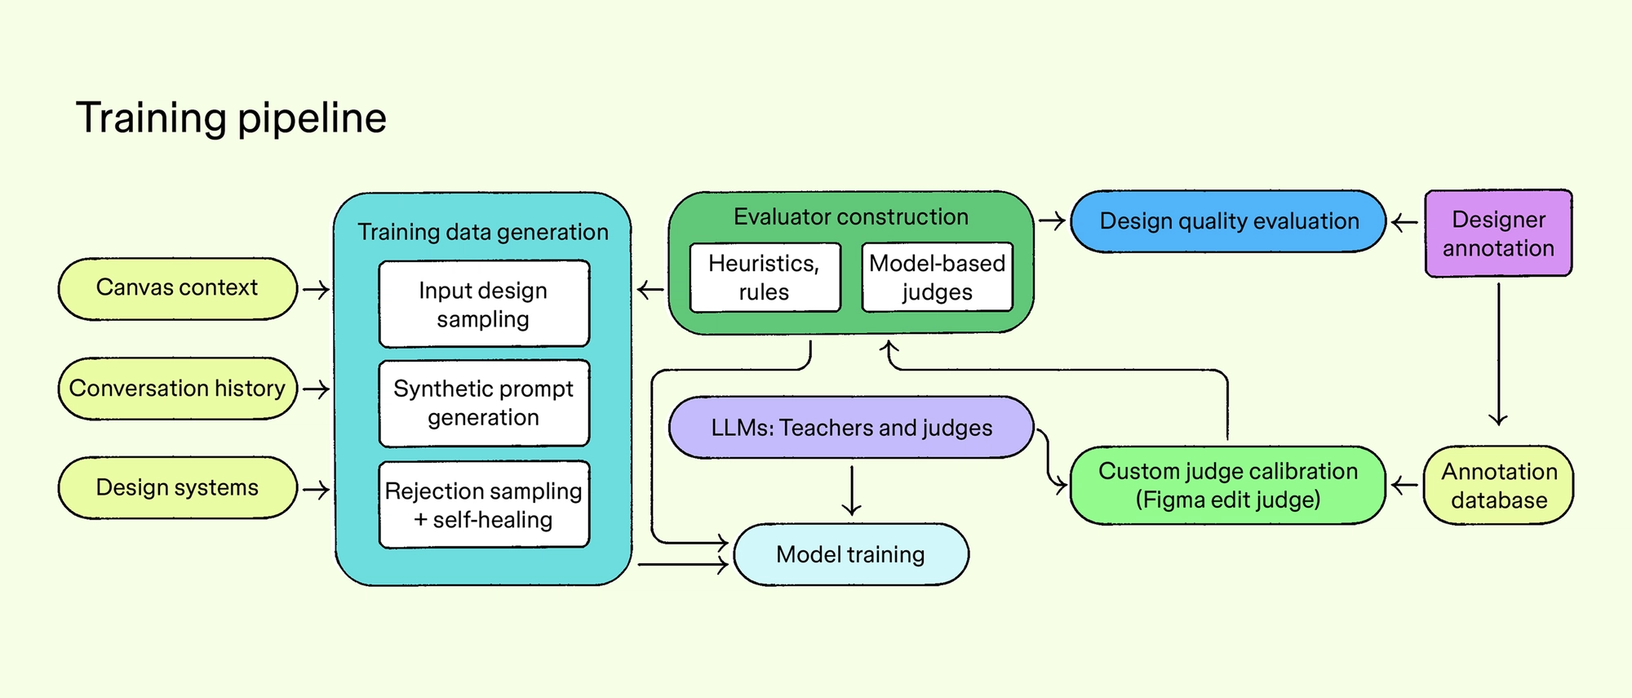
此图表解释了该方法的技术核心,包括自我修复生成流水线和评估器的构建。
然而,Figma 指出,仅靠 SFT 存在局限性,特别是关于“模仿学习”的问题,这可能导致模型过于紧密地模仿训练数据而牺牲泛化能力。为了应对这一问题,公司正在将其训练方案中整合强化学习 (RL)。这一转变侧重于提高训练示例的多样性,并根据反映实际设计师优先级的专家编写标准来塑造奖励模型。早期结果表明这种专门的方法是有效的:在面对面测试中,新智能体在 62% 的情况下达到或超过了之前的生产版本,同时降低了每条消息的平均成本,并将典型任务速度提高了约 20%。
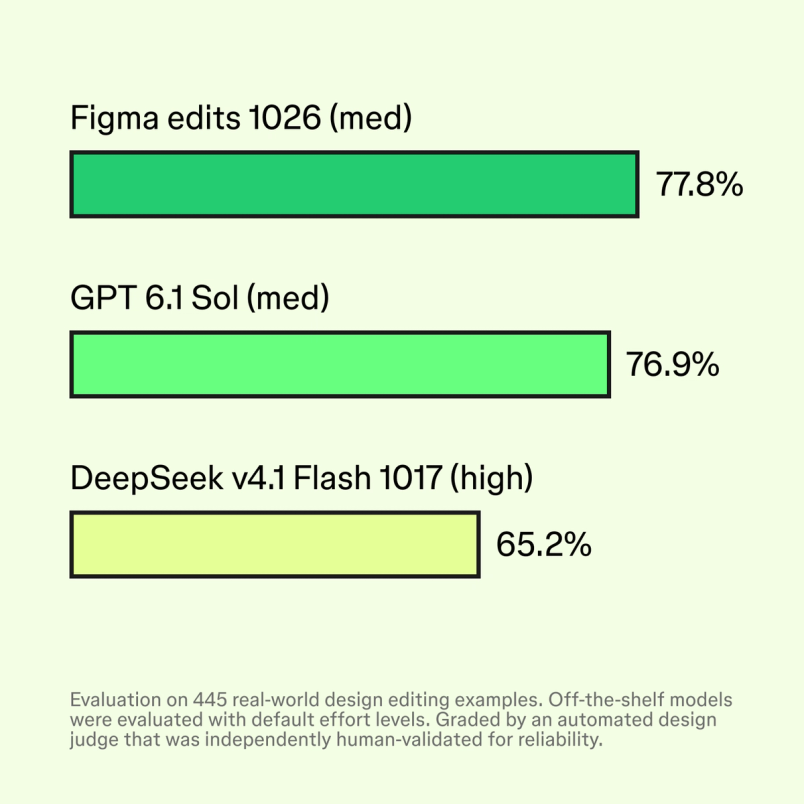
此图表支持了新智能体在面对面测试中达到或超过之前生产版本的说法。