许多软件系统依赖于将字符串映射到特定值,例如识别 HTTP 方法(GET、POST)、识别标头名称或解析编译器关键字。在 C++ 中,标准做法通常是使用 `std::unordered_map`。然而,由于键通常在编译时已知,这种方法会产生运行时成本。标准哈希表必须通过对整个字符串进行哈希、选择桶,并可能遍历链表来处理潜在的冲突,而如果键集是静态的,所有这些开销都是可以避免的。
为了解决这个问题,该库利用了完全哈希函数——这是一种专门为固定键集设计的函数,旨在确保没有任何两个键映射到同一个槽位。该机制遵循类似于 `gperf` 工具的设计:它通过将键的长度加上由特定位置字符索引的关联表中的小值来计算槽位。此过程在编译时使用 `constexpr` 函数执行,确保运行时成本极低。例如,查找一个键涉及几次加载和一次按位与运算来确定槽位,随后是单次比较。这消除了探测或遍历冲突链的必要性。
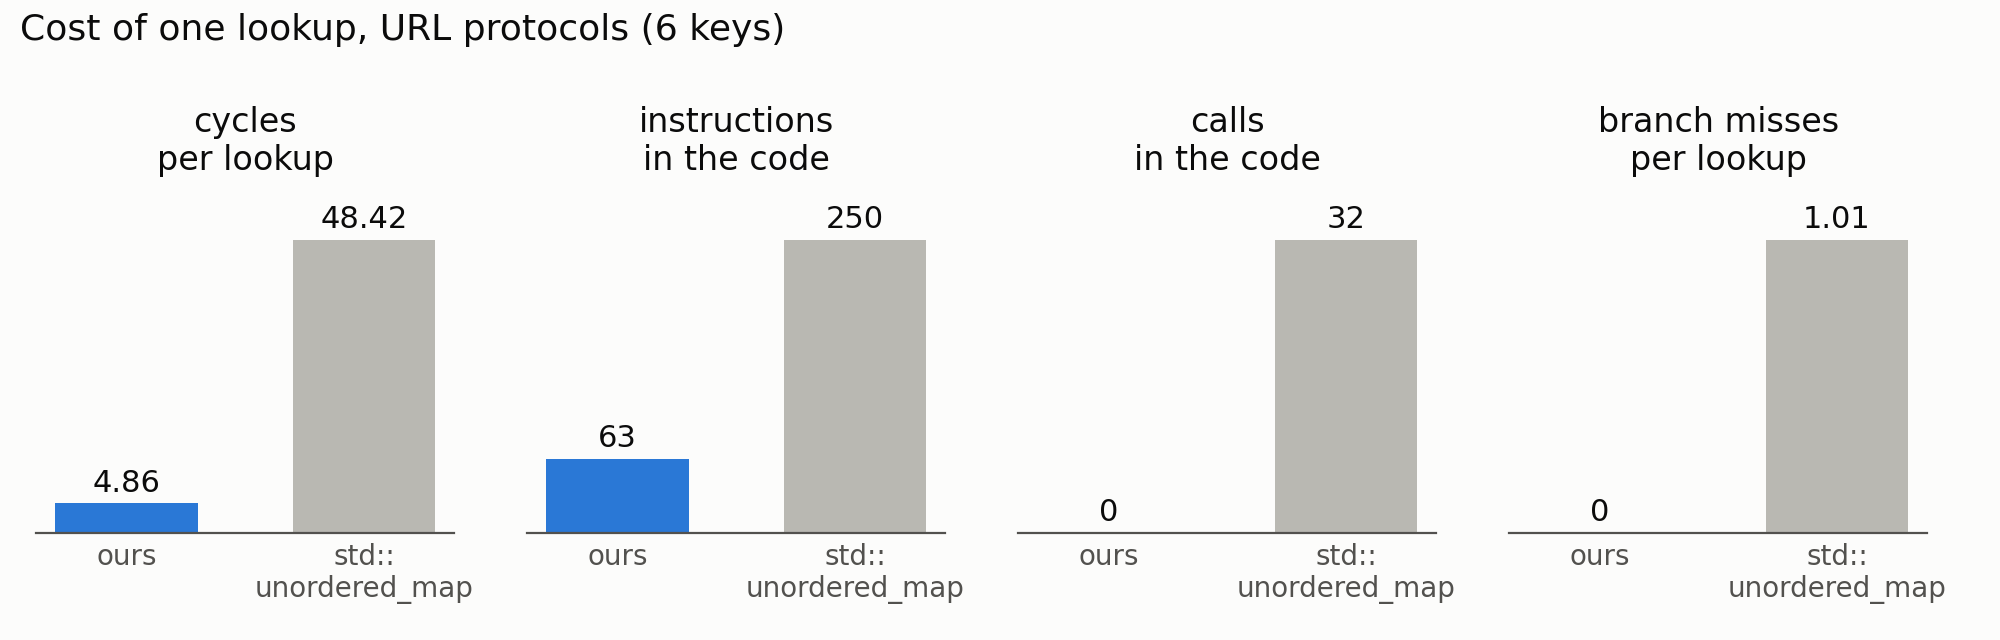
该视觉图表解释了查找过程极低的运行时成本,该过程仅涉及几次加载和一次按位运算。
除了哈希之外,该库还利用 SIMD(单指令多数据)指令优化字符串比较。系统不再通过带有多个分支的循环遍历字节,而是将键加载到 16 字节寄存器中,并使用洗牌指令(如 ARM NEON 上的 `tbl`)将键末尾之后的字节清零。这使得单次向量比较仅需几条指令即可验证整个键。在 Apple M3 Max 上的基准测试显示,该库在查找 HTTP 标头时每秒查询耗时约为 1.3 ns,比 `std::unordered_map` 快多达 13 倍。虽然这种方法对于已知键非常高效,但不太适用于键在运行时动态添加或删除的集合,因为任何键集的更改都必须重新计算完全哈希函数。
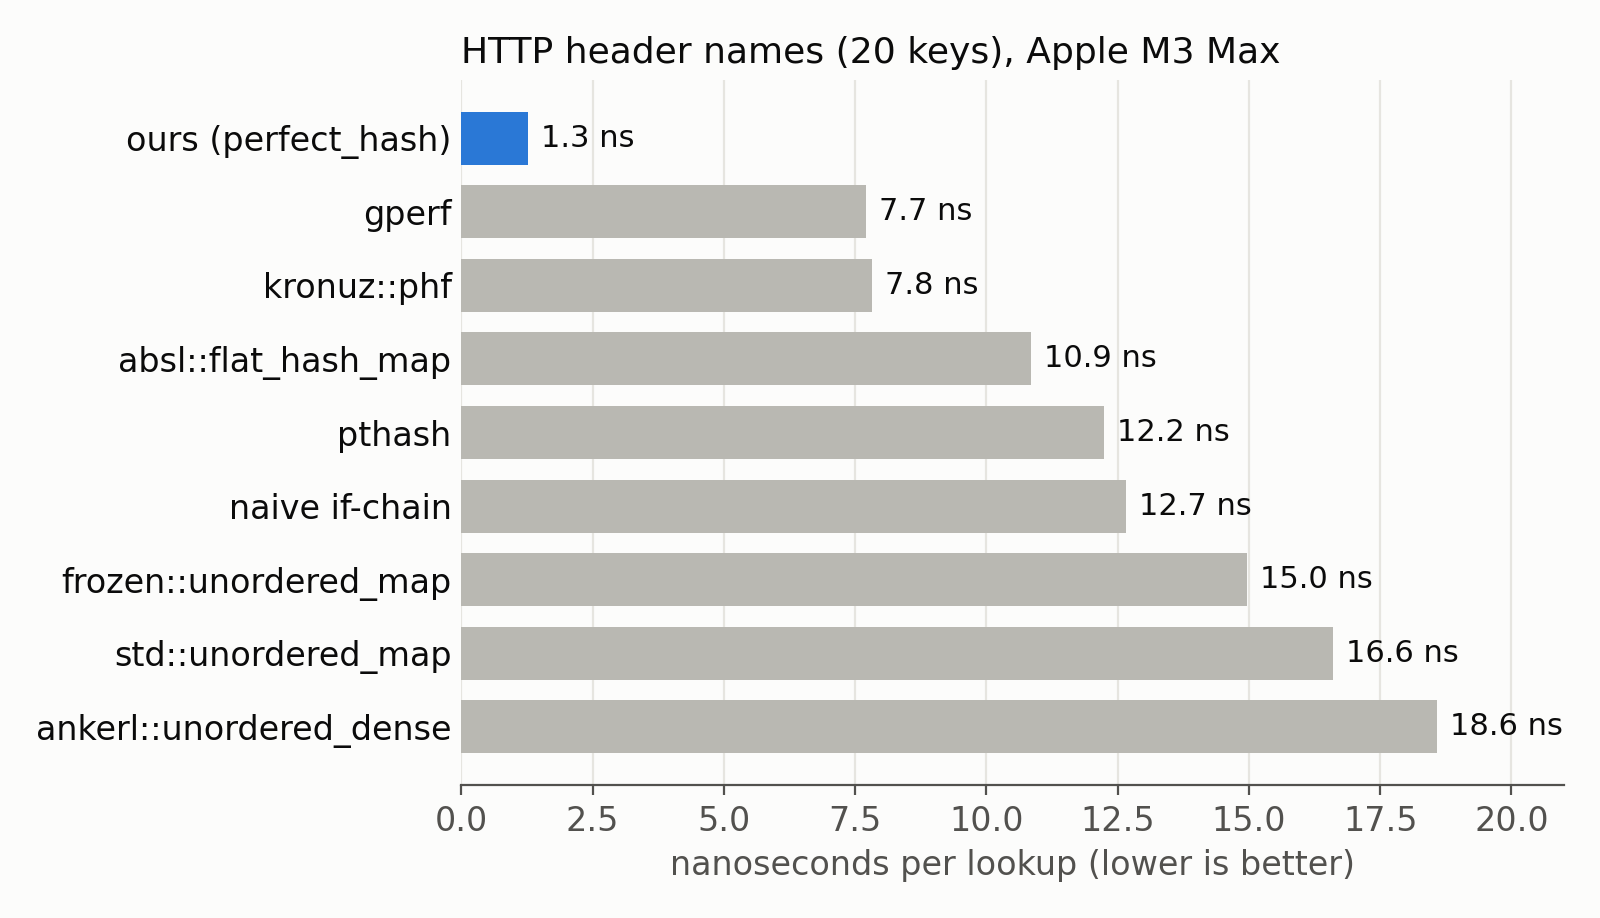
该图表展示了完全哈希库在处理常见 HTTP 标头时相比标准实现的显著速度优势。
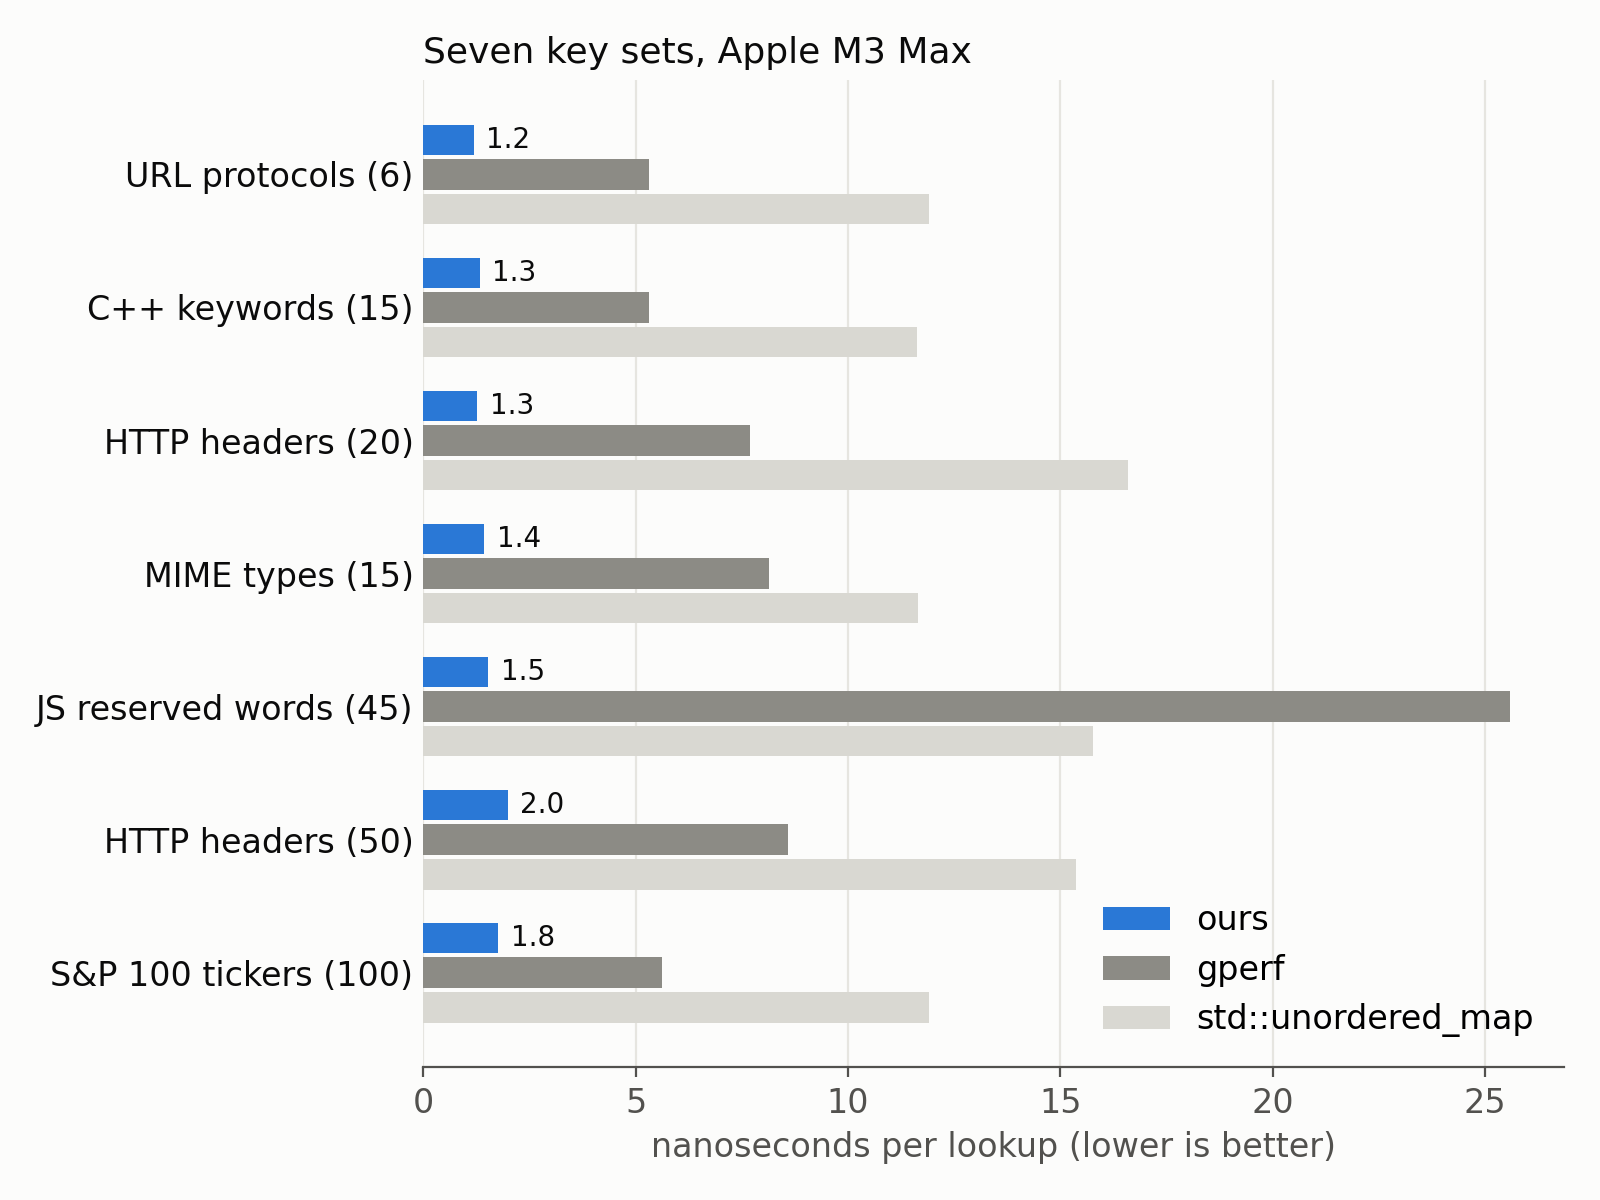
此图展示了该库在不同类型的静态键集上的效率,突显了其高速性能。