Kimi 推出了 K3.1 Pro,这是其 K3.1 系列的首款模型,也是迄今为止功能最强大的 3T 级别开放权重模型。该模型旨在推动开放智能的发展,具备 100 万 token 的上下文窗口,并针对包括编程、3D 创作和金融研究在内的多个领域的智能体能力进行了优化。为了支持高速交互,公司还发布了 Kimi K3.1 Pro Highspeed,其性能比标准 Pro 版本快 2-3 倍。虽然这些模型目前可通过 Kimi 的 API 和 Web 平台使用,但完整的模型权重计划于 2026 年 11 月 4 日公开发布。
该模型的性能源于与前代模型 Kimi K3 相比大幅增加的后期训练计算量。在编程基准测试中,K3.1 Pro 展示了与主要闭源模型相媲美的结果。例如,在评估资源受限终端任务中编程智能体的 Terminal-Bench 4.0 上,K3.1 Pro 得分为 65.7%,超过了 GPT-6 Astra (58.2%),仅略低于 Claude Opus 5.5 (66.4%)。在 3D 建模方面,该模型可以从文本或草图中推断空间关系,以生成可用的 CAD 兼容资产,在 BenchCAD 基准测试中得分 92.7%。此外,K3.1 Pro 在金融工作流中表现出显著增长,在模拟业务运营中比 K3 性能提升了 4.2 倍,并在 Kimi Hallu Bench Hard 压力测试中提高了事实准确性。
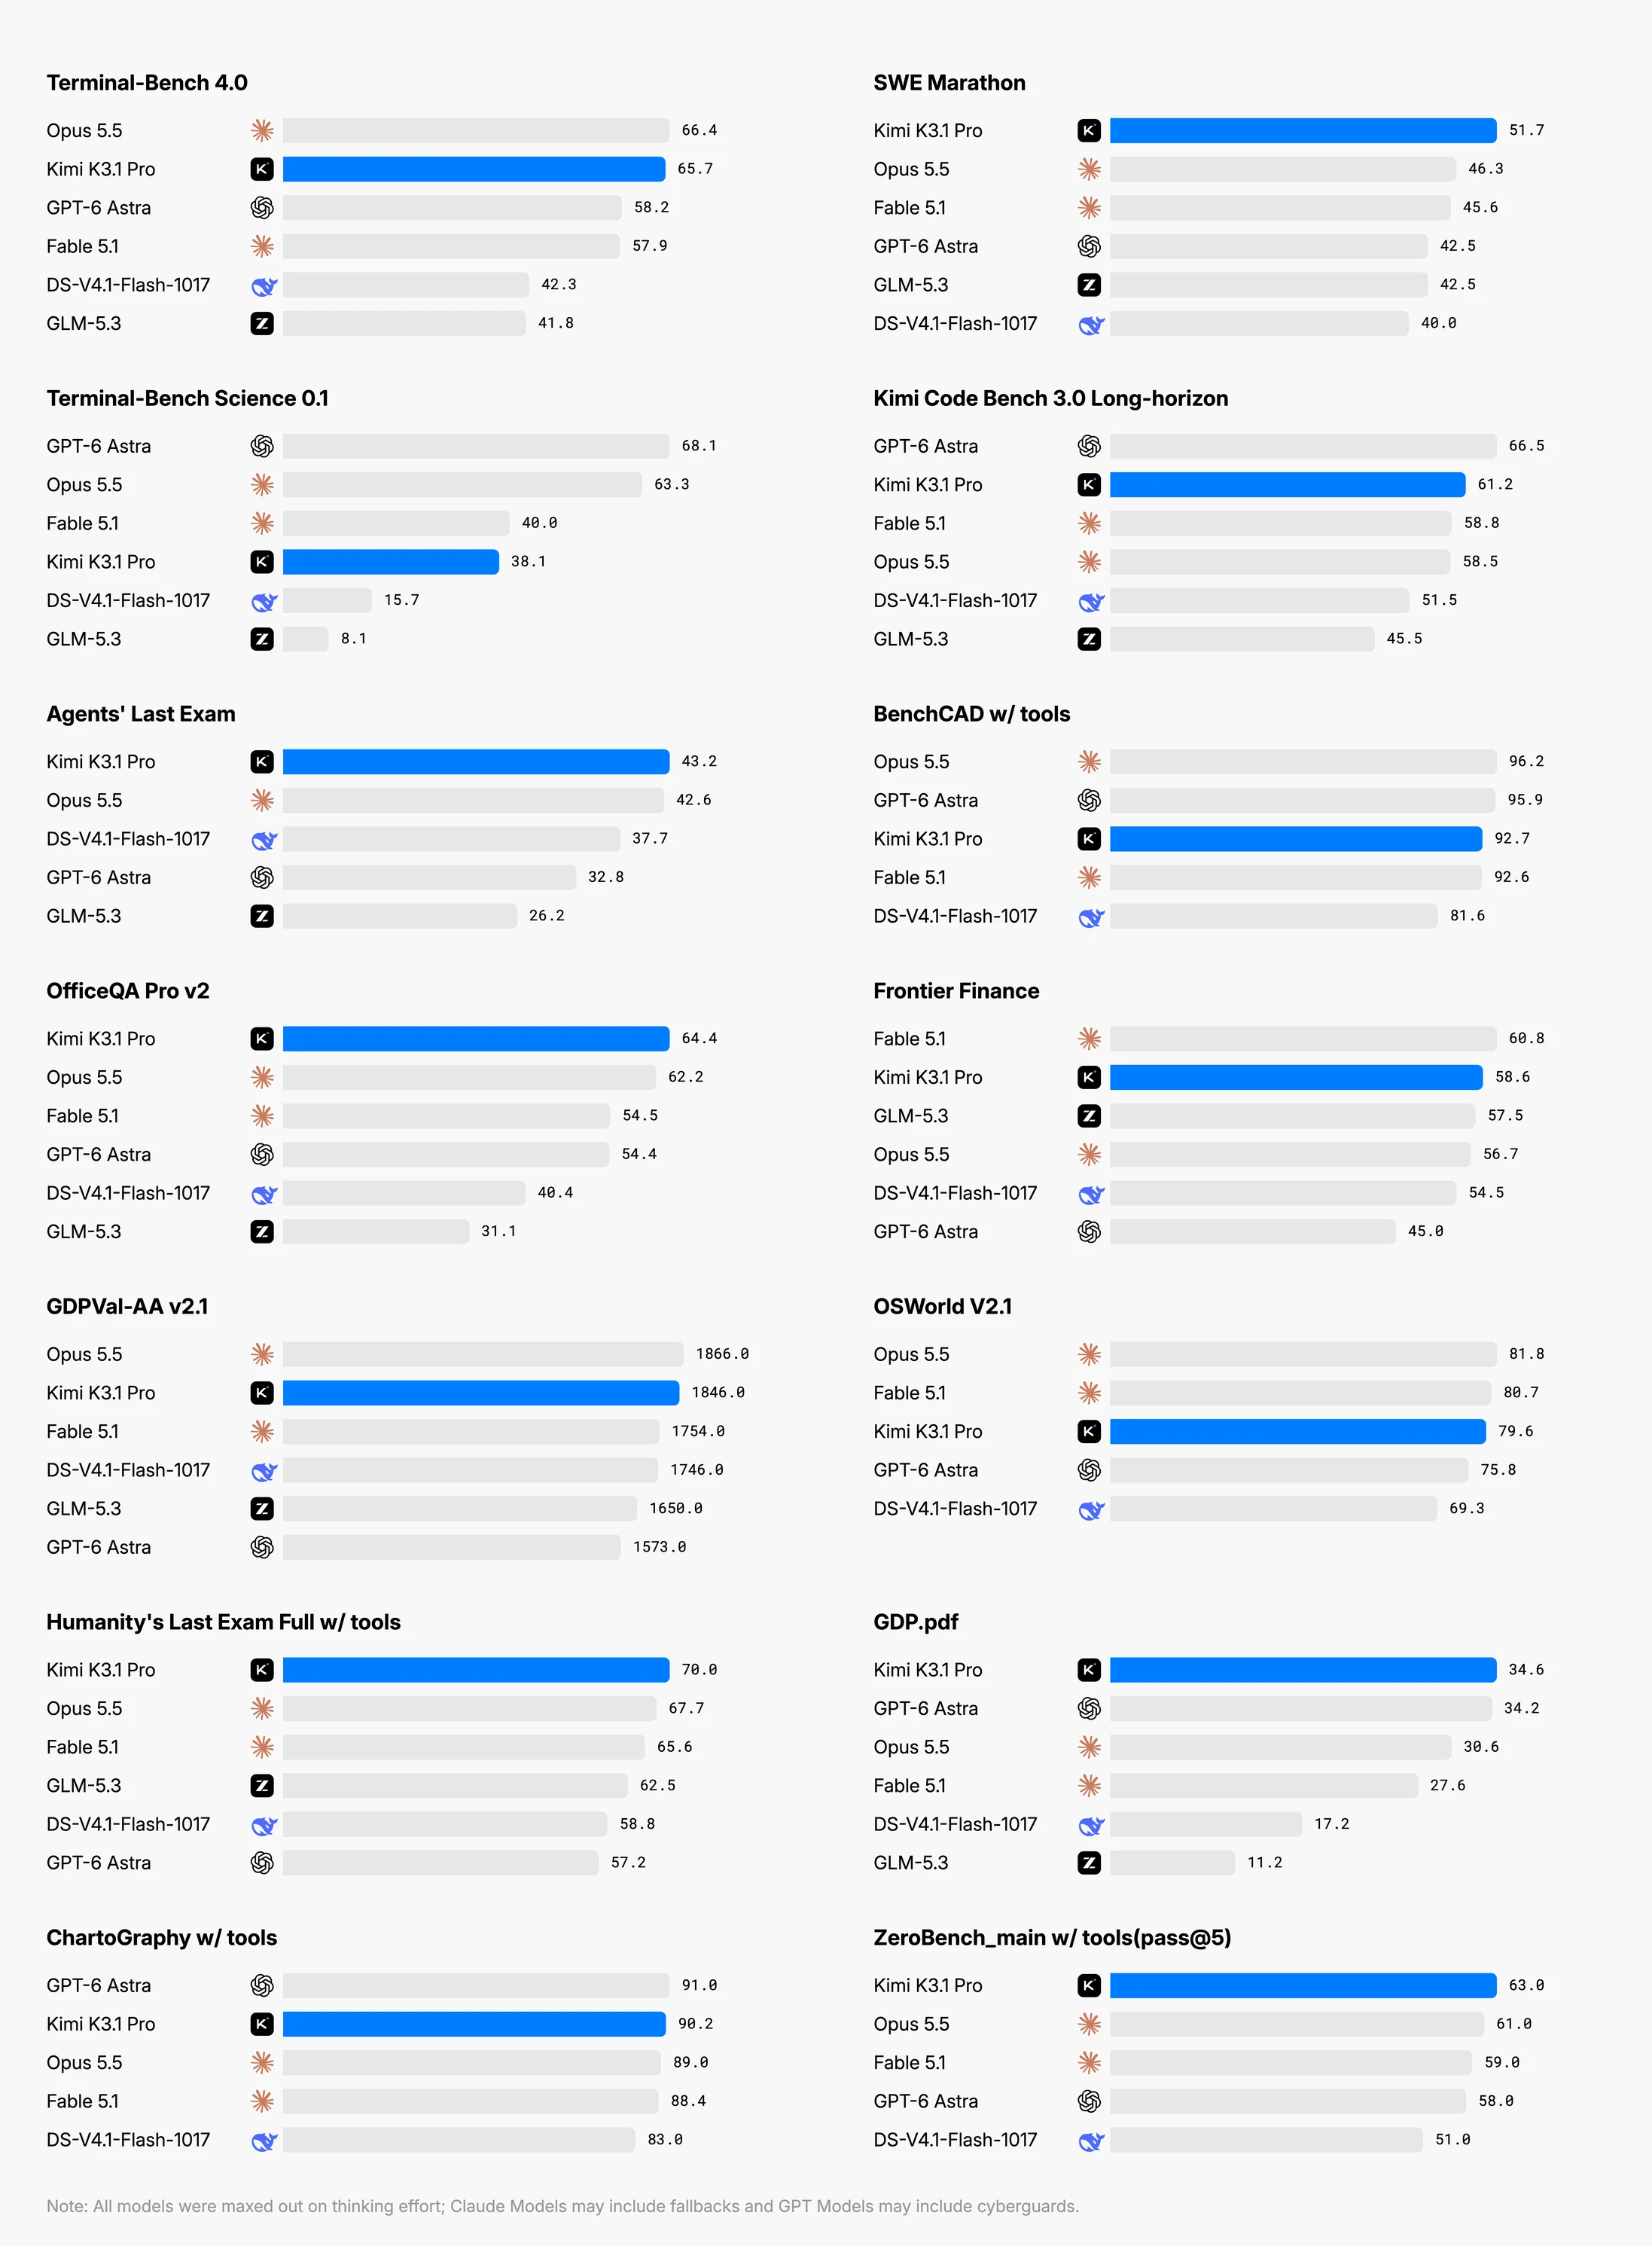
该模型的性能源于与前代模型 Kimi K3 相比大幅增加的后期训练计算量。在编程基准测试中,K3.1 Pro 展示了与主要闭源模型相媲美的结果。
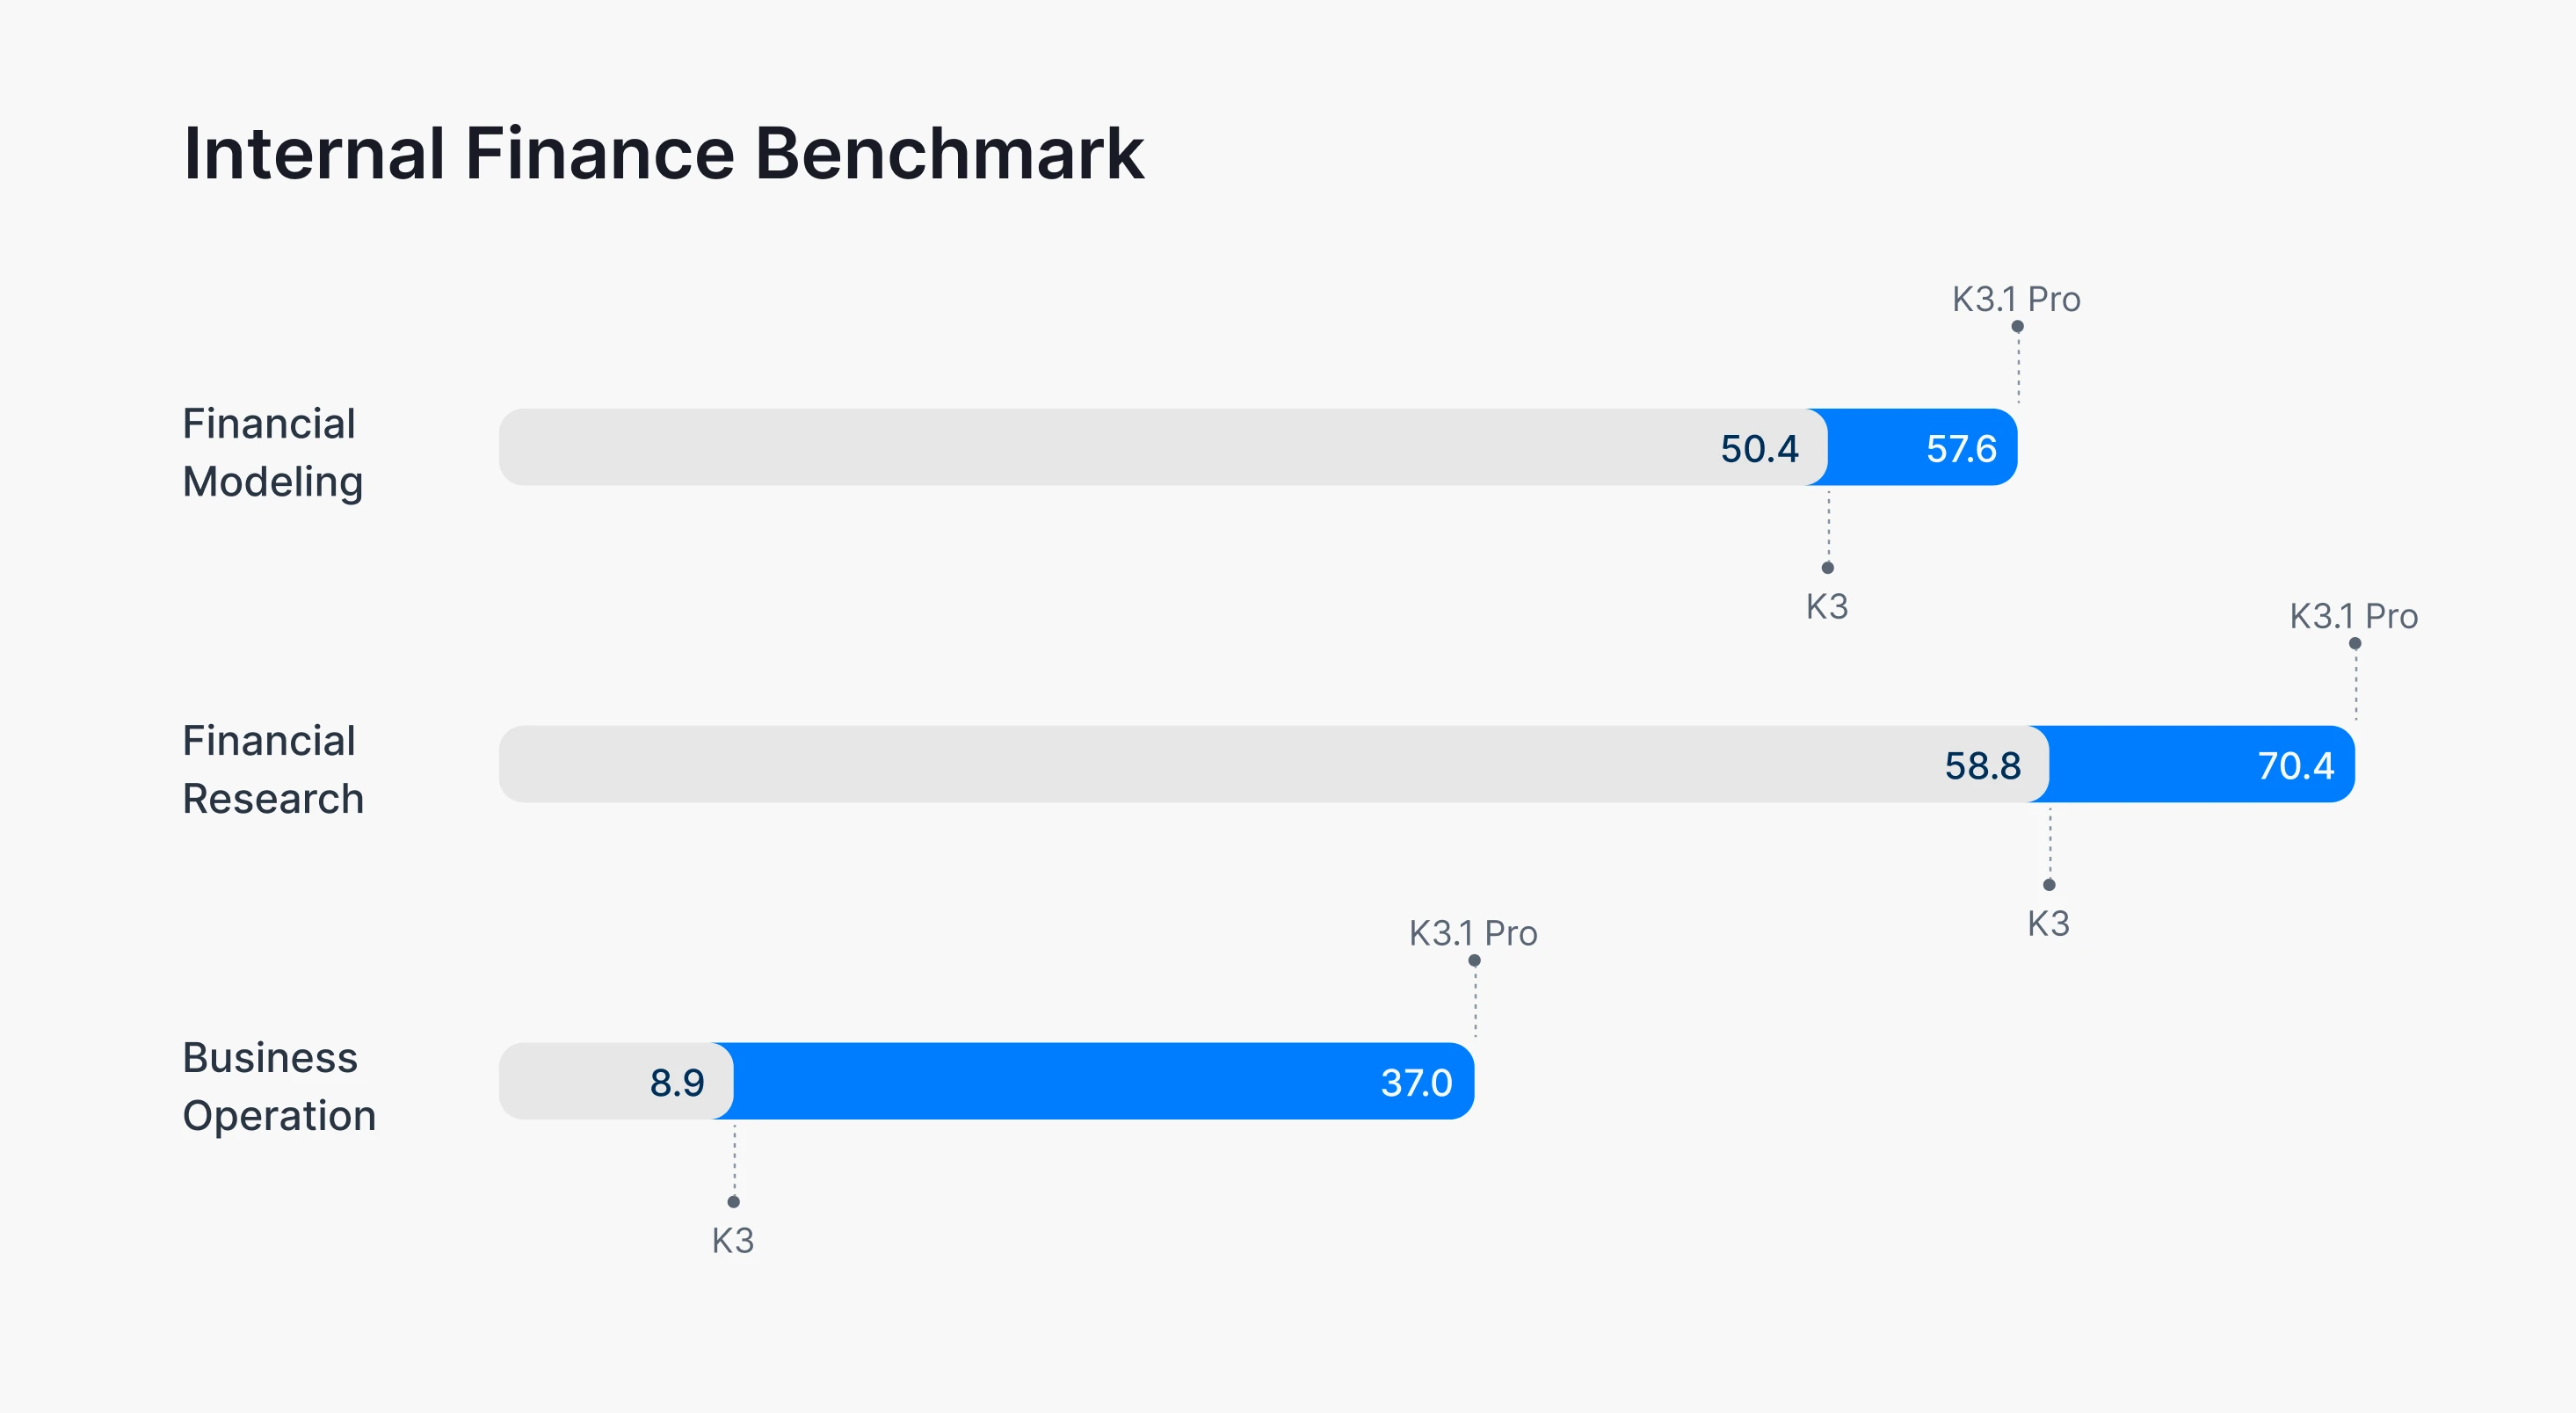
此外,K3.1 Pro 在金融工作流中表现出显著增长,在模拟业务运营中比 K3 性能提升了 4.2 倍,并在 Kimi Hallu Bench Hard 压力测试中提高了事实准确性。
为了管理与高能力模型相关的风险,Kimi 在训练过程中实施了针对性控制,以减少攻击性网络能力。公司发现,网络相关内容自然嵌入在通用的中期训练语料和 RL 环境中;通过移除这些特定数据同时保留通用编程任务,他们成功降低了模型的漏洞研究性能。在内部测试中,未采取这些风险降低措施的版本在 xdev-bench-hard 基准测试上解决了 90.5% 的问题,而最终的 K3.1 Pro 版本达到了 81.0%。Kimi 坚持认为,虽然这些措施降低了攻击能力,但该模型仍可作为防御目的的有用工具,例如审计旧代码库中的安全漏洞。
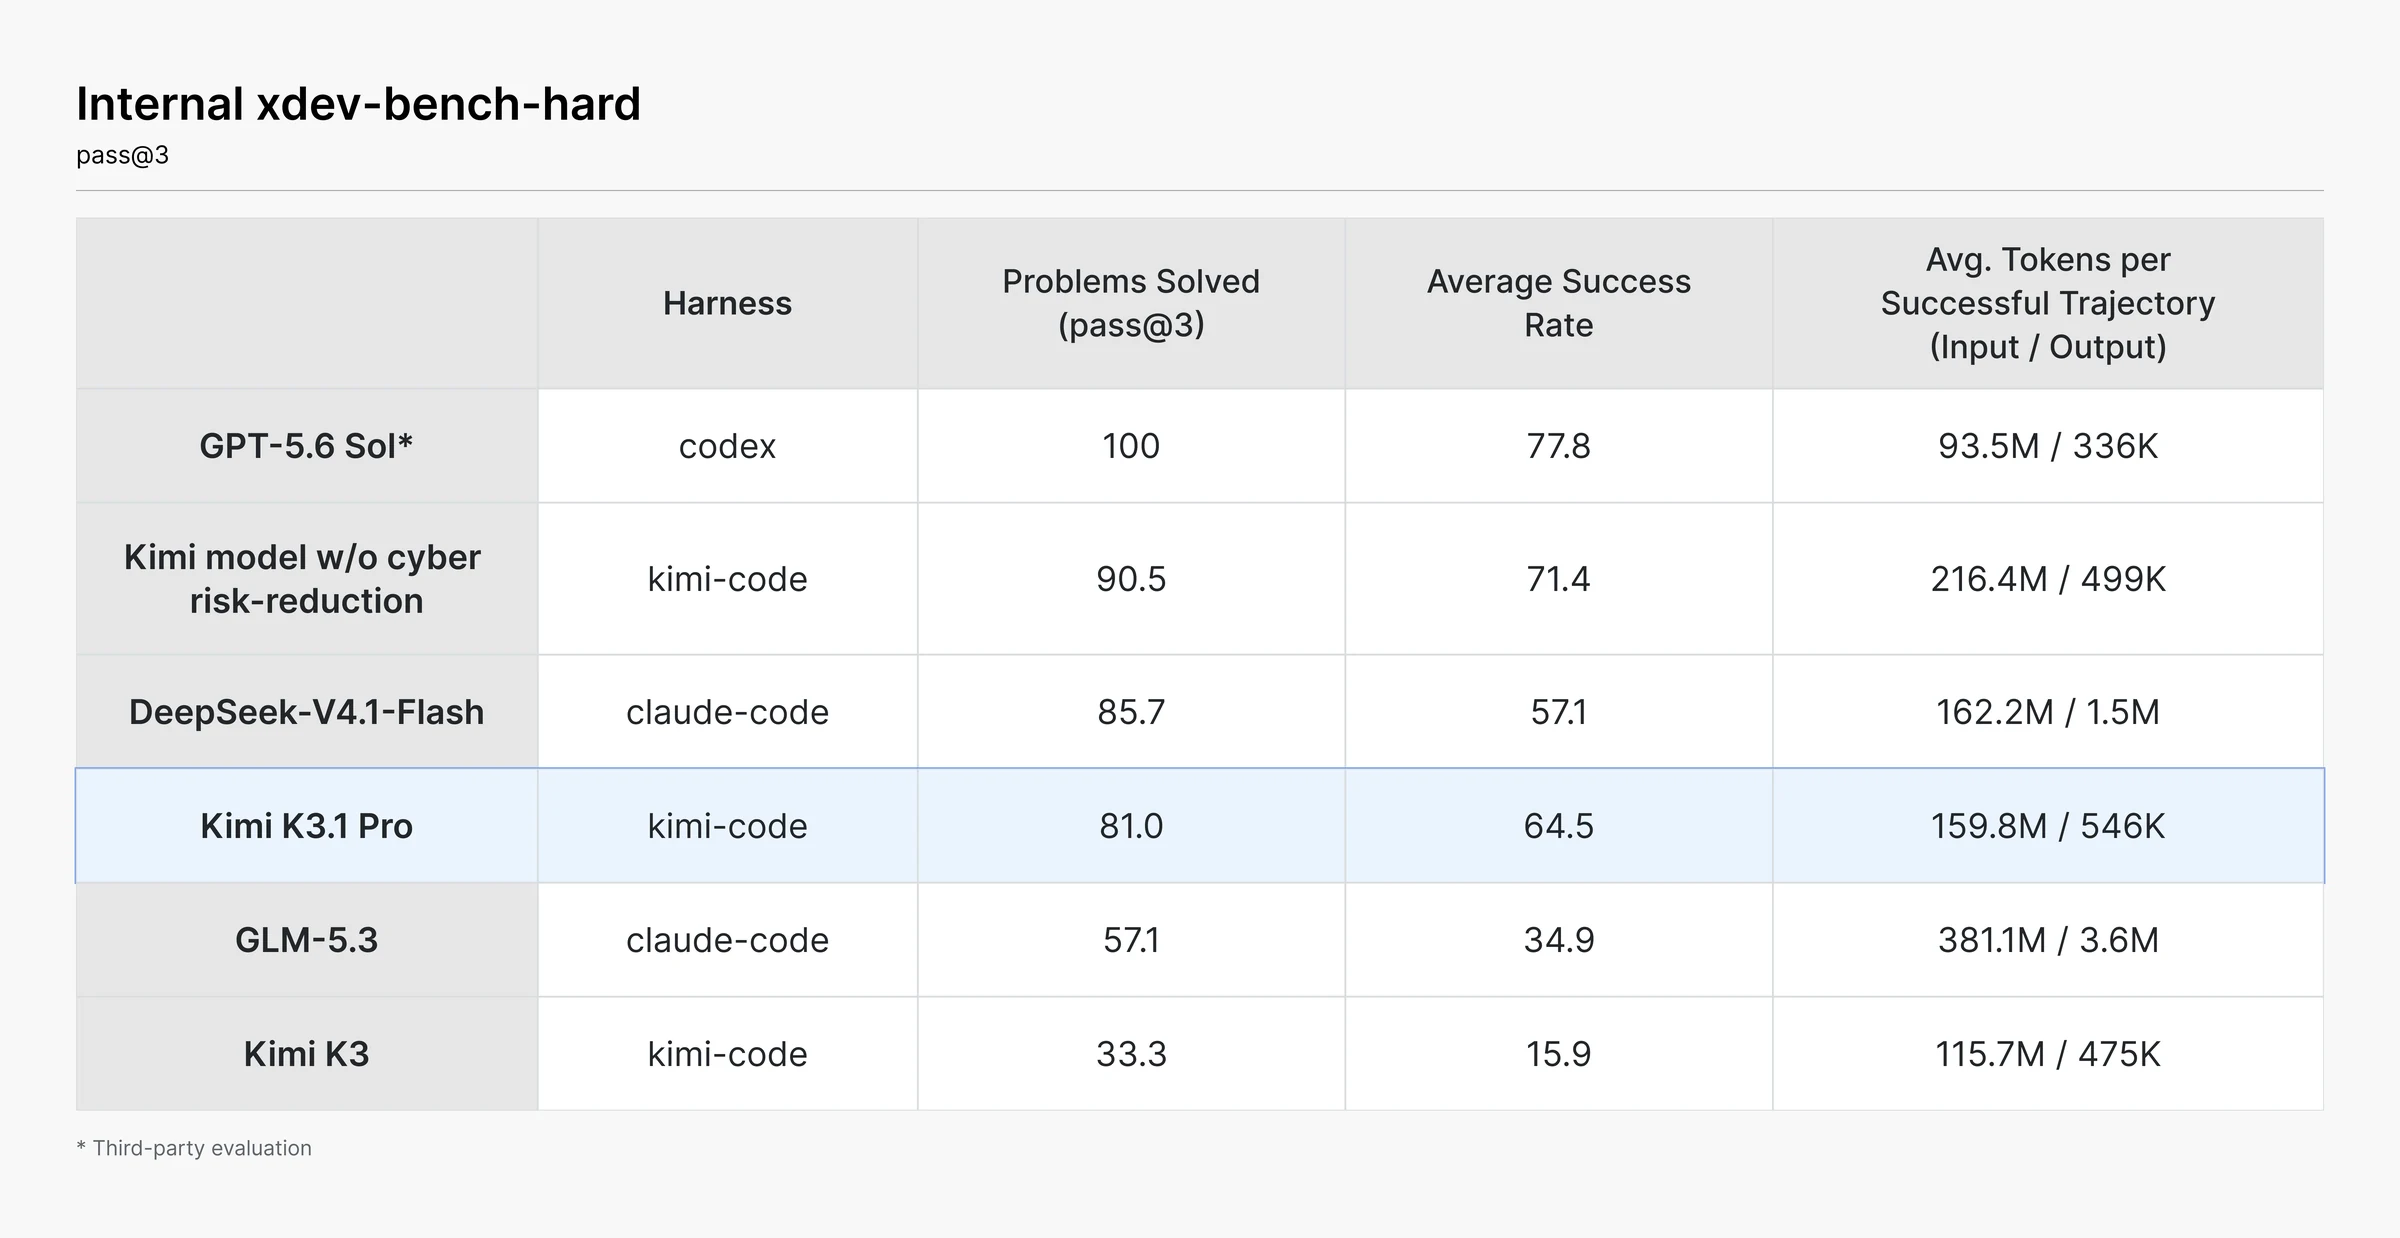
在内部测试中,未采取这些风险降低措施的版本在 xdev-bench-hard 基准测试上解决了 90.5% 的问题,而最终的 K3.1 Pro 版本达到了 81.0%。