AI 图像生成的领域已从早期的生成对抗网络 (GANs) 迅速演变为复杂的多模态系统。虽然早期模型在处理人体结构和可读文本等特定细节时表现挣扎,但现代迭代已基本解决了这些问题。例如,手部生成的困难往往是因为模型将手视为纹理而非结构组件来学习。同样,当模型能够访问单个字符而非仅基于单词的标记时,文本渲染得到了显著改善。如今,该领域的主要区别在于扩散模型(通常更快且更具可重复性)与多模态模型,后者通过在同一架构中处理语言和图像,提供卓越的指令遵循能力和原生文本渲染能力。
对于开发者和创作者来说,选择合适的工具取决于项目的具体要求。像 Flux 或 SDXL 这样的扩散模型通常更受青睐,因为它们适用于本地执行、批量处理,并通过“种子”(用于启动生成的初始随机噪声)提供一致的结果。相比之下,集成到 ChatGPT 或 Gemini 中的多模态模型在对话式编辑和复杂布局指令方面表现出色。然而,这些模型通常在控制特定输出尺寸或种子方面较弱。生产中的一个关键实践要点是,用户往往是在为“画布”付费,而非内容;同样尺寸的简单木桌和复杂的油画在生成积分或计算时间上的成本通常是相同的。
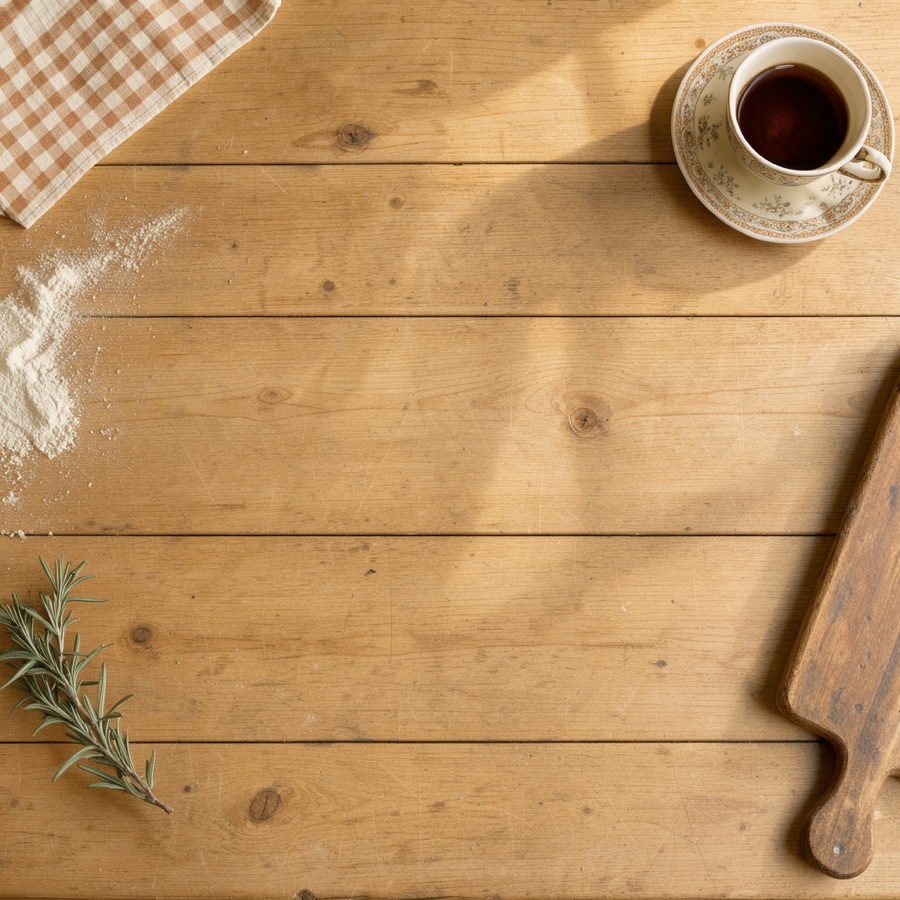
这张图片作为扩散模型输出的实际示例,展示了通过特定种子和模型选择可以实现的一致结果。
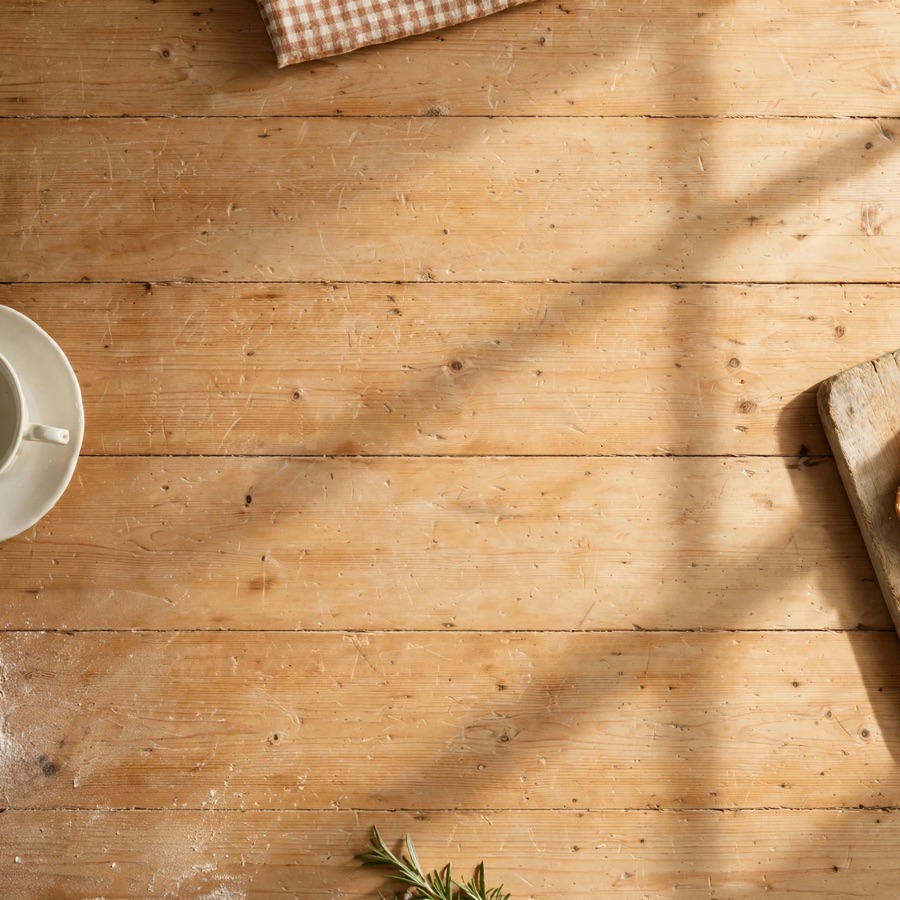
这张图片与 FLUX 模型进行了直接对比,展示了多模态模型如何解释相同的厨房桌子提示词。
将图像生成集成到生产代码中,需要开发者转变处理失败和一致性的方式。由于图像生成是一项“缓慢且可能失败的任务”,最好将其作为异步任务来处理。鼓励开发者在各种提供商前端使用薄接口,以应对 API 的快速变动,因为模型经常被退役或更新。对于 UI 设计或特定布局等高精度任务,混合方法通常最有效:使用 AI 进行资产的创意生成,同时使用传统代码处理尺寸、透明度和调色板应用等精确要求。这确保了 AI 的“审美”与标准软件工程的精确性达到平衡。
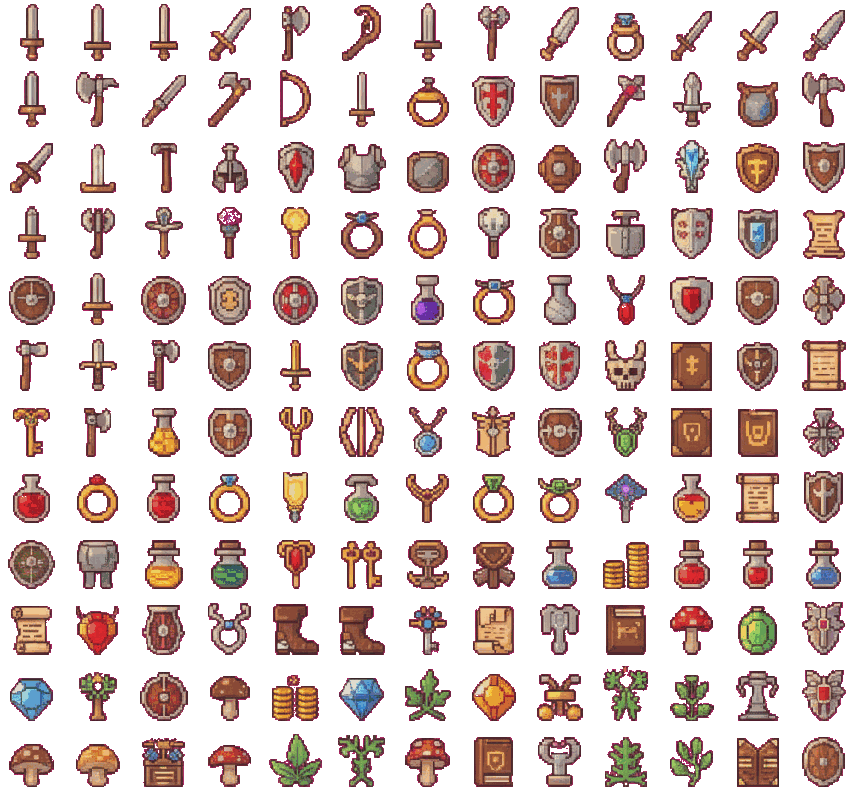
这张图片展示了混合方法:使用 AI 进行创意生成,同时使用传统代码进行精确的尺寸和透明度处理。
一种针对标准生成模型的新兴替代方案,特别是针对像素艺术等风格,是过程图形 (procedural graphics)。这种方法不是生成完整的位图,而是利用 LLM 生成一系列简单的绘图指令来重构场景。这种方法可以规避常见的生成问题,如网格错位、不一致的调色板选择和高频噪声,为在不具备纯扩散模型不可预测性的情况下实现特定美学目标提供了一条不同的路径。
这张图片展示了像素艺术的特定美学,文章将其作为过程图形优于标准生成模型的应用案例进行讨论。
成本和可访问性在整个生态系统中也存在显著差异。基于 API 的生成价格根据模型和提供商的不同,可能从几分钱到每张图像超过 15 美分不等。虽然本地执行可以消除这些成本,但它需要显著的硬件支持,例如对于 Stable Diffusion 等模型,至少需要 7GB 显存的 GPU。最终,最有效的流水线是将 AI 的创意优势与传统代码的确定性可靠性相结合,以产出精美且可用的结果。