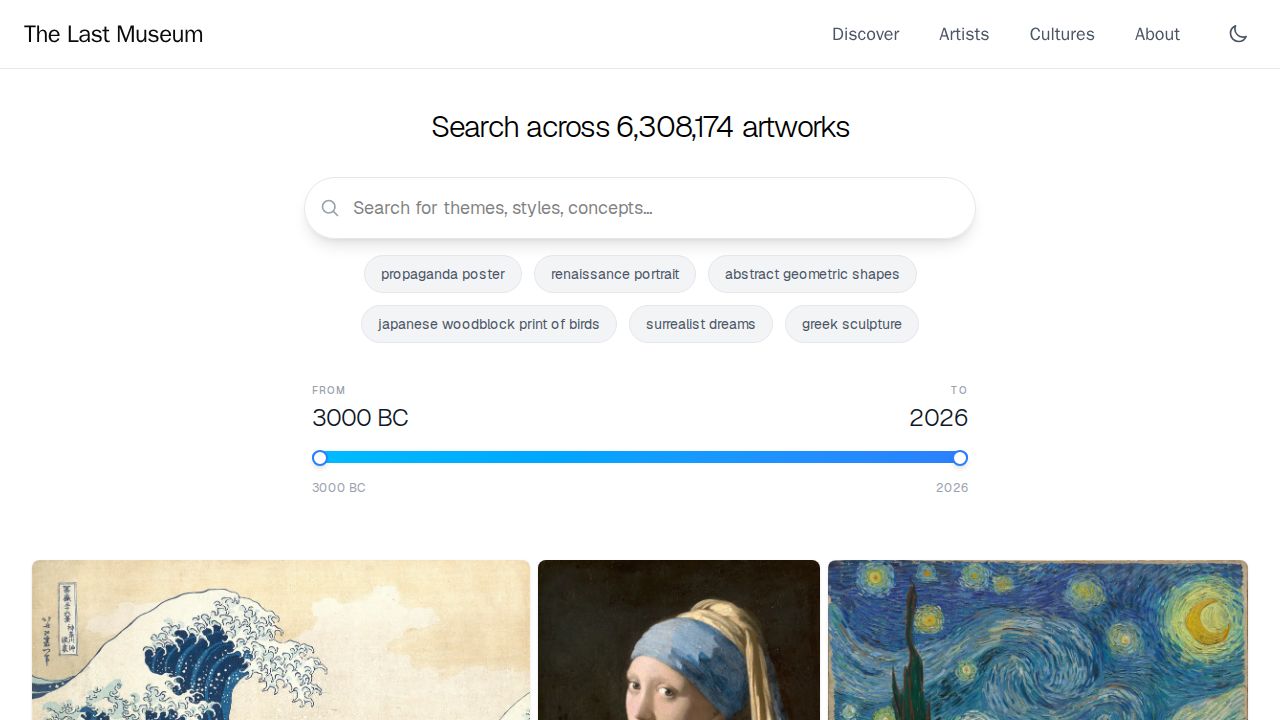
The Last Museum 是一个旨在促进对源自各大博物馆的超过 580 万件艺术品庞大仓库进行语义搜索的项目。与依赖特定元数据或关键词匹配的传统博物馆数据库不同,该平台利用人工智能来理解查询的概念背景。这允许用户根据主题、风格或抽象描述来发现艺术作品,有效地为人类集体艺术产出创建了一个可搜索的索引。
围绕该项目的技术讨论强调了使用嵌入模型(如 Gemma 系列中的模型)来处理和索引这些作品。这些模型将信息转换为高维向量,使系统能够根据概念空间中的接近程度识别“相似”项目。然而,用户也指出这种方法存在实际挑战。例如,一些针对特定历史人物或主题的查询返回了美学相似但上下文错误的搜索结果,这表明当前的嵌入模型可能难以完美捕捉艺术意图的细微差别。
虽然该项目提供了一种与艺术史互动的新颖方式,但在数据质量和用户体验方面面临障碍。评论者指出,博物馆元数据往往不一致——从详细描述到简短的标签如“陶罐,陶土”不等——这可能会影响底层嵌入的准确性。此外,如果没有强大的过滤系统,庞大的结果数量可能会增加导航难度。关于此类工具的作用也存在持续争论:一些人认为它们是增强人类创造力的手段,因为它们让艺术更易于获取;而另一些人则认为数字索引无法取代实体博物馆展览中经过策划和诠释的体验。
此外,该项目的范围涉及导航复杂的版权格局。用户建议增加公共领域过滤器是必要的,以帮助研究人员和爱好者识别他们被法律允许使用的作品。随着项目的演进,它将如何在数据集的巨大规模与尊重每件艺术品独特历史的精确、上下文感知结果之间取得平衡仍有待观察。
最终,The Last Museum 代表了向“智能”发现的转变。通过摆脱手动编目限制,它试图揭示那些原本可能隐藏的艺术作品之间的联系。它是否能成功成为艺术发现的主要工具,取决于其提高搜索准确性以及为数百万条条目提供更易于管理的界面能力。
讨论的关键技术和概念点包括: - 使用嵌入模型来促进概念而非字面上的搜索。 - 不一致的博物馆元数据影响搜索可靠性的挑战。 - 自动化发现与传统博物馆策划体验之间的权衡。 - 区分公共领域作品与受保护内容所需的版权过滤器。 - 人工智能通过揭示相关的历史背景来支持人类创造力的潜力。
证据: - 项目的主要目标是跨 580 万件艺术品进行语义搜索,这由主要来源(primary)确定。 - 关于当前嵌入模型限制以及不一致元数据影响的讨论记录在 Hacker News 帖子(hn-50194522)中。
编辑注释: - 文章侧重于艺术领域语义搜索的技术和概念影响。 - 它探讨了用户反馈中强调的 AI 驱动发现的局限性。 - 它澄清了关键词搜索与语义嵌入之间的区别。
editorial.evidence_sufficient: true