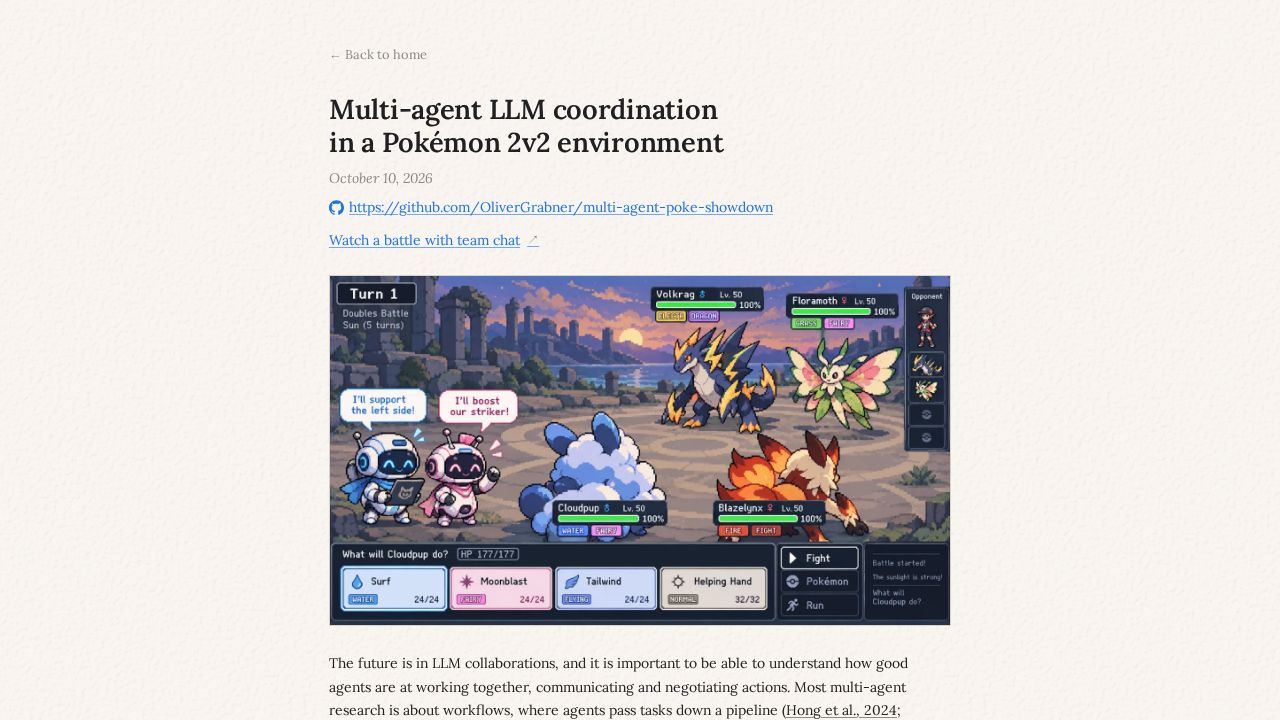
研究人员正在测试大语言模型(LLM)智能体在Pokémon Showdown中的效用,这是一个对人工智能构成独特挑战的对战模拟器。与国际象棋等具有完美信息的游戏不同,Pokémon对战涉及隐藏变量,包括对手的具体技能组合和携带道具。该实验探索了这些通用语言模型如何应对游戏的机制,这些机制既需要战术规划,又需要解释隐藏信息的能力。
目前的实现使用了固定的、随机种子生成的队伍池,以确保测试期间的一致性。虽然该智能体的表现优于业余玩家,但仍会被人类对手击败。该项目突显了通用LLM作为“智能体”日益增长的能力——即能够在动态环境中进行多步推理并做出决策的系统。这与传统的强化学习方法形成对比,后者通常需要专门的引擎和大量的自我对弈迭代才能达到高水平的表现。
围绕该项目的讨论揭示了几个技术细节和局限性。一个有趣的切入点是模型内部“推理”的作用;目前尚不清楚智能体的内部消息是作为更深层次推理的代理,还是仅仅在处理游戏的即时状态。此外,游戏的机制包含半随机元素(如伤害判定),这可能会增加智能体完美预测结果的难度。虽然该智能体目前在受控环境中运行,但最终目标是观察这些模型与那些已经利用专用强化学习技术登上排行榜顶端的专业机器人相比表现如何。