WorldTUI 代表了向“学习型”应用程序的转变,在这种模式下,模型预测用户界面的下一个状态,而不是通过执行代码来渲染它。该项目由 SimEdw 开发,使用一个 3.6 亿参数的模型——这是 Qwen2.5-Coder-0.5B 架构的缩减版本——来模拟终端环境。与解释针对真实操作系统的命令的标准终端模拟器不同,WorldTUI 没有后端;屏幕上的每一个字符都是模型根据先前输入的历史和当前视觉状态做出的预测。
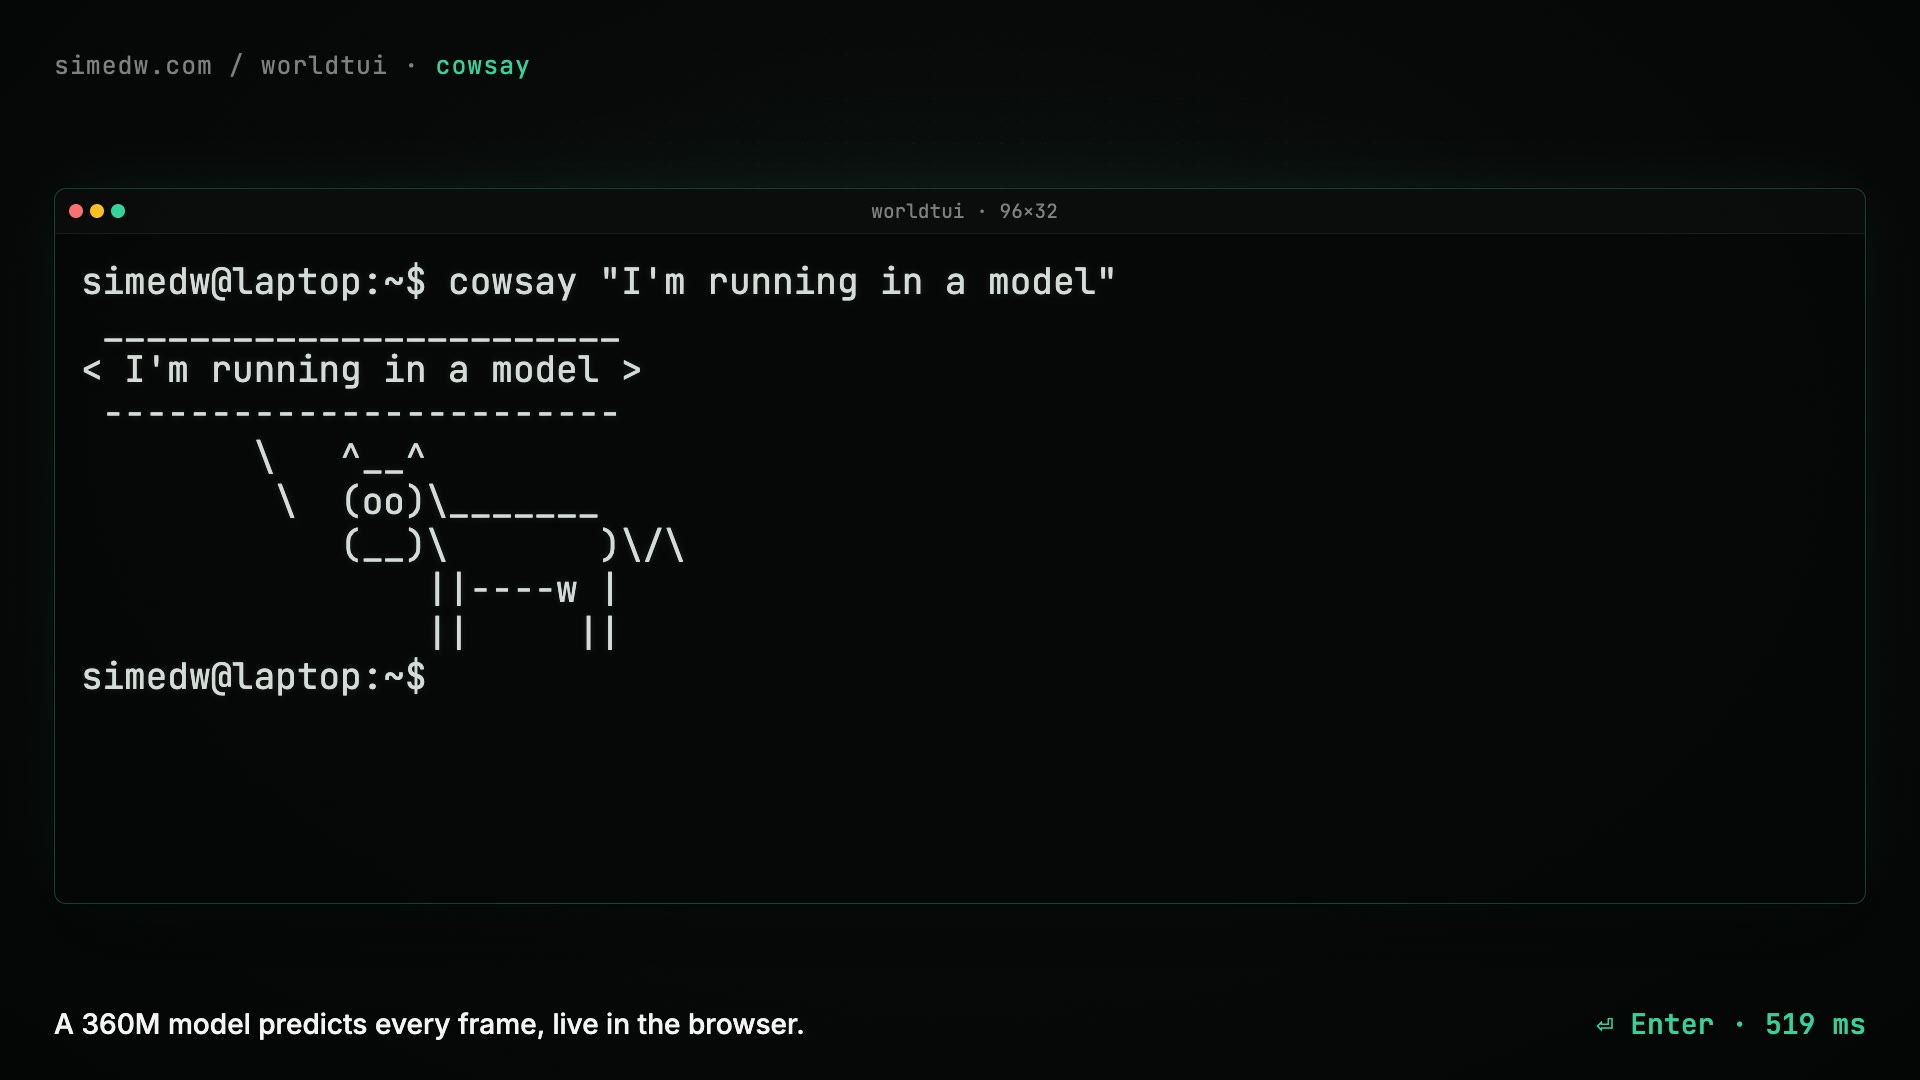
这张图片展示了模型根据用户输入预测视觉终端状态的能力。
为了处理终端的复杂性,该模型将屏幕视为字符网格。由于单次按键(例如“clear”或 vim 中的“Esc”序列)可能会大幅改变整个显示内容,因此系统并不预测文本流。相反,它预测特定的行更新和光标移动。为了保持性能,开发者实现了一种“COPY”操作,允许模型使用少量 token 移动整行文本(例如在滚动时),而不是重新生成每个字符。这种方法允许模型维持一个一致的内部“世界”,使其能够记住在先前步骤中创建的文件,并导航复杂的多窗口环境,如 tmux。
最重要的技术障碍之一是实现大屏幕更新的实时性能。由于自回归模型逐个生成 token,全屏重绘可能需要几秒钟。开发者通过实现并行行解码解决了这个问题,模型可以同时为不同行生成更新。为了确保这些独立的行保持协调(例如,防止在 Snake 游戏中多个行同时添加食物),系统使用投机解码:并行行提供“草稿”,模型随后按顺序进行验证。最终模型足够小,可以通过 WebGPU 在 Web 浏览器中运行,其被量化至 208 MB,以支持本地、低延迟的推理。
尽管具备这些能力,WorldTUI 在长期记忆和复杂逻辑方面仍面临局限性。虽然它可以成功执行文件读取并导航 vim,但在以新颖方式组合命令时仍可能失败,例如在执行“echo”命令后未能显示追加的行。此外,模型蒸馏实验表明,虽然较小版本的模型可以通过记忆测试,但它往往会失去执行广泛标准 shell 命令的能力,这突显了在不牺牲功能广度的前提下缩小“世界模型”的难度。