“决策层级”的概念提出了一种结构化的方法来利用人工智能,将不同的模型视为类内存层级中的不同层。在这个框架中,最低层(L-cache)由手写的规则和过去答案的精确语义匹配组成。中间层(RAM)由专门的决策模型(如 Jev)占据,这些模型提供定义明确的输出,如分数或概率。最高层(disk)是大语言模型(LLM),而最后的兜底手段是人类干预。每一层旨在处理其最有把握的内容,并将“未命中”的情况传递给下方计算成本更高或更复杂的层级。
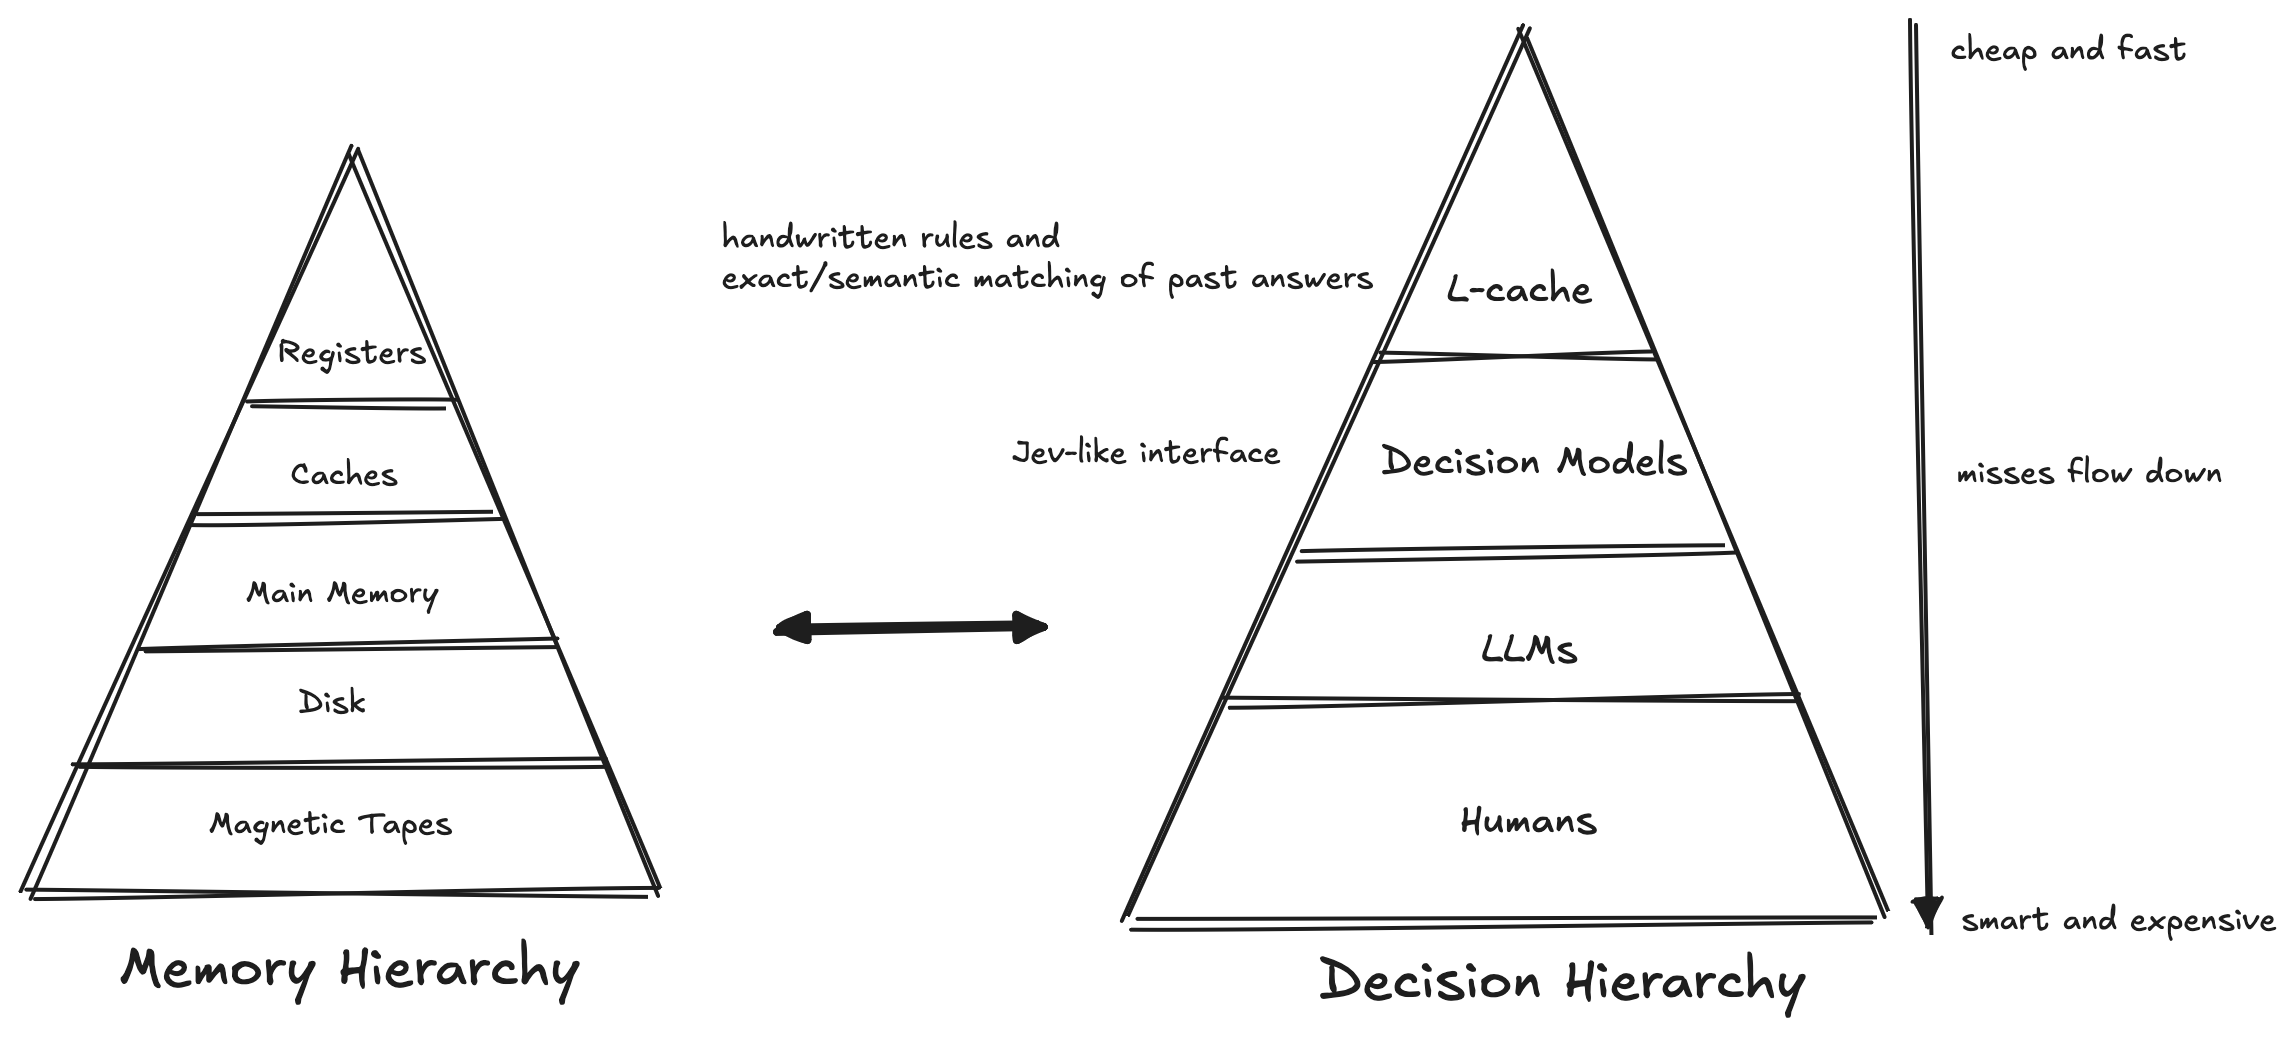
该图表可视化了多层级方法,其中不同的模型处理特定的置信水平。
为了确定何时从较便宜的决策模型转向更昂贵的 LLM,作者引入了一个基于“Chow 规则”的数学框架。该规则通过权衡错误成本与下一层处理费用的比例来计算盈亏平衡点。例如,如果一个决策模型的置信度仅为 60%,系统必须决定错误答案的风险(由该错误的成本加权)是否高于 LLM 的费用和预期错误率。当错误代价极高时,系统优先考虑准确性,使得 LLM 的费用变得不再重要。相反,当错误代价较低时,处理费用就成为决定是否升级查询的主要因素。
该框架通过考虑不同类别中变化的错误成本进一步进行了细化。由于法律路由中的错误可能比技术路由中的错误代价高得多,因此该规则经过调整以纳入特定类别的额外开销。由此产生的模型表明,任何给定查询的最佳路径是正确答案概率与产生该答案所需的智能经济成本之间的双曲线形状的权衡。这种方法超越了简单的置信度阈值,而是将 AI 部署视为一系列经济决策,其目标是最小化处理和错误的总成本。