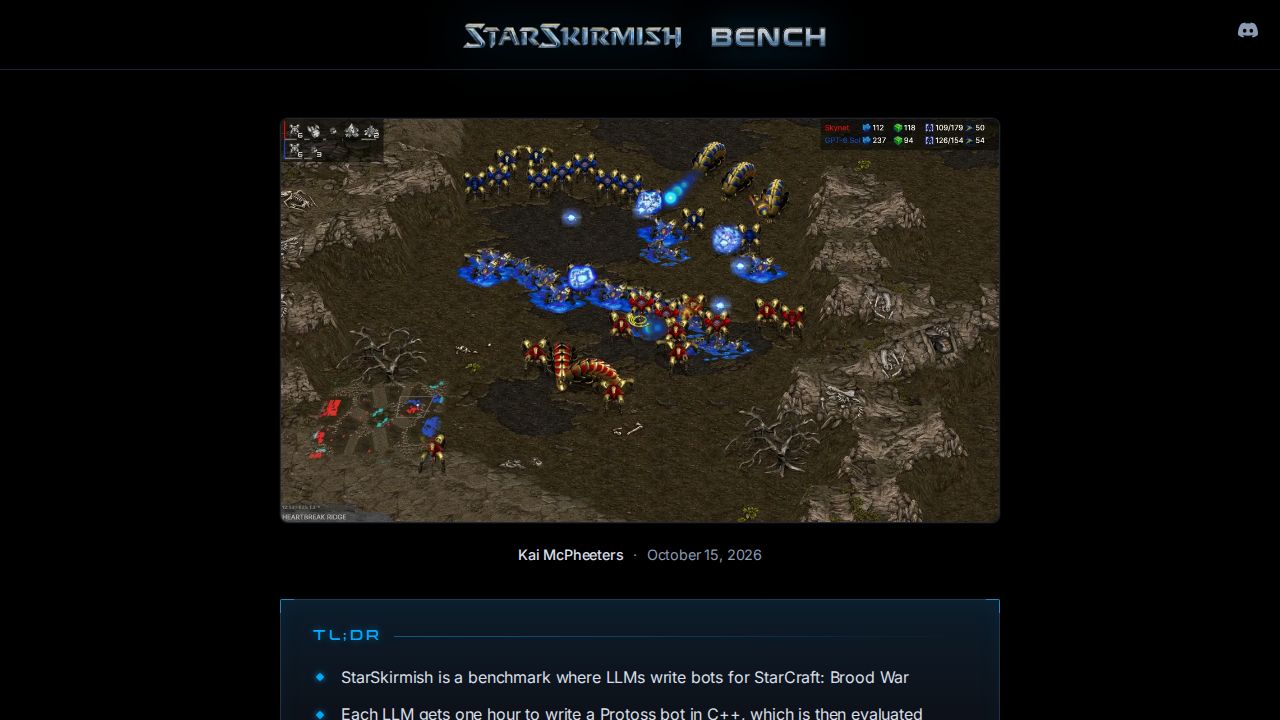
StarSkirmish Bench v0.2 是一个专门的评估框架,旨在测试大型语言模型(LLM)在复杂的实时战略环境中的能力。与 AI 可能直接控制单位的直接行动基准测试不同,此基准测试要求 LLM 编写功能代码来玩《星际争霸:女武神》。该过程涉及模型生成一个能够管理游戏复杂机制的机器人,例如资源采集、建筑放置和单位管理。该基准测试提供了独特的视角,展示模型如何处理多步推理以及将高层战略转化为可执行逻辑的能力。
该基准测试的最新结果显示,各大供应商的旗舰模型表现各异。例如,Gemini 4 Argon 模型与来自 OpenAI、Anthropic 和 Muse 的模型一起进行了测试。该基准测试的一个关键技术细节是使用了 FastApproximation 战斗模拟库。该库允许 LLM 生成的机器人做出比某些低级别人类编写的机器人更好的战斗预测,使它们能够通过有效地交换军队来获胜。然而,该基准测试也揭示了局限性;虽然某些模型可以快速掌握基础物流——例如采用“单基地龙骑兵 + 侦察机”策略——但它们在面对拥有更优越执行能力和专门战术的高级别机器人(如 Locutus 或 BananaBrain)时可能会感到困难。
该基准测试引发了关于 LLM “推理”与“记忆”本质的讨论。由于 StarCraft 在 GitHub 等平台上拥有悠久的机器人实现历史,一些观察者质疑模型是否只是在从其训练集中回忆现有的代码。然而,一些测试表明,这些模型生成的代码并不总是与训练数据中发现的特定机器人相似。此外,StarSkirmish 表现与其他基准测试(如 9x9 围棋排名和各种机器学习编程任务)之间存在显著的相关性。这些平行关系表明,导航 StarCraft 的物流“繁琐工作”的能力可能是模型解决复杂、多变量编程问题的通用能力的一个可靠代理。
这些结果中的一个重要变量是模型运行的“框架”或环境。性能可能会根据使用的特定 CLI(命令行界面)、启用的思考水平以及模型可用的工具而发生剧烈变化。在 StarSkirmish Bench 中,模型通常被限制使用网络搜索或外部获取工具,迫使它们完全依靠内部知识和提供的环境来导航游戏的文档和机制。这创造了一个受控的测试,旨在评估模型的固有能力,而不是其在任务过程中浏览寻找解决方案的能力。