推测解码是一种用于加速大语言模型(LLM)文本生成的技术。在标准的解码过程中,模型一次生成一个 token,这是一个‘受内存带宽限制’(memory-bound)的操作。这意味着 GPU 花费在等待模型参数从全局内存加载到本地内存上的时间,比实际执行数学计算(浮点运算,即 FLOPs)的时间更多。由于 GPU 在这些步骤中并未被充分利用,因此存在‘浪费’的计算能力。
推测解码通过使用一个小型、快速的‘草稿’模型一次性提出一系列 token 来解决这一问题。随后,一个更大、能力更强的模型在单次前向传播中验证整个序列。虽然由于大模型必须处理草稿 token,这实际上增加了执行的总 FLOPs 数量,但它改变了工作的性质。通过同时处理多个 token,该操作变成了‘受计算能力限制’(compute-bound),此时 GPU 的处理能力得到了充分利用。在低批次大小(即系统尚未被多个并发请求饱和)的情况下,这允许模型通过利用原本闲置的‘免费’计算能力,更快速地完成单个序列。
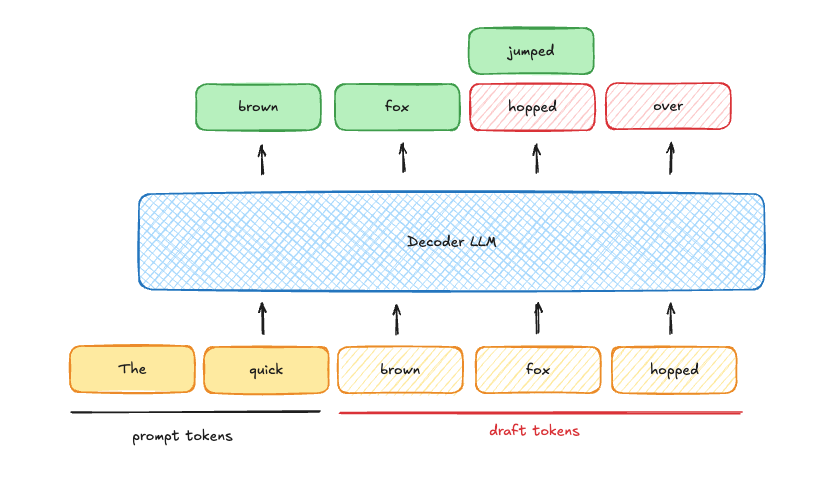
此图说明了推测解码的核心机制,即大模型同时验证多个草稿 token。
然而,这种效率并非绝对,很大程度上取决于草稿 token 的‘接受率’。每一个被拒绝的 token 都代表了浪费的工作,因为大模型在处理最终被丢弃的提议时消耗了计算周期。这在‘广度’(一次处理更多序列)和‘深度’(为单个序列推测更多 token)之间创造了一种权衡。在高吞吐量下,如果批次大小足以使 GPU 的计算能力饱和,推测解码可能会适得其反。这就是为什么一些推理框架(如 vLLM)提供选项,在批次大小达到一定阈值时自动禁用推测解码。动态推测的研究旨在通过根据当前可用的计算能力调整每个序列的推测‘深度’,而不是在每一步使用固定的 token 数量来解决这一问题。(来源:https://jbarrow.ai/2026-10-08-why-is-speculative-decoding-fast/)
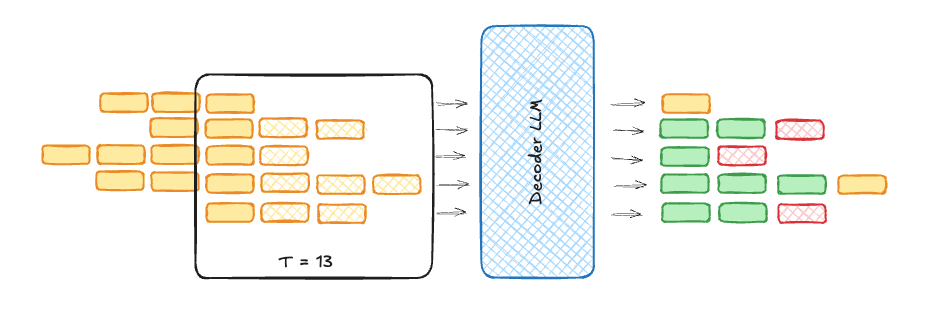
此图展示了动态推测,其中推测深度根据每个序列进行调整以优化吞吐量。
推测解码以牺牲受内存带宽限制的延迟来换取受计算能力限制的吞吐量的基本原理,在其他领域(如机器人领域)也能观察到。在视觉-语言-动作(VLA)模型中,使用‘动作分块’(action chunking)将多个未来的动作组合到单个推理步骤中。这有助于克服高维模型缓慢的延迟,确保机器人能够执行连贯的动作序列,而不是对孤立的时间点做出反应。(来源:https://news.ycombinator.com/item?id=50152539)
最终,推测解码的速度是一个硬件编排问题。通过将工作负载与 GPU 的优势对齐——即在数据已加载的情况下执行更多计算——系统即使在产生最终文本所需的总数学工作量增加的情况下,也能实现更快的结果。