一名开发者发布了一个修改版的 Qwen3-4B-Instruct 模型,命名为“qwen3-4b-deslop”,专门旨在去除通常与大型语言模型(LLMs)相关的风格特征。这些“习惯”包括频繁使用破折号、重复的三项式列表结构,以及特定的过渡短语,如“delve”或“seamless”。通过结合蒸馏和神经元编辑,该开发者旨在生产出一个生成的文本更接近人类写作风格,且不牺牲提供正确事实信息能力的模型。
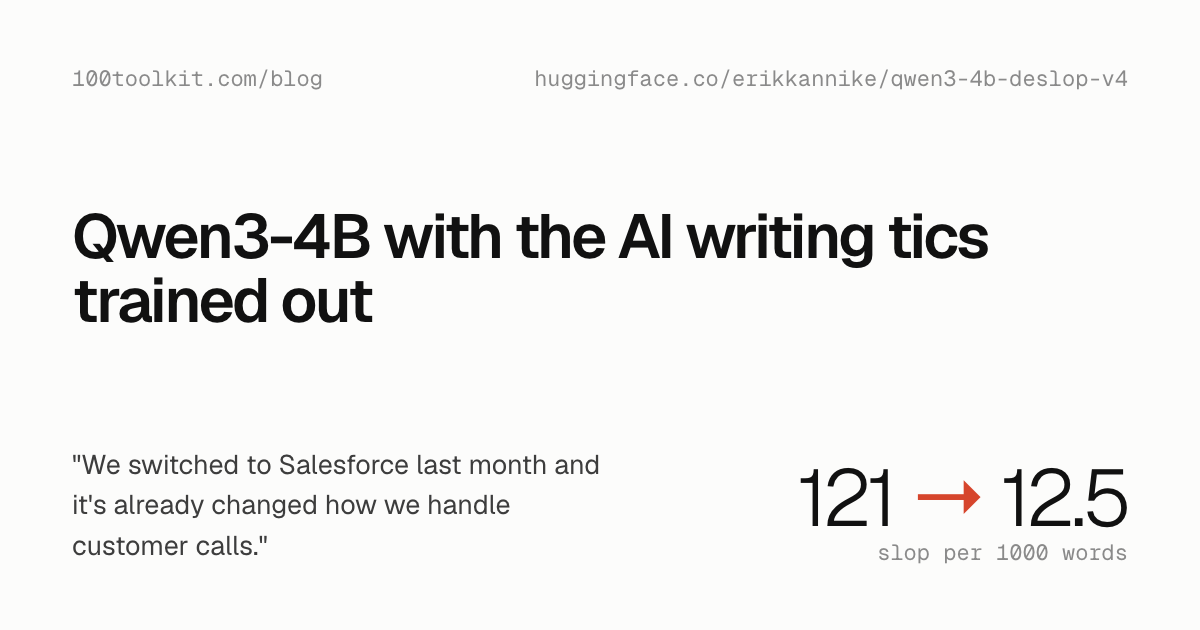
这张图片代表了该项目旨在去除 Qwen3-4B-Instruct 模型输出中“slop”的目标。
训练过程涉及多轮蒸馏。开发者首先在模型的权重中识别出特定的“助手”行为,并使用“教师”模型生成通过一系列风格和任务契合度检查的高质量回答。一个显著的技术步骤涉及“神经元编辑”,其中四个特定 MLP(多层感知机)神经元的符号被翻转,以去除特定的语言习惯,例如“不是 X,而是 Y”的结构。在最终迭代中,模型在 161 个成功避免“slop”的高质量答案上进行了训练——“slop”是开发者创建的一个用于衡量和计数这些风格习惯的指标。结果是“slop 分数”从每 1000 字 121 分显著降低到 12.5 分,许多输出的得分处于人类撰写散文的范围内。
尽管减少了风格上的瑕疵,该模型仍面临若干局限性。开发者指出,生成的散文可能显得“平淡”或过于陈述性,且模型仍偶尔会虚构名称和地点以提供具体细节。此外,虽然该模型在短篇英文散文上表现良好,但其在代码、长篇对话或其他语言上的表现仍未经过验证。开发者计划将此方法扩展到更大的模型,并最终使用基础模型(即尚未经过“助手”训练的模型),以观察是否可以在不产生当前迭代平淡语调的情况下,将更细致的“品味”注入权重中。
“deslop”模型的技术细节包括一个 LoRA 适配器(126 MB)和用于神经元编辑的 175 字节权重列列表。该模型提供量化后的 GGUF 格式,可用于 Ollama 或 llama.cpp 等工具,同时也提供全精度权重供 Hugging Face transformers 库使用。开发者强调,目前的结果是基于自编风格指南得出的,尚未经过盲测以确定“去冗余”后的文本是否真的比原始文本更受青睐。