布隆过滤器(Bloom filters)是用于判断某个项目是否存在于集合中的概率数据结构。由于它们占用极少的内存,并能提供“肯定不存在”或“可能存在”的答案,因此在高性能系统中非常高效,能够让系统跳过诸如磁盘 I/O 等昂贵的操作。例如,Bluesky 后端使用它们每秒过滤数百万次查询,针对其 Scylla 数据库,成功跳过了约 99% 请求的数据库命中。
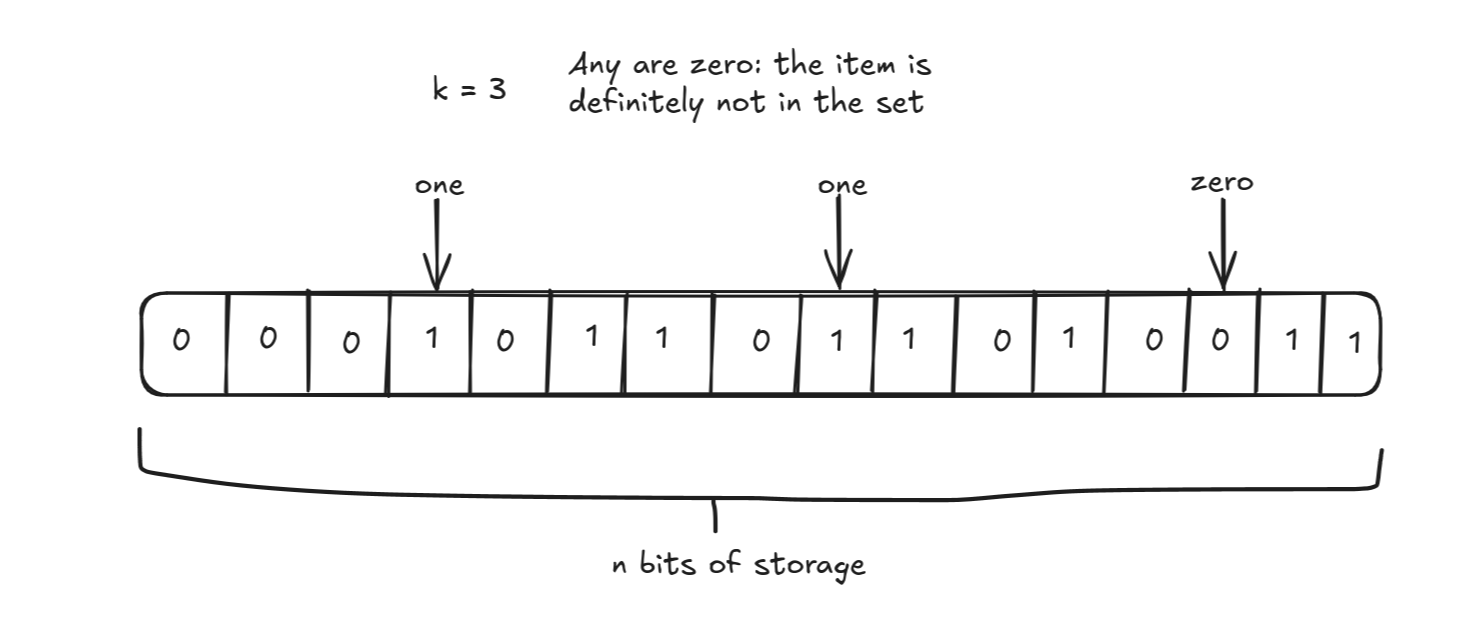
此图说明了布隆过滤器的基本逻辑,其中单个零位提供明确的“不存在”结果。
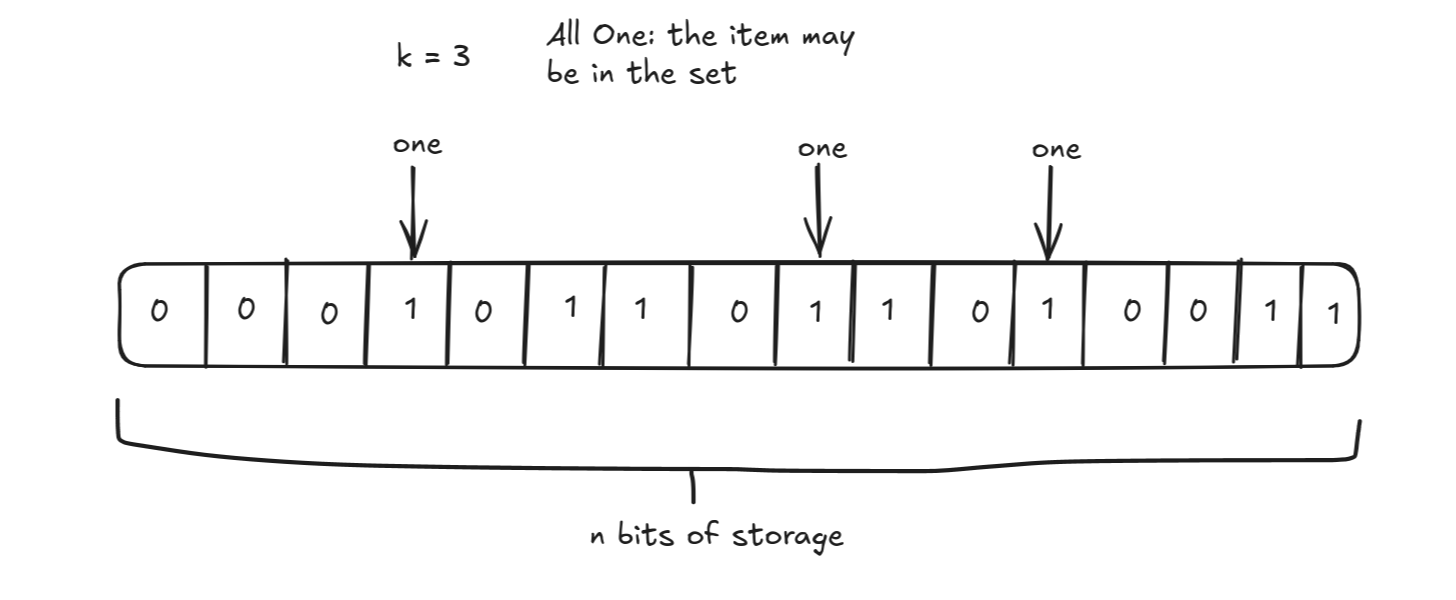
此图展示了布隆过滤器的概率性质,其中一组“一”位表明项目可能存在。
传统的布隆过滤器依赖于一个位数组和 $k$ 个不同的哈希函数。为了检查一个键,系统需要对该键进行 $k$ 次哈希计算,并检查相应的位位置。虽然这种方法有效,但计算多个独立的哈希值可能非常耗费计算资源。为了缓解这一问题,开发人员通常使用“双重哈希”,即使用两个哈希值来推导出 $k$ 个位置。然而,Calabro 指出,即使是这种方法也可能导致性能瓶颈,例如在多线程环境中的互斥锁竞争。Bluesky 通过转向基于原子操作的实现解决了这一问题,该实现用原子 CPU 指令取代了互斥锁,将部署时间从 90 分钟显著缩短至 15 分钟。
为了进一步优化,Calabro 实现了基于 Lu 等人研究的“单哈希布隆过滤器”(OHBF)。该方法将一个大的位数组分成 $k$ 个成对互质大小的分区。仅使用一次键的哈希值即可确定每个分区中的位位置。这种方法消除了对多次哈希计算的需求。该实现还结合了底层优化,例如将 64 字节块与 CPU 缓存行对齐,以确保查找操作最多产生一次缓存未命中。虽然这种方法提供了显著的加速,但它涉及空间效率的权衡;分区可能导致各段占用不均,可能需要更大的整体过滤器尺寸来保持较低的误报率。
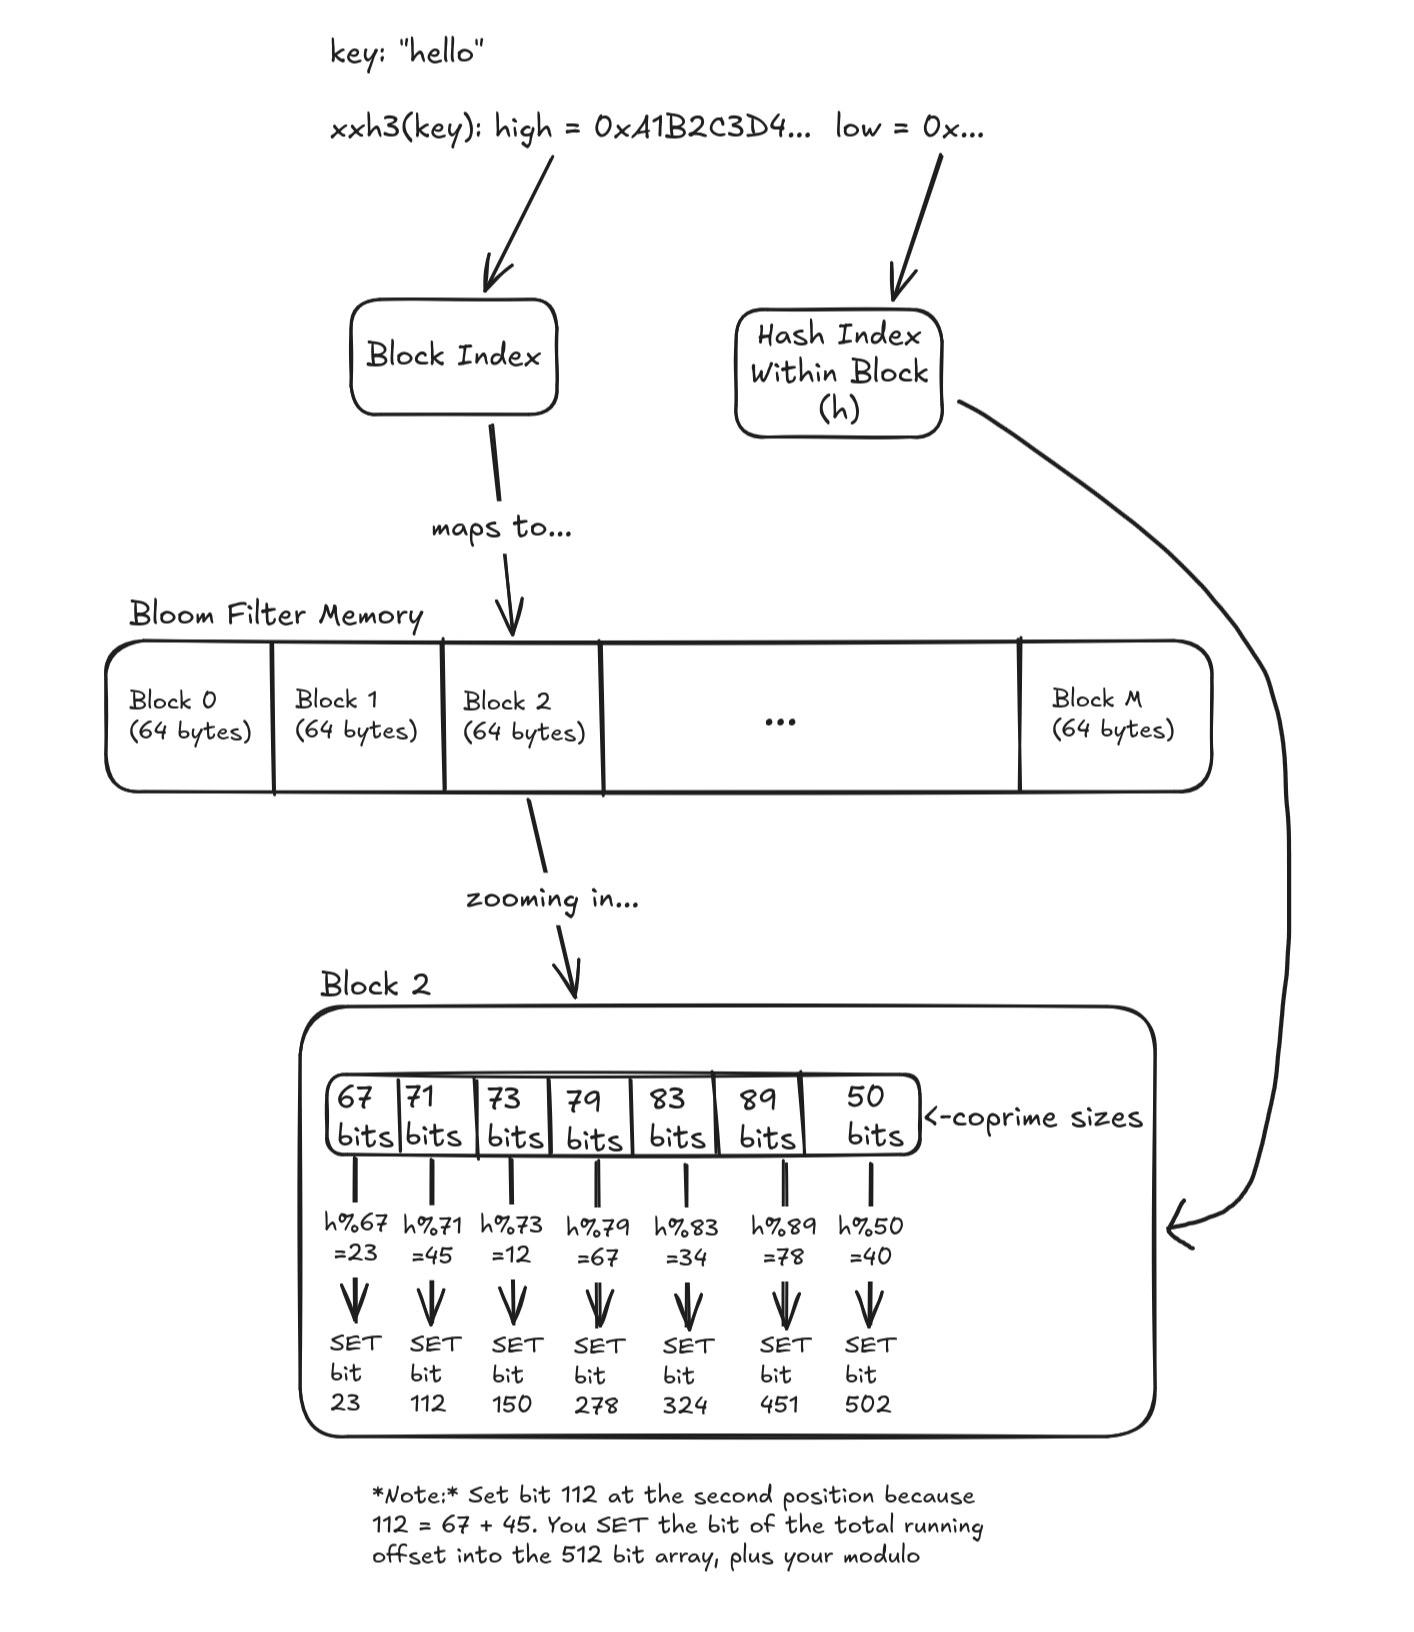
此图解释了单哈希布隆过滤器(OHBF)方法,即使用单次哈希来确定互质分区中的位位置。
最后一个优化涉及用单次乘法(MUL)指令取代模运算——模运算需要昂贵的除法指令——来选择要检查的块。通过结合这些技术——单哈希逻辑、缓存对齐和基于乘法的索引——系统实现了高吞吐量的查找,同时最大限度地减少了 CPU 周期和内存延迟。OHBF 实现目前已在 Bluesky 后端及其高性能同步服务 Jetstream 中投入运行。