MiniMax 正式发布了 M3.1 Flash,这是一款全新的大语言模型(LLM),旨在优化“智能体”任务中计算效率与性能之间的平衡。所谓智能体任务,是指 AI 模型必须通过规划、使用工具并执行多步操作来达成目标的各种工作流。该模型被定位为标准 MiniMax M3 的高速替代方案,旨在为软件开发、计算机操作和网络安全提供能力的代际飞跃,同时显著降低在线推理的成本。
此图作为 M3.1 Flash 模型发布及其平衡速度与性能核心价值主张的主要视觉展示。
为了实现这些提升,MiniMax 利用激进的稀疏化技术来优化推理效率。根据公司的说法,该模型的输出速度可超过每秒 200 个 token(TPS),中位速度稳定在 170+ TPS。这些性能改进伴随着大幅的价格下调;公司声称,对于智能体任务,整体使用成本比前代模型降低了 70%。该模型的定价为每百万输入 token 0.15 美元,每百万输出 token 0.60 美元,缓存输入的费率为 0.015 美元。
此图展示了第二段中讨论的关于 token 速度和定价的技术优化和性能提升。
MiniMax 展示了多个特定基准测试,以证明该模型在复杂环境中的能力。它在评估多步规划和金融合规性的 BankerToolBench 上获得了 76.2 分,在要求模型独立理解代码并通过测试验证修复方案的软件工程基准 DeepSWE v1.1 上获得了 73.7%。在模型与操作系统交互并执行跨应用程序任务的计算机操作领域,M3.1 Flash 在 OSWorld V2 上获得了 61.7 分,在 Agents’ Last Exam (ALE) 上获得了 29.6 分。虽然该模型目前可通过 API 和 MiniMax M Plan 获取,但公司表示模型权重将在稍晚日期发布。
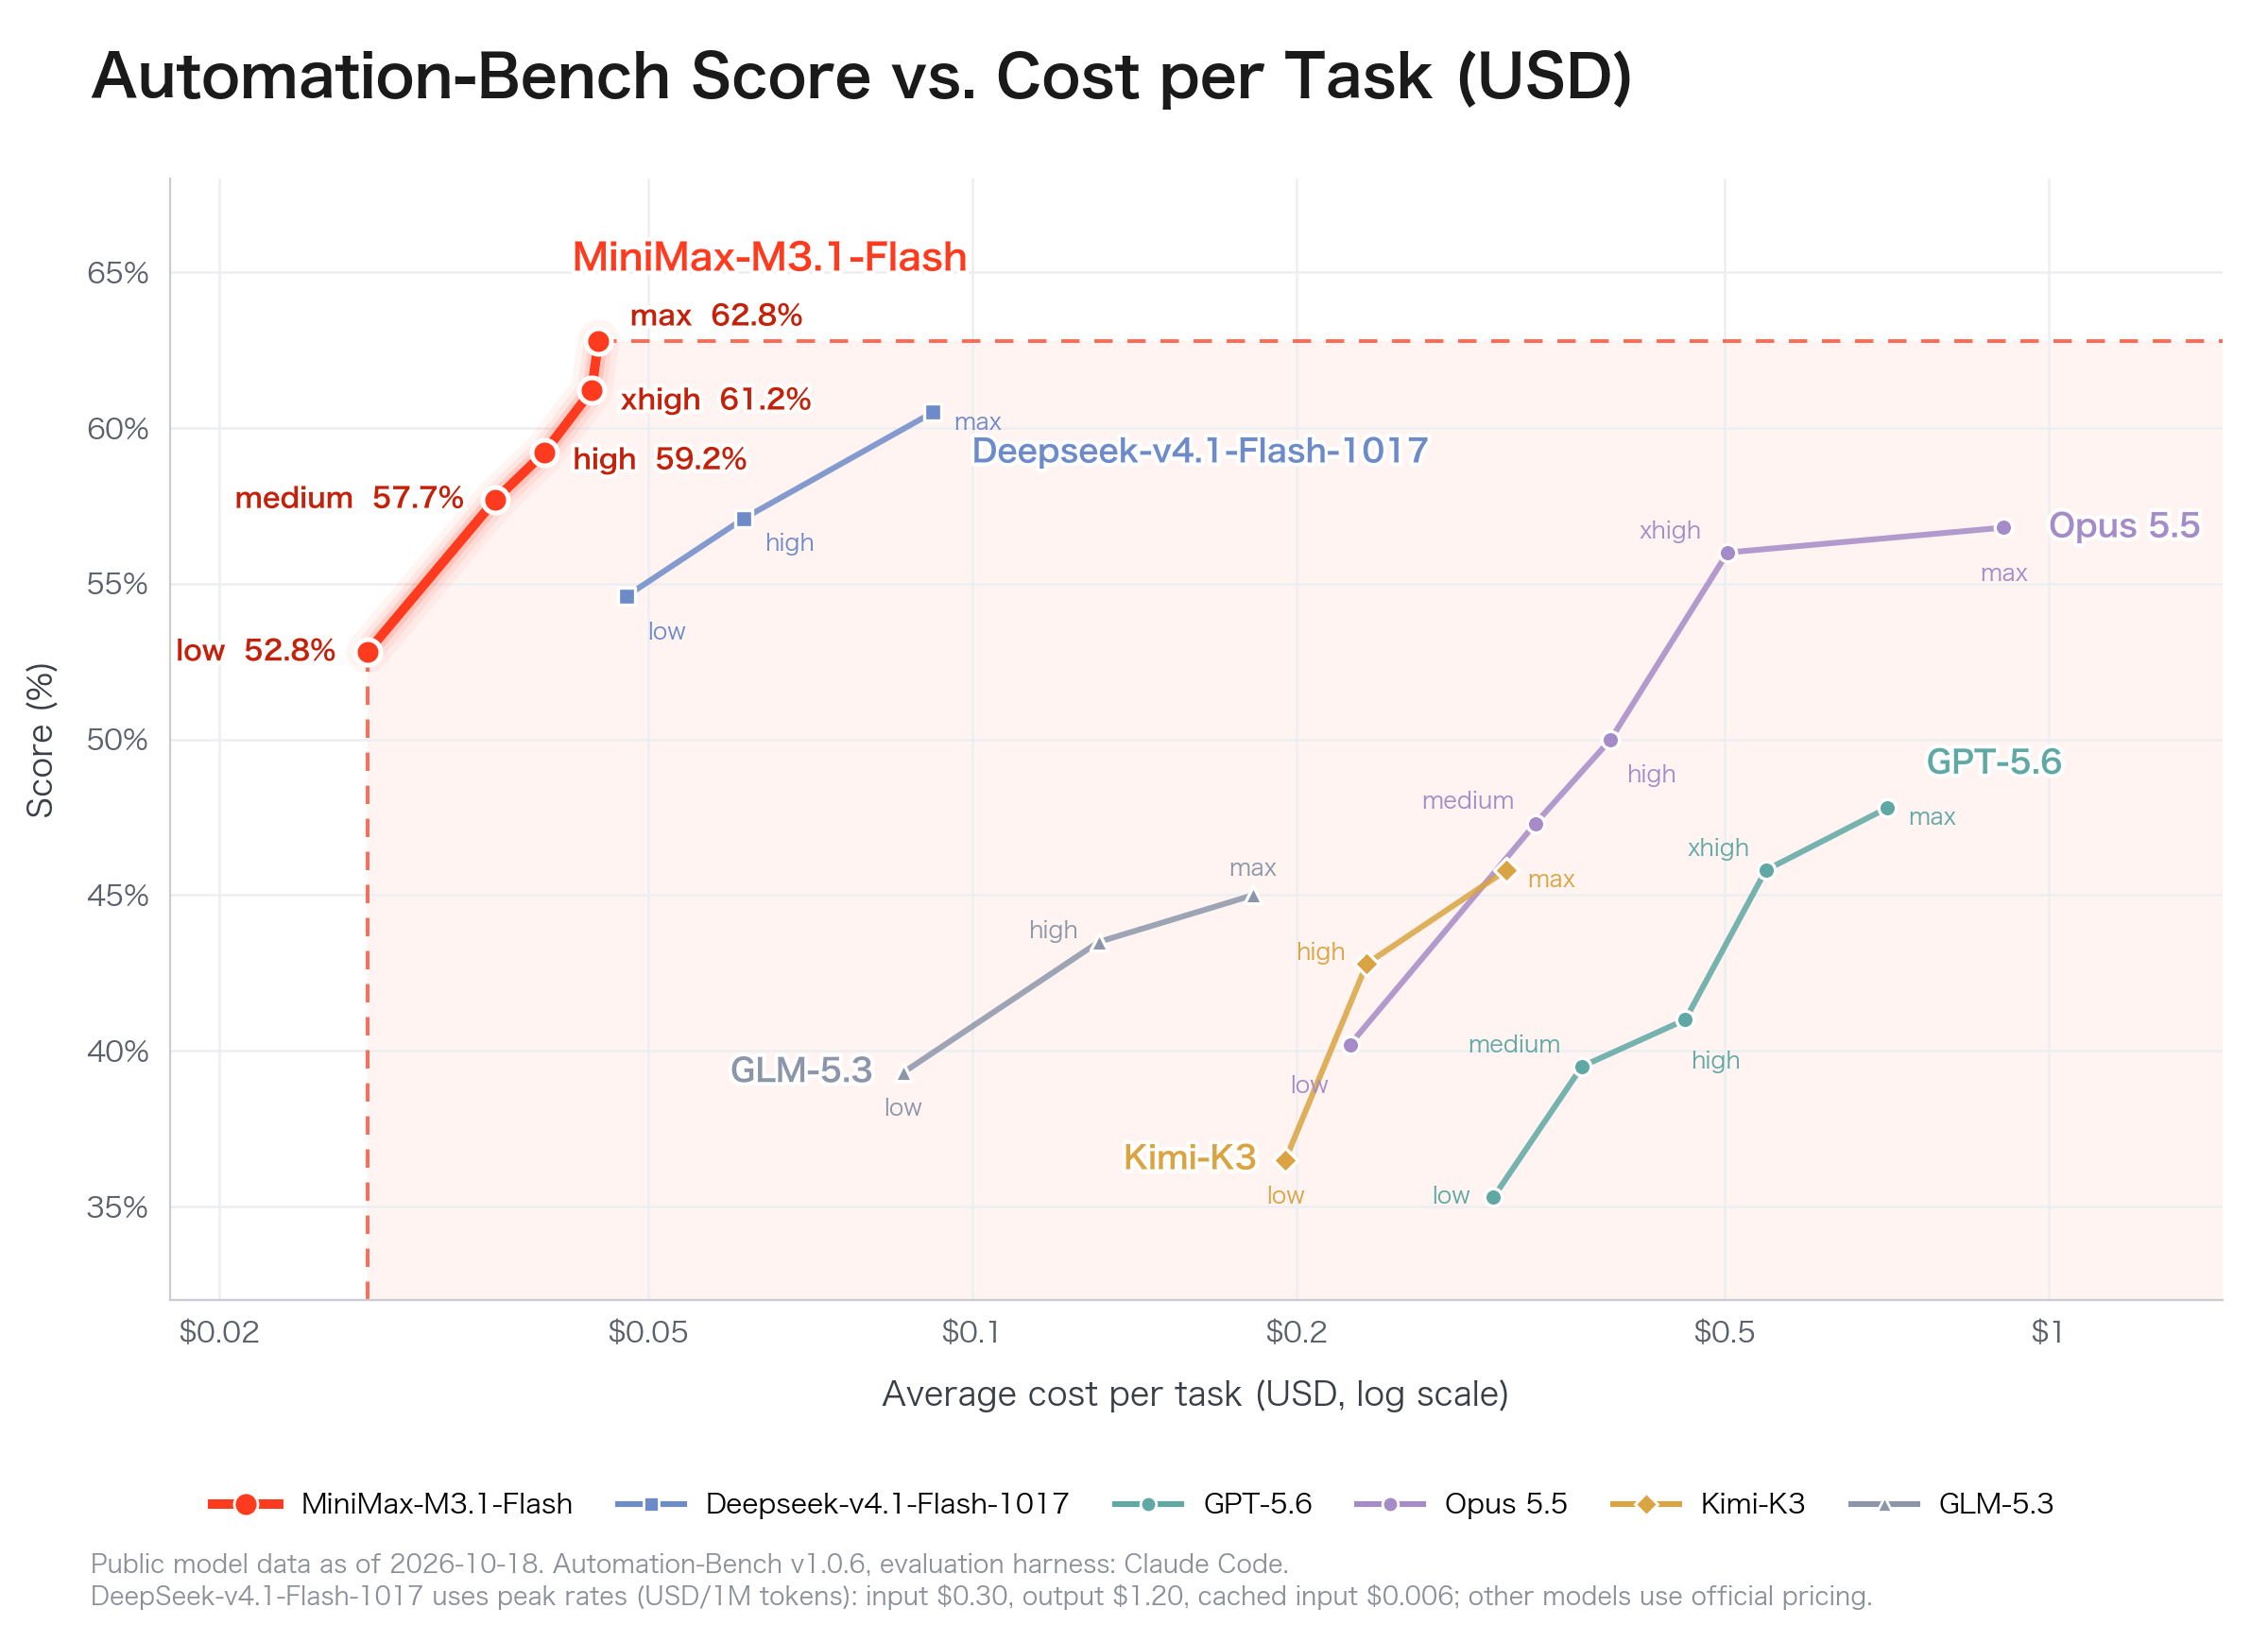
此视觉效果支持最后一段提供的关于软件工程和金融合规性的具体基准测试数据。