KiviDB 是一个高性能、多线程的 Redis 和 Valkey 替代方案,采用 Rust 编程语言开发。作为“即插即用”的替代品,它支持 Redis 协议(RESP2 和 RESP3),使其能够与现有的 Redis 客户端、库和 `redis-cli` 工具无缝配合。与传统上在单线程命令执行循环上运行的标准 Redis 不同,KiviDB 利用分片内存键值设计,命令在每个核心上运行,旨在最大化硬件利用率。
此图片作为该项目作为基于 Rust 的 Redis 替代方案的身份和核心功能的 primary visual。
该数据库的独特之处在于直接将其核心功能与高级搜索能力相结合。它支持 Redis Stack 风格的 `FT.*` 命令,用于全文本(使用 BM25)、标签、数值和向量搜索(使用 FLAT 或 HNSW 算法)。这种集成允许用户在哈希字段上执行向量近似最近邻(ANN)搜索,而无需额外的模块或外部查询引擎。在持久化方面,KiviDB 采用原生快照和可选的追加日志文件(AOF)。其快照系统的一个显著特点是它保留每个向量字段的 HNSW 图,确保在重启后搜索质量保持一致,而无需重新构建完整的索引。
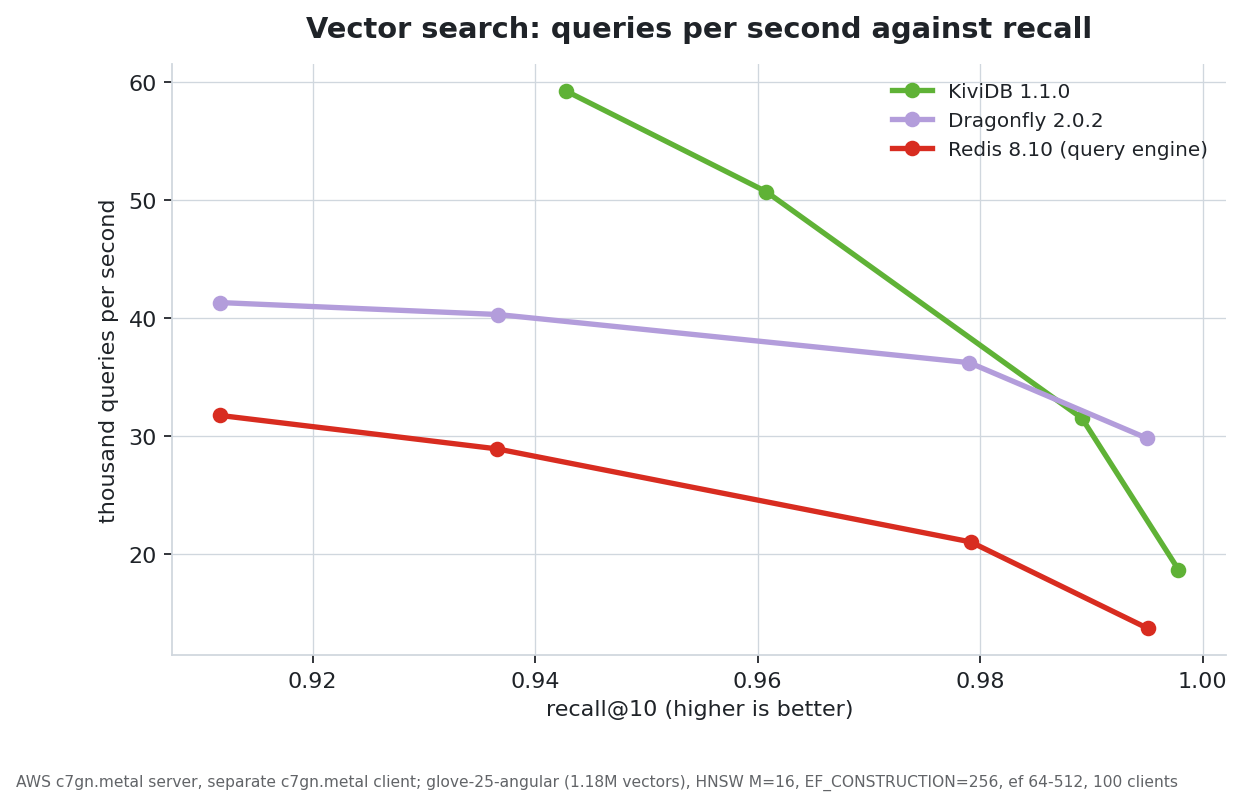
此图表支持关于 KiviDB 集成向量搜索能力和 ANN 算法的讨论。
开发者提供的性能基准测试表明,该数据库相比成熟的竞争对手具有显著的吞吐量优势。在 AWS Graviton3 硬件上进行的测试中,KiviDB 报告在 32 个核心上每秒处理 2100 万个流水线 GET 请求。开发者声称这大约比 Redis 8 快 9 倍,比 Dragonfly 快 2.3 倍。然而,这些数字代表特定的受控环境,并可能因硬件、工作负载和配置而异。虽然 KiviDB 提供了一个具有内置向量能力的、高性能的替代方案,但用户应考虑其 AGPL-3.0 许可证的权衡,以及其分片架构与 Dragonfly 等其他多线程替代方案所使用的“无共享”模型相比的特定性能特征。
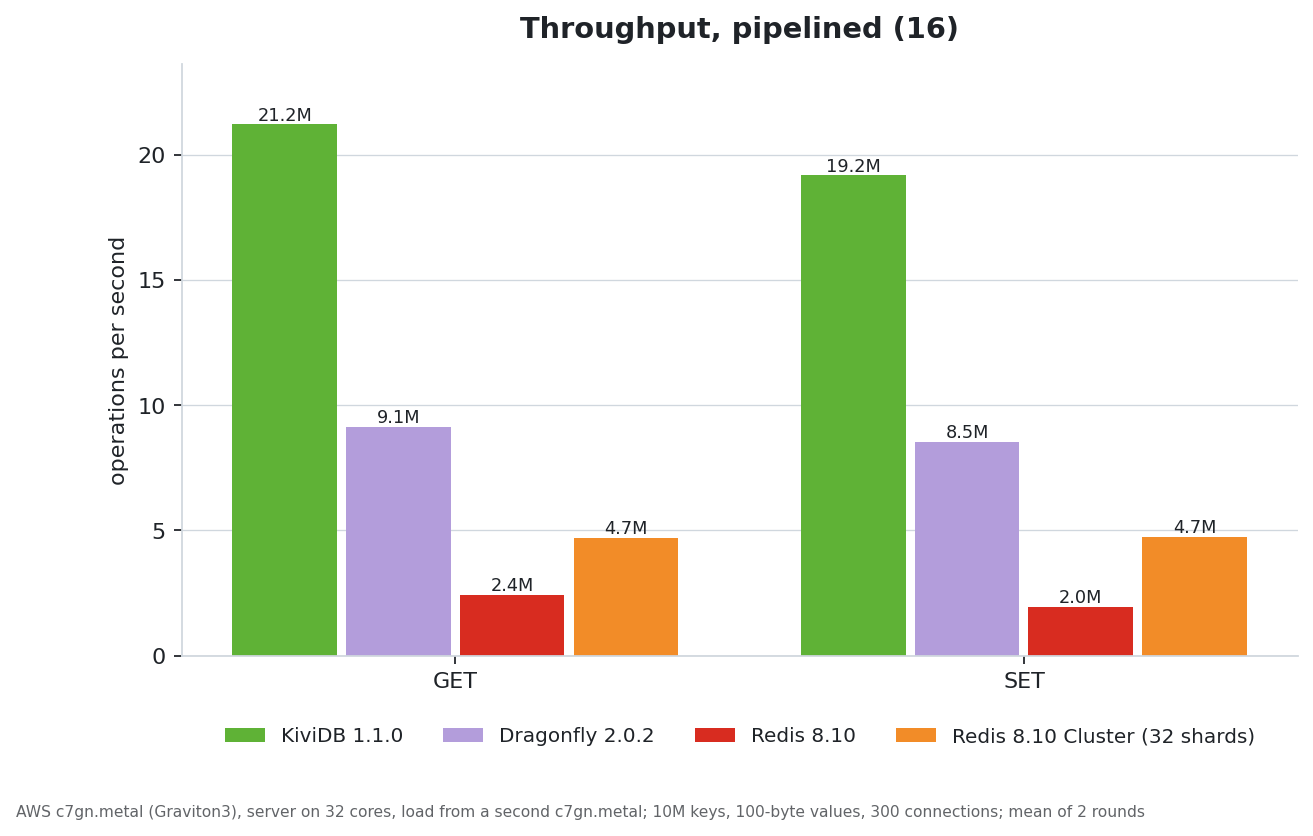
此图表说明了性能基准测试部分提到的特定吞吐量优势。
KiviDB 提供多种配置选项,包括通过 Cargo 特性切换 Lua 脚本和 TLS 支持的能力。它还支持各种淘汰策略和内存限制。在部署方面,它为 `amd64` 和 `arm64` 架构提供 Docker 镜像,并且可以通过默认监听 6380 端口与标准 Redis 实例并行运行。该项目在 GNU Affero General Public License v3 协议下开源,并根据底层 Linux 内核能力提供对 `io_uring` 和 `Tokio` 作为 I/O 模型的支持。
用户需要考虑的一个技术细节是数据库在重新构建索引期间的行为。虽然 HNSW 图保存在快照中,但如果系统是从追加日志文件(AOF)而非快照重启,系统可能需要从原始哈希中重新构建搜索索引。在此期间,大多数命令将返回 `LOADING` 状态,尽管 `PING` 和 `INFO` 等基本命令仍可正常工作。这一区别强调了定期进行快照以维持搜索密集型工作负载高可用性的重要性。
此外,该项目的性能声明引发了关于基准测试方法的讨论。一些观察者指出,由于 Redis 使用多线程进行 I/O 操作,将其与 KiviDB 等多线程架构进行比较时,需要仔细考虑线程池饥饿和核心绑定问题。虽然 KiviDB 的架构旨在通过细粒度锁定来减少锁竞争,但在数据分布和访问模式各异的真实场景中,其实际性能提升仍是需要独立验证的关键领域。