在 AI 领域,“harness”是指围绕大语言模型(LLM)的架构,使其能够作为自主智能体运行。这包括系统提示词、护栏、记忆、工具指导、子智能体、技能、脚本和插件等组件。Harness² 是由 Google Research 开发的一个框架,用于自动化优化这些组件,研究人员将这一过程称为“harnessing”。与标准的微调不同,Harness² 保持底层模型权重固定,而是专注于迭代改进引导模型行为的外部系统。
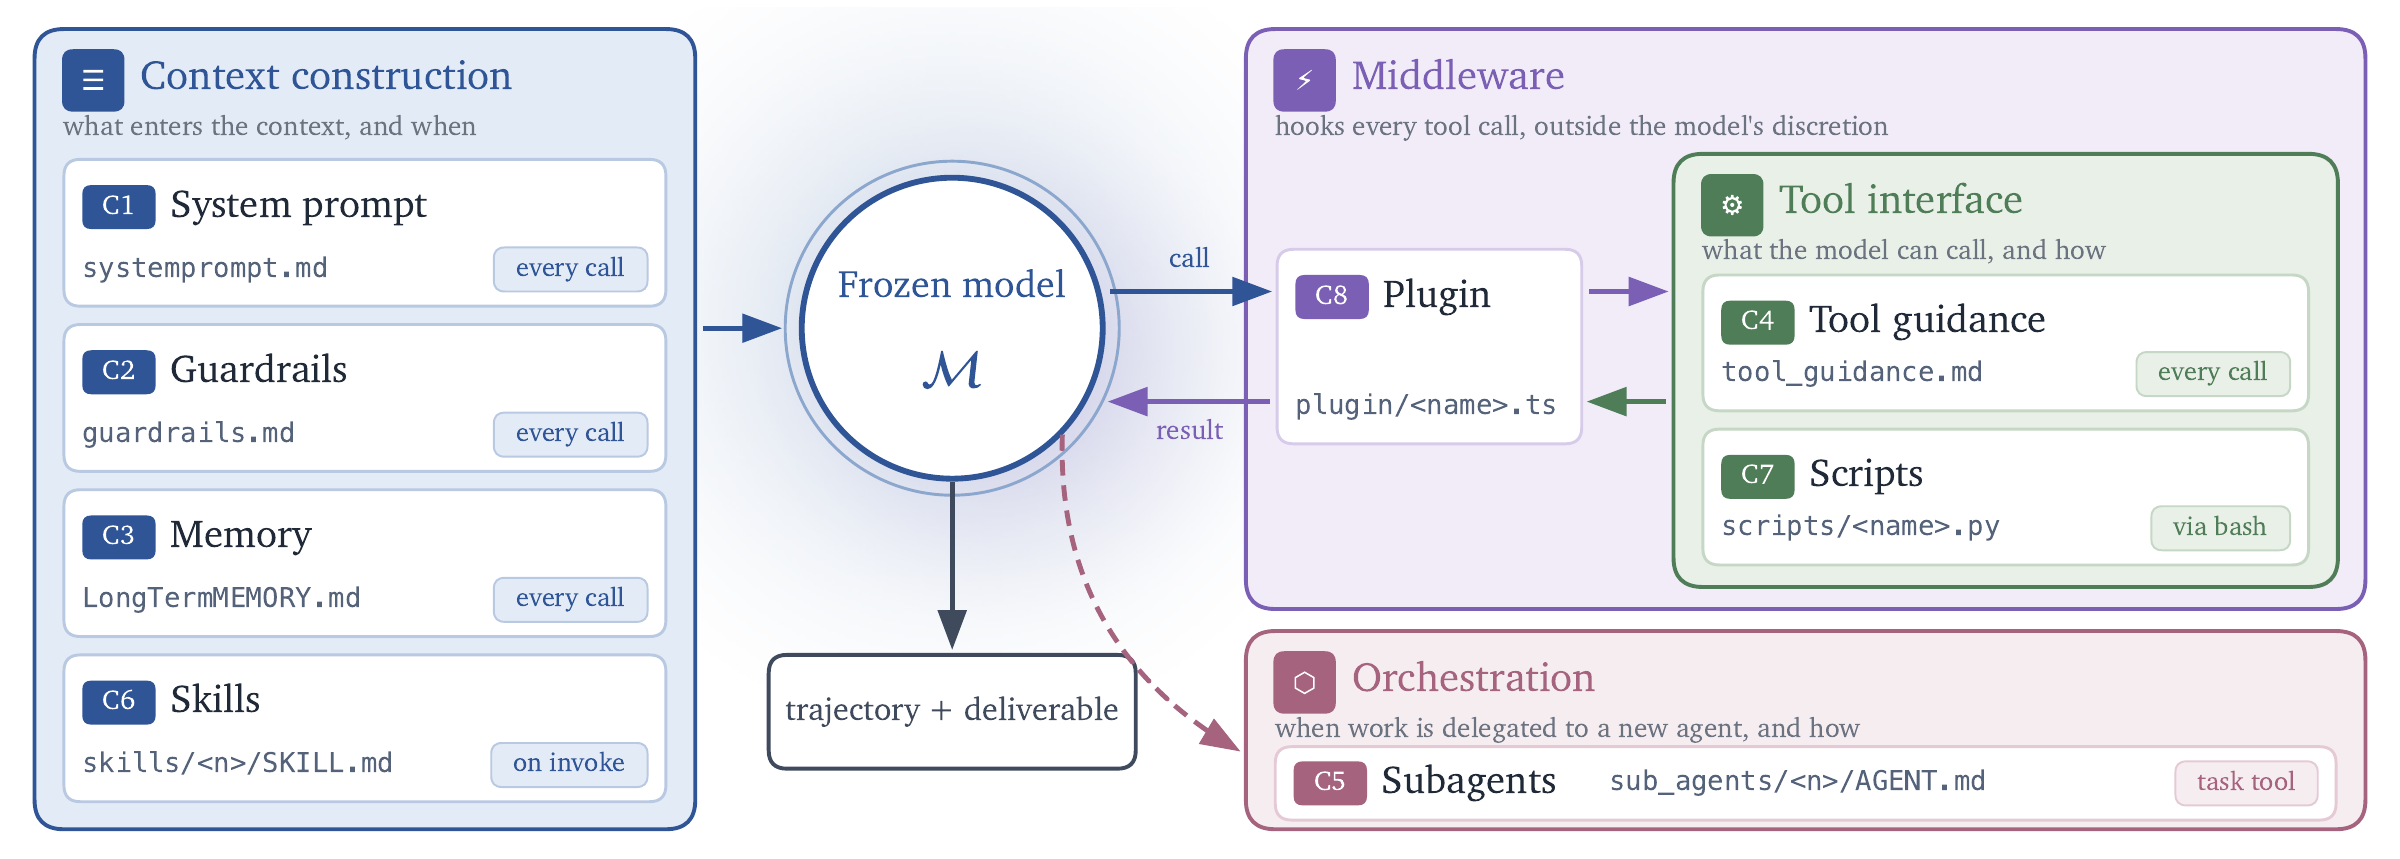
这张图片展示了 Harness² 框架旨在优化的“harness”基础设施的具体组件。
该框架通过两个不同的递归层级来处理“开放世界”场景,即智能体面临在初始设计阶段未明确考虑到的任务。第一层是“任务级递归”,它使用“提议–探测–组合”(Propose–Probe–Compose)循环。智能体提议对其自身的 harness 进行修改,探测这些修改对当前任务的影响,并根据行为对比组合出改进版本。第二层是“harnessing 级递归”,它维护一个持久的“改进 harness”。这一层从已完成的任务中捕捉经验和证据支持的改进,以指导未来任务的优化,允许系统随着时间的推移从经验中学习。
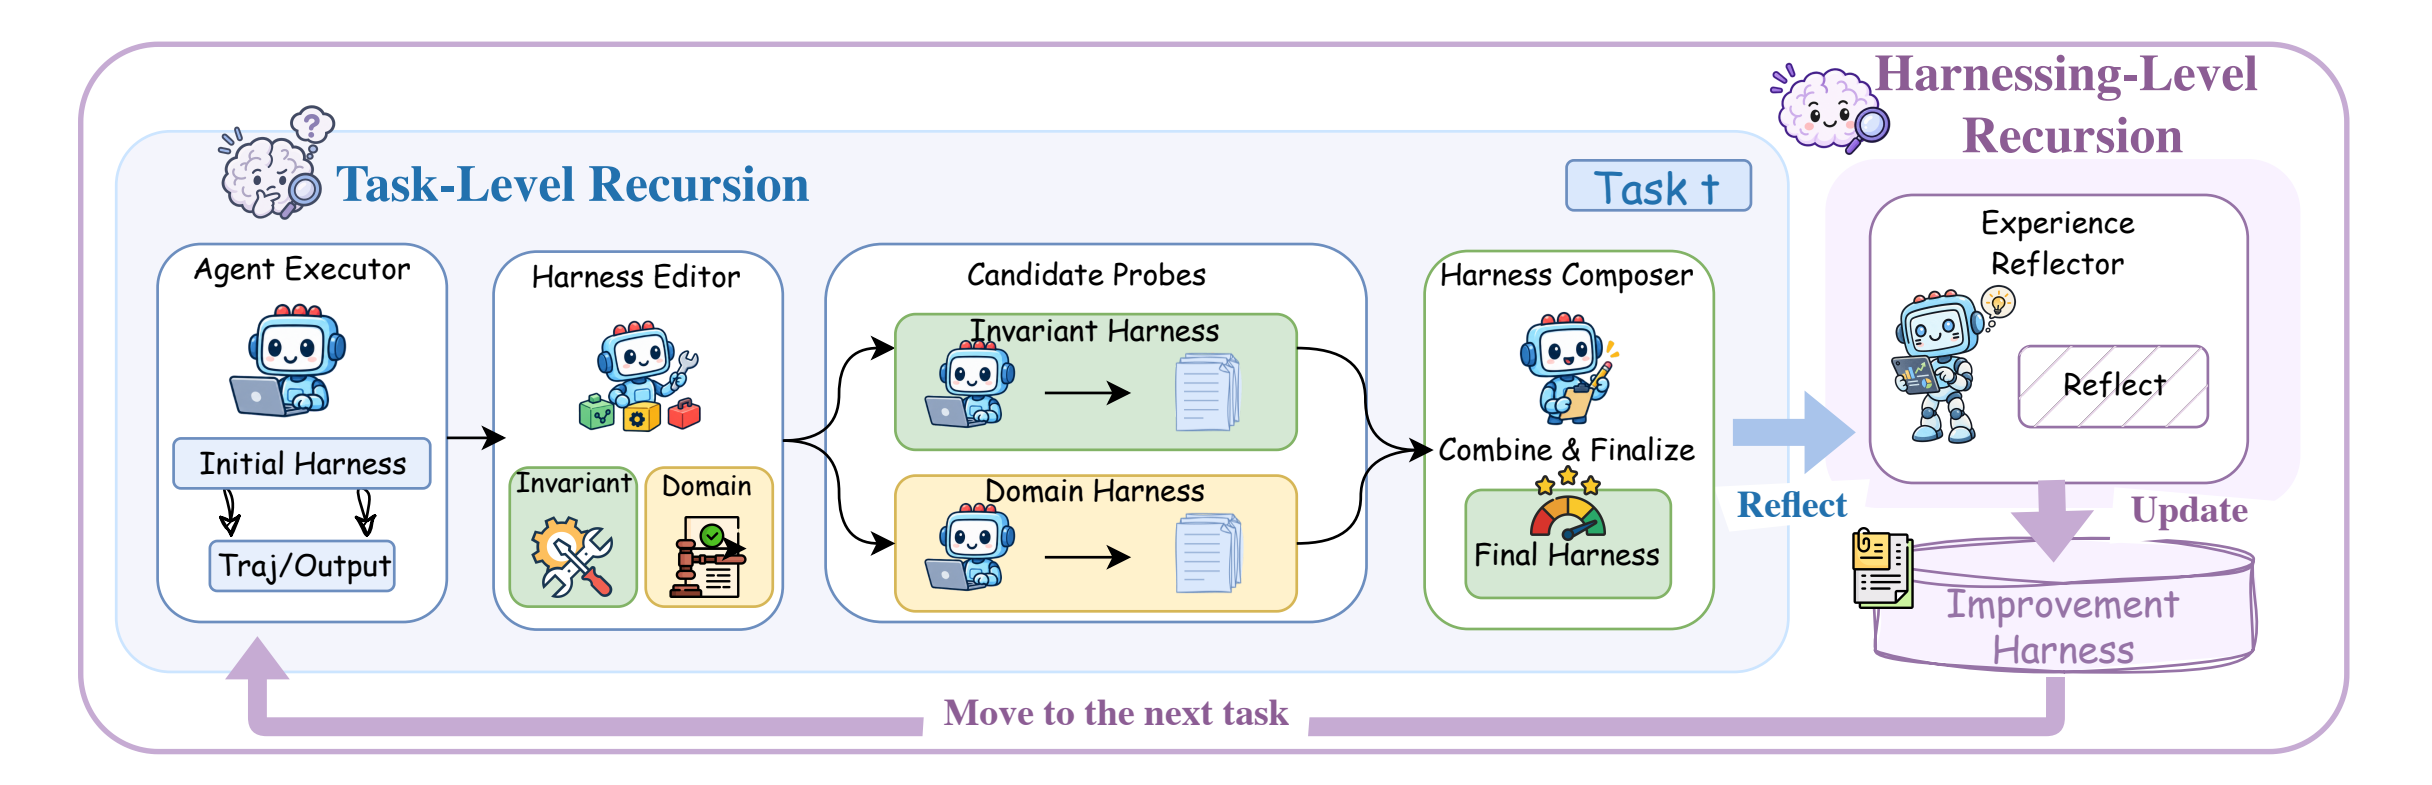
此图解释了第二段中描述的双层递归过程(任务级和 harnessing 级)。
研究人员的实验结果表明,Harness² 可以在专业基准测试中提供显著的性能提升。例如,Harness² 的单步操作改进了 GLM-5 和 Gemini 3.5 Flash 模型,在 WorkBuddy-Bench 上获得了高达 11.5 分的提升,在 LAB 部分通过率上获得了 11.8 个百分点的提升。该框架支持并行递归(同时探索多个候选 harness 以找到最佳组合)和顺序递归(将改进后的 harness 带入连续步骤进行更深层次的优化)。虽然该框架为智能体进化提供了一种结构化的方法,但研究人员指出,系统的有效性随着“递归预算”——即每个任务允许的“提议–探测–组合”步骤数量——而扩展。
该框架的一个显著技术限制涉及其执行环境。虽然框架支持 OpenCode 和 Codex 等各种执行器,但研究人员明确指出,Codex 执行器在禁用沙箱的情况下运行,且执行器网络访问不受限制。为了降低评估过程中的风险,建议用户在运行基准测试前配置网络限制,以防止智能体访问可能损害结果完整性的公共评分标准或评判标准。该项目在 Apache 2.0 许可证下发布,旨在作为开发者构建更具适应性的自主智能体的即插即用工具。
项目 Logo 标识了文章中讨论的框架。
当前实现的一个局限性是依赖智能体自身的执行证据来判断 harness 修改的成功与否。由于系统不依赖于基准反馈(外部的“正确”或“错误”标签),它必须依赖于不同 harness 配置之间的行为对比。这意味着优化的质量本质上与智能体准确探测和解释其自身提议变更后果的能力相关。此外,虽然该框架专为“开放世界”任务设计,但其性能仍取决于初始组件的质量以及用户提供的递归预算深度。
用户可以通过本地演示与框架进行交互,该演示同时运行具有确定性编辑器的递归模式和真实的 Python 执行。对于模型支持的基准测试,该框架与 Vertex AI 集成,并需要特定的依赖项,如 WorkBuddy-Bench 的 Docker,或 LAB 基准测试的 Pandoc 和 Poppler。这些运行的结果会自动保存在结构化目录中,提供任务摘要、交付成果和反思笔记,记录 harness 组件随时间的演变。