DeepSeek 开源了 DeepInfer,这是一个专门为支持 DeepSeek 模型的大规模生产服务而设计的高性能推理框架。虽然当前的发布版本侧重于离线推理,但它包含了扩展所需的核心功能。该框架旨在支持特定的硬件,包括 NVIDIA SM100 GPU 和华为 Ascend 950 NPU。它的开发灵感源于 vLLM、SGLang 和 TensorRT-LLM 等现有框架。
这张图片代表了托管该框架的官方 DeepInfer 仓库。
该框架引入了多种专门的优化来提高吞吐量并降低延迟。这些优化包括 FlashMLA、DeepGEMM 和 DeepEP 等优化内核,以及 Attention DP(数据并行)、平衡的 CP(上下文并行)和带有 EPLB 的 MoE(混合专家)EP(专家并行)等先进的并行技术。它还具备 DSpark 和置信度调度验证功能,利用草稿 token 来加速解码。其他技术特性还包括用于将 CPU 批处理与设备执行重叠的异步调度、批次不变推理(针对 NVIDIA 硬件)以及确保相同输入参数产生一致输出的确定性采样。
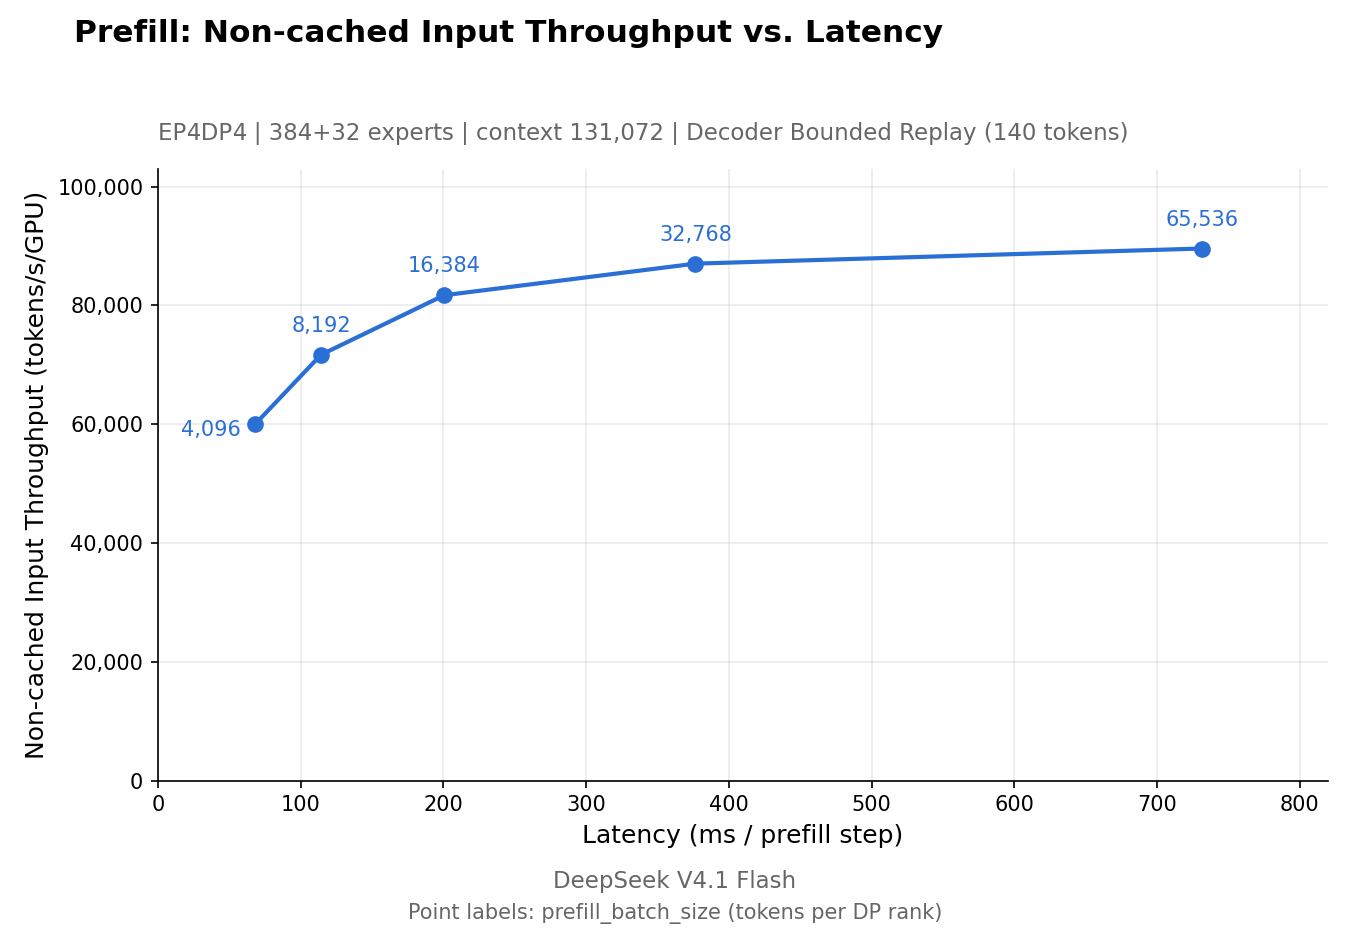
该图表可视化了技术优化中提到的预填充过程的性能特征。
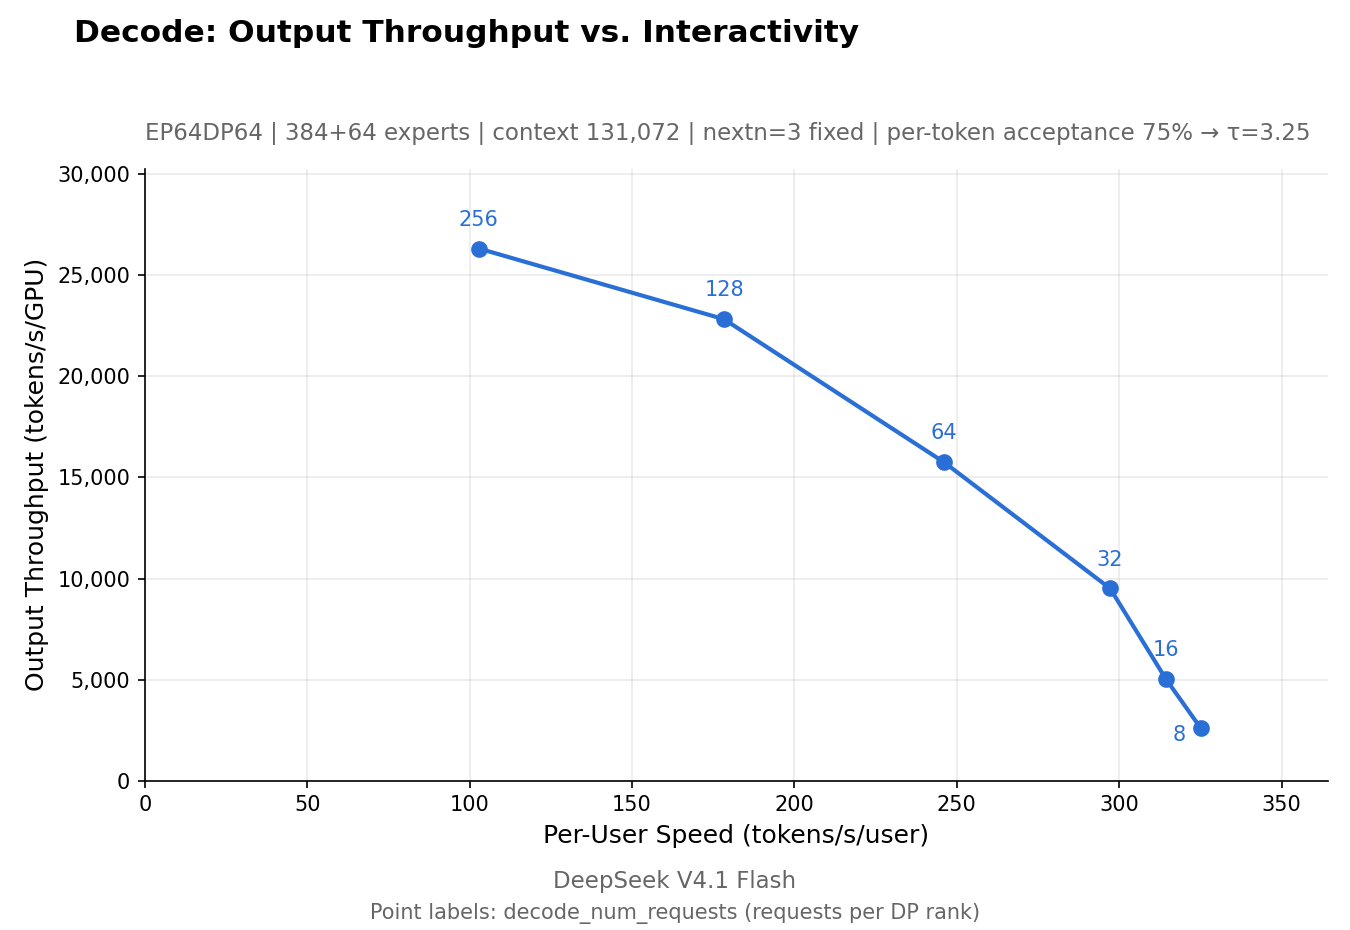
该图表展示了框架优化支持的解码性能指标。
尽管具有高性能能力,当前的开源版本在完整的生产推理服务方面仍有一些局限性。它尚未包含 KV(键值)缓存系统或 VE/Prefill/Decode 分离。此外,虽然它提供了核心引擎功能,但它缺乏在预填充(prefill)和解码(decode)阶段跨数据并行副本的内置负载均衡。用户在部署该框架时,在构建全规模服务时必须考虑到这些缺失的组件。