PS5LM 是一个旨在利用 PlayStation 5 硬件进行本地 AI 推理的开源项目。通过利用 llama.cpp 的 Vulkan 后端来调用控制器的 RDNA 2 GPU,该软件允许用户直接在设备上加载并运行 GGUF(GPT-Generated Unified Format)模型——这是量化大语言模型的一种常用格式。该系统利用控制器的约 11.4 GB 共享内存来承载模型及其上下文,支持 llama.cpp 框架所支持的各种架构和量化方法。
该项目作为一个私人的模型服务器运行,为本地网络上的其他设备(如笔记本电脑、手机或编程工具)提供请求服务。它提供与标准 API 的兼容性,包括 OpenAI 的 /v1/chat/completions 和 Anthropic 的 /v1/messages,使其能够与 Claude Code 等现有软件进行交互。除了标准聊天功能外,PS5LM 还支持“决策模型”——这类模型旨在通过单次前向传播输出特定类型的决策、评分和“是/否”答案,而不是生成长字符串文本。控制器的界面会显示实时遥测数据,包括温度、功耗以及 GPU/CPU 负载,同时在电视屏幕上流式传输请求和回复。
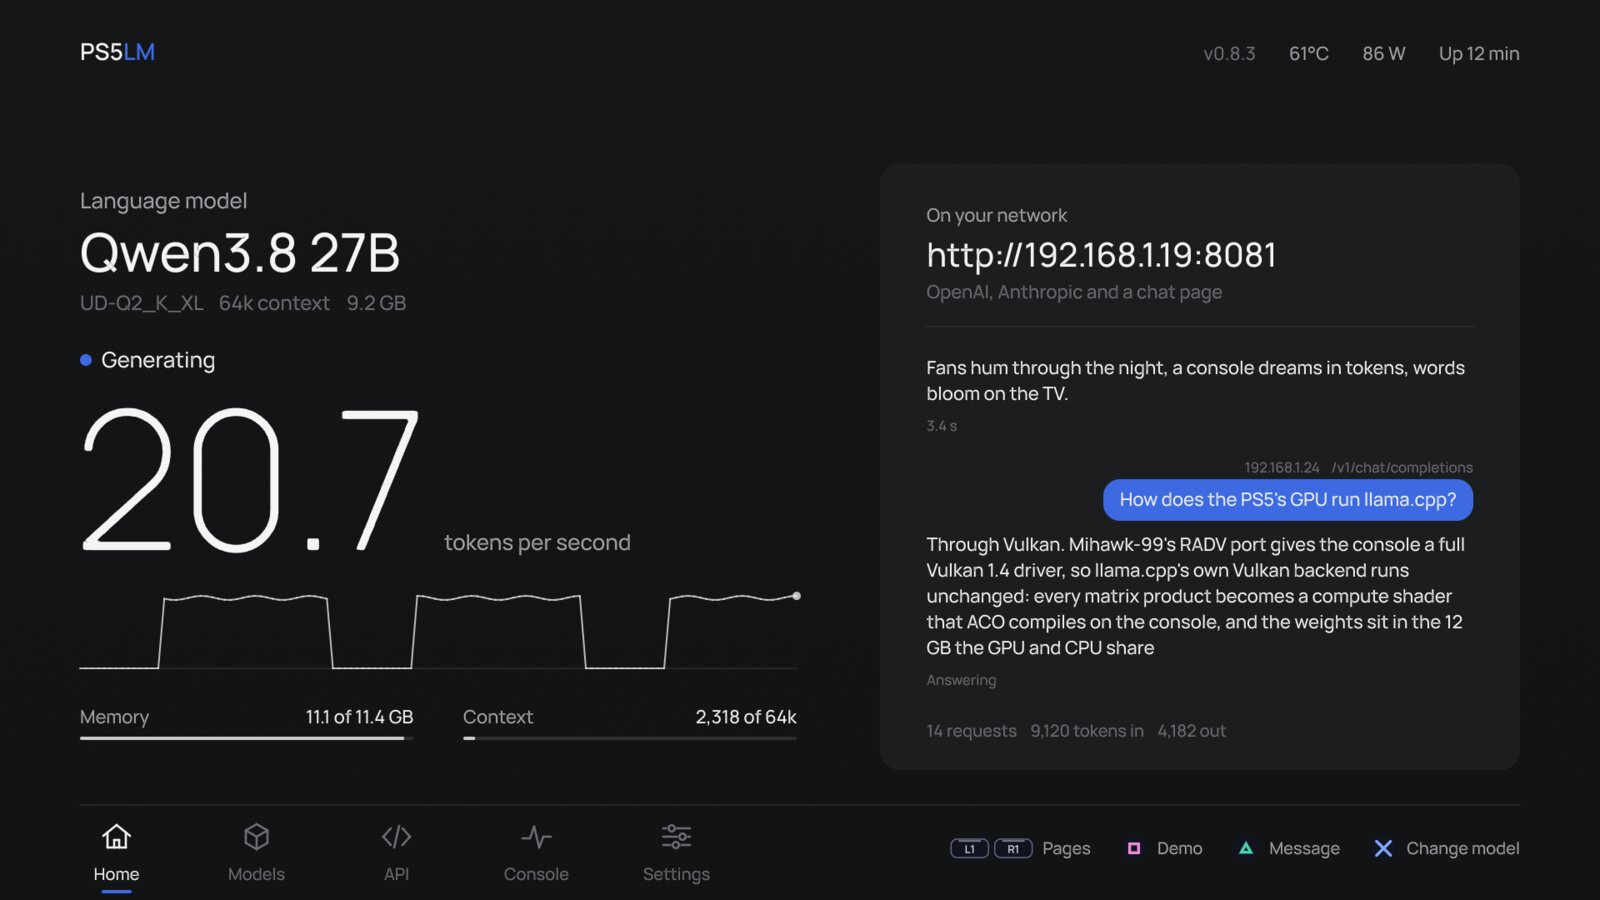
该项目提供一个用户界面,可在电视屏幕上显示实时遥测数据和流式请求。
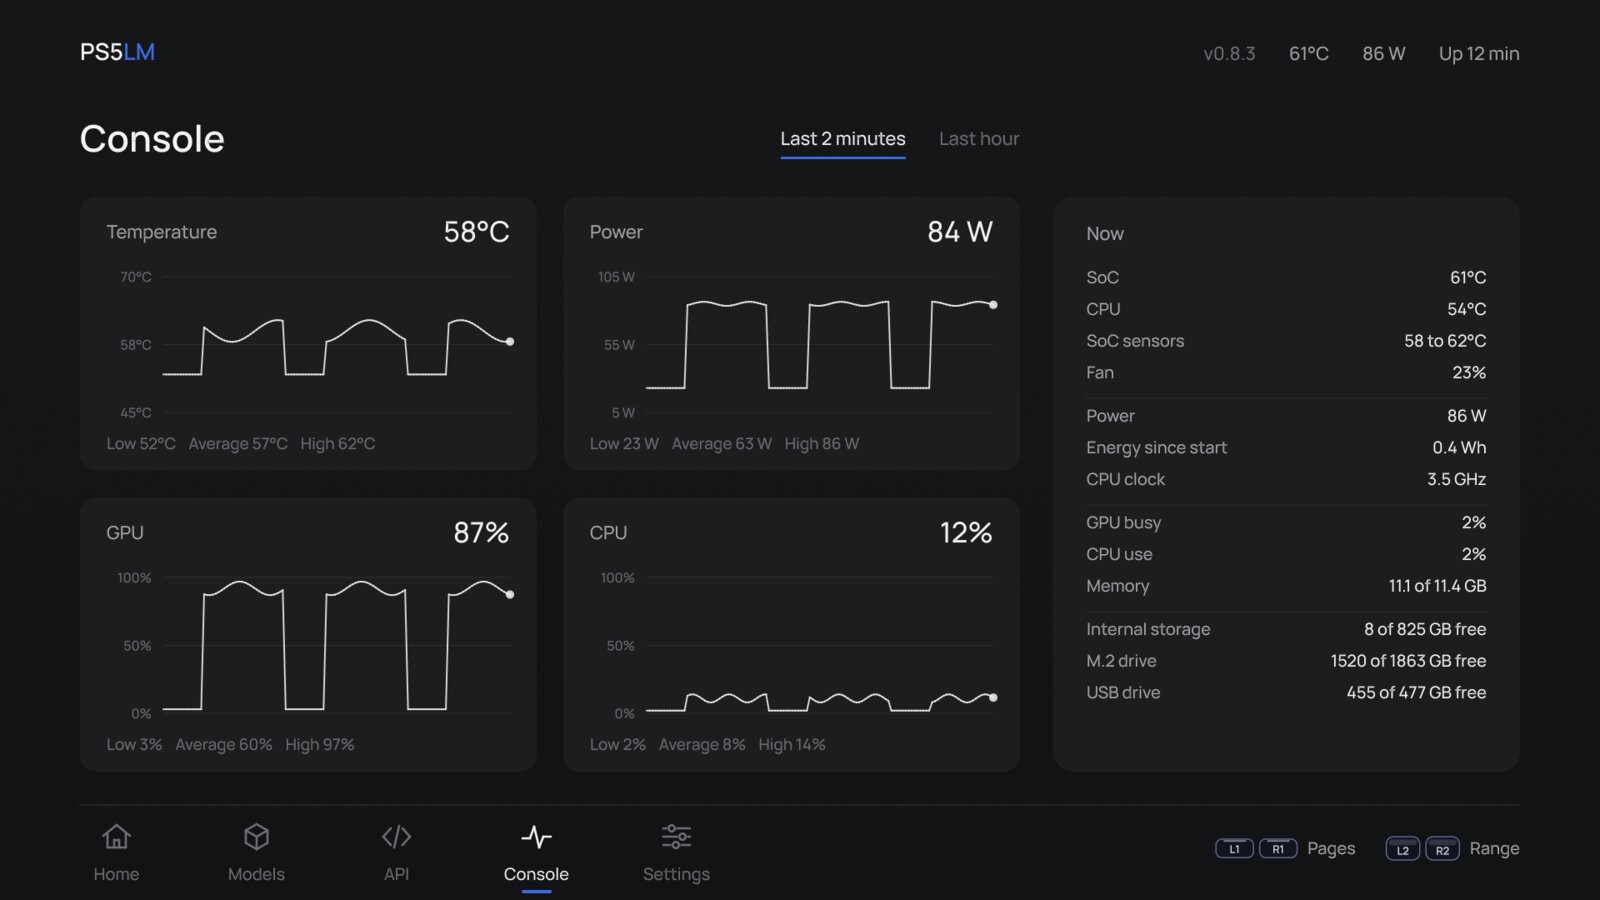
控制器的界面显示实时遥测数据,包括温度、功耗以及 GPU/CPU 负载,同时在电视屏幕上流式传输请求和回复。
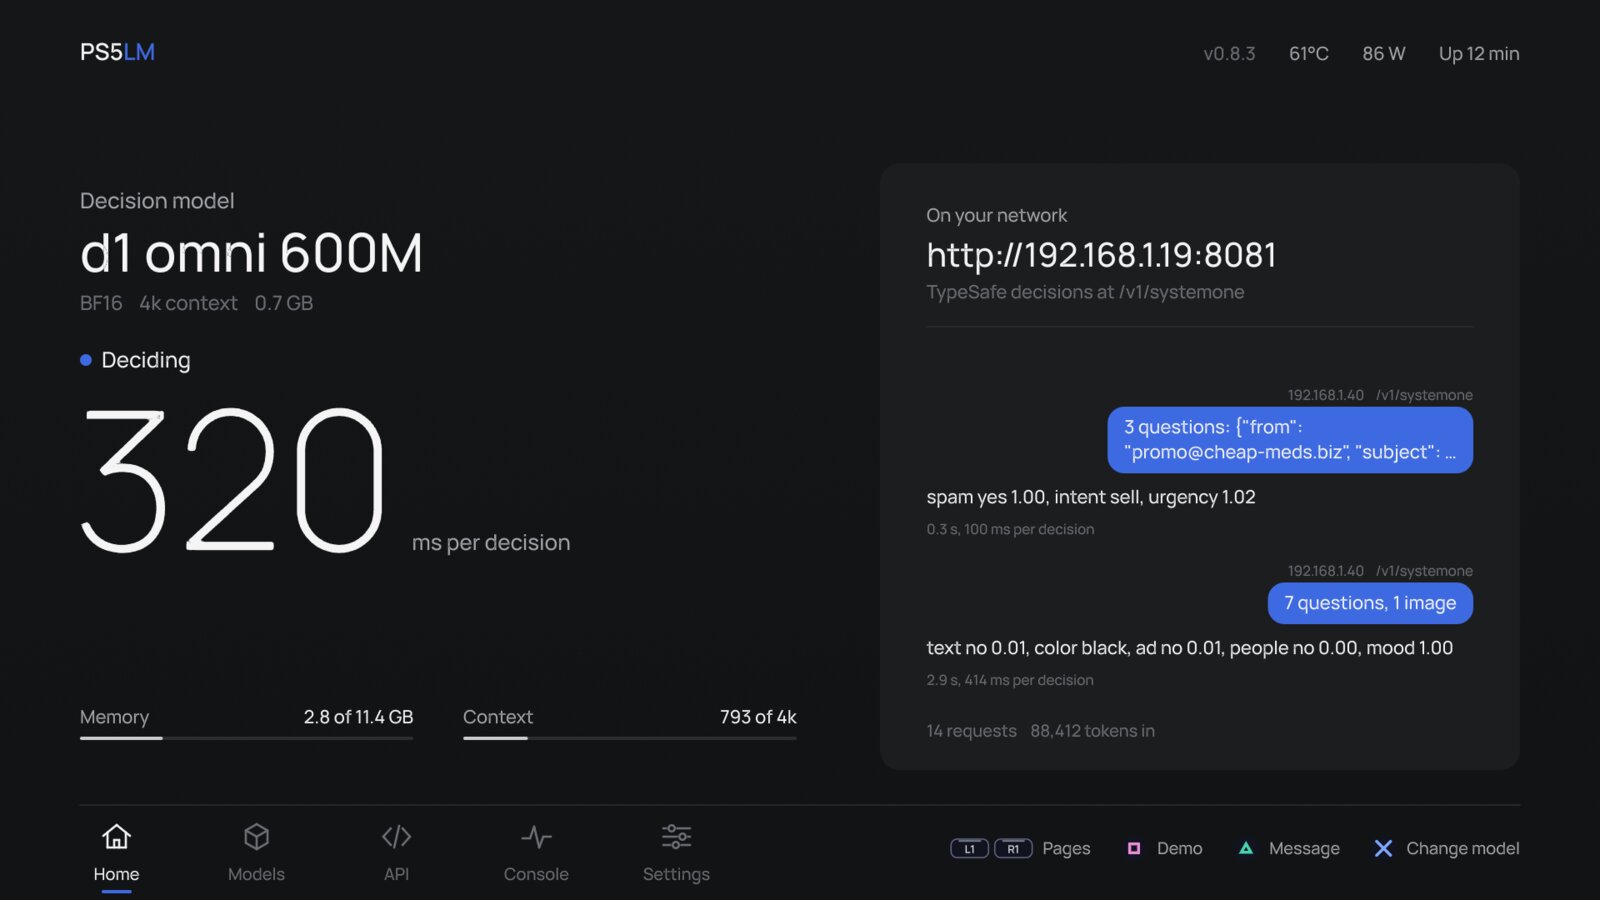
除了标准聊天外,PS5LM 还支持“决策模型”——这类模型旨在通过单次前向传播输出特定类型的决策、评分和“是/否”答案,而不是生成长字符串文本。
虽然该项目提供了一种原生运行 Qwen 3.5 和 Qwen 3.8 等模型的方法,但它有特定的硬件和软件要求。用户必须拥有已破解的 PS5,运行版本在 7.00 到 13.60 之间的固件,并配备几个特定的 Payload(如 etaHEN、ShadowMountPlus 和 elfldr)以启用 homebrew 支持和文件系统访问。性能因模型大小而异;例如,Qwen 3.5 9B 模型在 PS5 Slim 上可达到约每秒 55 个 token,而更大的 Qwen 3.8 27B 模型(在 2-bit 量化下)在 64k 上下文窗口下可达到约每秒 20 个 token。由于系统在本地运行,因此不需要云端连接或外部账户,为家庭 AI 主机提供了一个私密的替代方案。