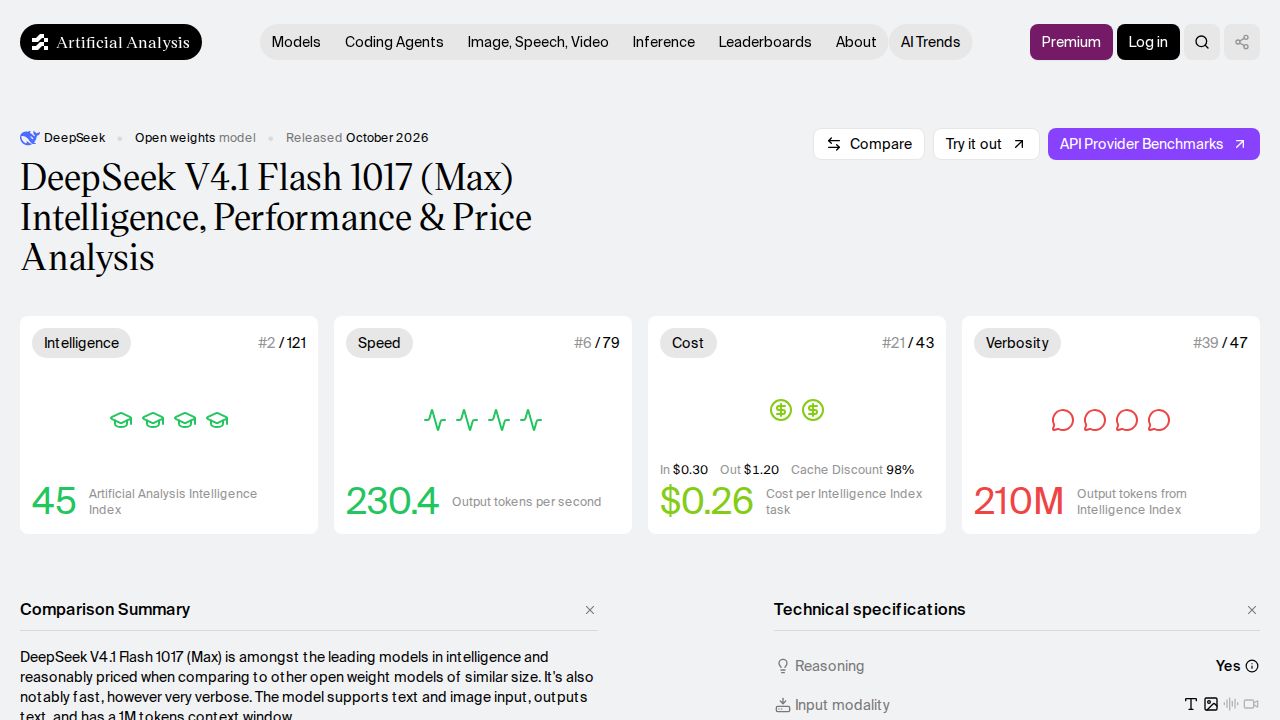
DeepSeek V4.1 Flash 1017 (Max) 模型引发了关于其参数数量、速度和推理能力平衡的广泛讨论。一个显著的技术细节是其架构,采用了 536+16B(被动+主动)的参数结构。这种配置使其能够在规模仅约为一半的情况下,实现与 Mimo v2.6 Pro 等更大模型相当的性能。虽然该模型因其高吞吐量(每秒 Token 数)而受到赞誉,但一些用户指出其输出可能过于冗长,这表明未来可能需要进行微调以提高 Token 效率。
与其他模型的对比揭示了成本和速度方面的不同权衡。例如,一些用户指出 GPT 6.1 Sol (medium) 在每项任务上的成本可能更低且速度更快,甚至优于 DeepSeek V4.1 Flash 1017 (max) 配置。这突显了“max”推理强度与标准配置之间的关键区别:虽然“max”强度旨在追求更高的智能,但它可能会显著增加所需的时间和 Token 数量,而带来的性能提升相对较小。一些测试人员报告称,“max”设置使用的 Token 数量几乎是“high”设置的两倍,但在特定使用案例中几乎没有明显的收益。
在消费级硬件上的实际部署仍然是一个关键的关注点。虽然一些用户已成功在配备 128GB RAM 的 Mac Studio 等高端消费级配置上运行 DeepSeek V4 Flash 模型,但关于这些模型能否在较低端硬件(例如配备 128GB RAM 的 2080ti)上运行并保持合理智能仍存在持续争论。此外,技术上的可能性,如从 SSD 流式传输权重——这可能会降低吞吐量但增加可访问性——正作为让这些大型模型在通用硬件配置上更具可用性的方法被探索。