对于构建由大语言模型(LLM)驱动的应用的开发者来说,主要的交互界面通常是一个简单的前端或付费订阅。然而,这种抽象可能会掩盖数据从用户提示词到提供商推理引擎传输的底层机制。自托管 LLM 代理充当透明的中间件层,位于本地客户端(如编程助手或自定义应用程序)与上游云提供商(如 OpenAI、Anthropic 或 Google)之间。通过拥有这一基础设施,开发者可以超越基础的使用统计,获得关于 Token 消耗和模型性能的深度、时间序列洞察。
自托管代理的主要技术优势之一是能够从单一端点管理复杂的多供应商环境。这允许在无需重新配置整个应用堆栈的情况下,在不同模型和提供商之间快速切换。此外,这些代理支持使用虚拟 API 密钥,可防止主要凭证在各种代理和开发框架中泄露。除了配置之外,自托管代理还提供关键的安全功能,例如自动脱敏密钥(如 AWS 密钥或 GitHub 令牌),以及在提示词注入尝试到达模型之前检测的“防中毒”堆栈。这确保了敏感信息从有效负载中被剥离,从而降低了数据外泄的风险。
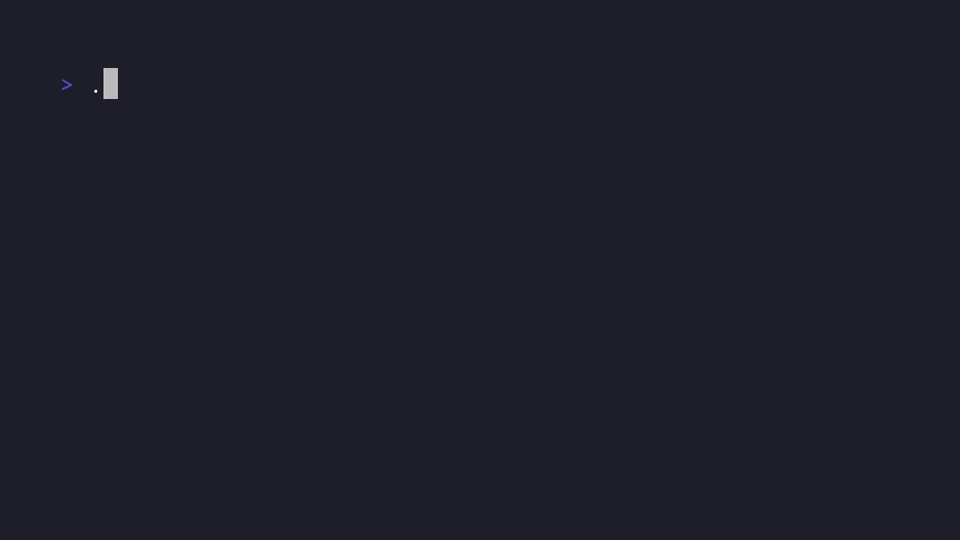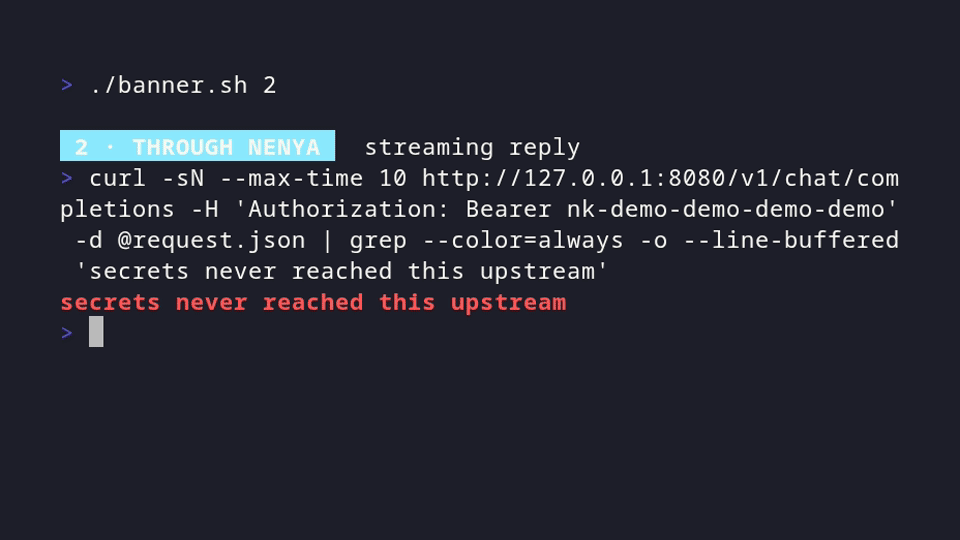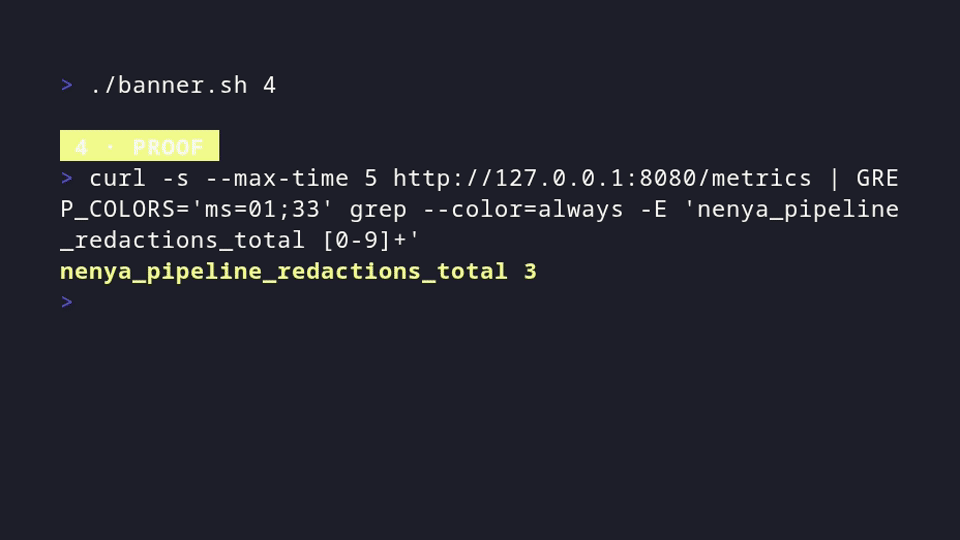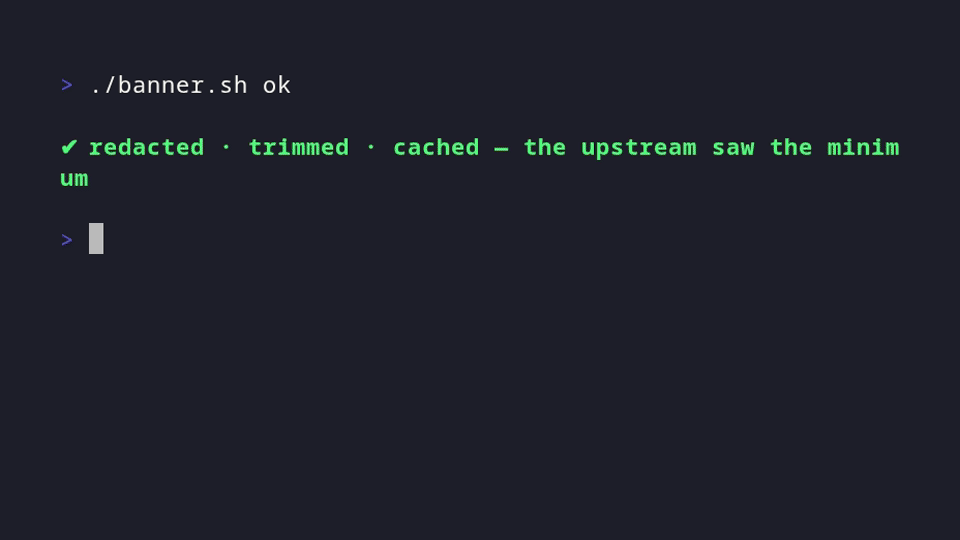
此视觉效果说明了文中提到的自动密钥脱敏和防中毒堆栈。
尽管有这些优点,运行代理的决策涉及复杂性和成本方面的权衡。虽然代理提供了对“缓存未命中”和特定模型行为的卓越可见性,但它需要维护额外的基础设施。对于采用固定费率订阅而非按 Token 付费的 API 模型的用户来说,价值主张发生了转变;有些人认为本地文件收集已足以用于监控,而另一些人则坚持认为,代理对于捕捉整个组织中代理行为的全貌是必不可少的。最终,自托管代理将 LLM 交互从“黑盒”转变为可观测的数据路径,允许工程师实时精准定位特定请求失败或成功的具体原因。