当 PyTorch 为机器学习模型构建计算图时,它必须决定哪些操作应存储在内存中,哪些操作应重新计算,以确保在特定的 RAM 预算内运行。这被建模为一个 0/1 背包问题:每个操作都是一个具有“内存成本”和“运行时间价值”的“物品”。目标是选择一组要保存的操作,在不超过可用内存容量的情况下最大化总时间节省。虽然 PyTorch 传统上使用称为 `dp_knapsack` 的动态规划(DP)方法来解决此问题,但标准实现需要分配一个形状为(项目数量,最大权重)的完整二维表格,这在处理大型模型时可能会导致内存耗尽。
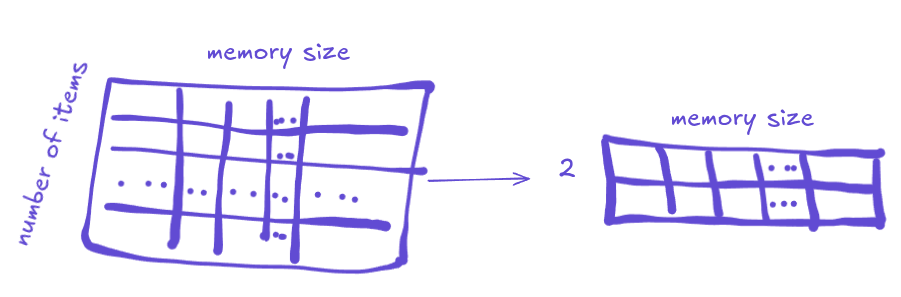
这张图片展示了第一段中提到的背包问题,其中操作被视为具有内存成本和运行时间价值的物品。
为了解决这一问题,Jędrzej Maczan 推出了 `dp_knapsack_sliding_hirschberg`,这是一个能显著降低规划阶段本身内存占用足迹的求解器。该实现利用了两种主要的优化手段。首先,它采用了“滑动窗口”技巧,通过仅在内存中保留当前行和前一行来降低 DP 表格的空间复杂度。其次,它结合了 Hirschberg 算法,这是一种分治方法,消除了昂贵的回溯步骤。Hirschberg 方法不是构建巨大的表格并回溯以寻找最优项目,而是递归地将问题分解为更小的子问题,直到确定最终的保存操作集为止。
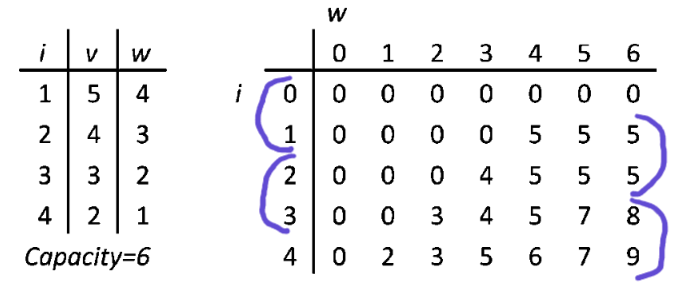
此图解释了第二段中提到的第一项优化:使用滑动窗口来最小化 DP 表格的内存占用。
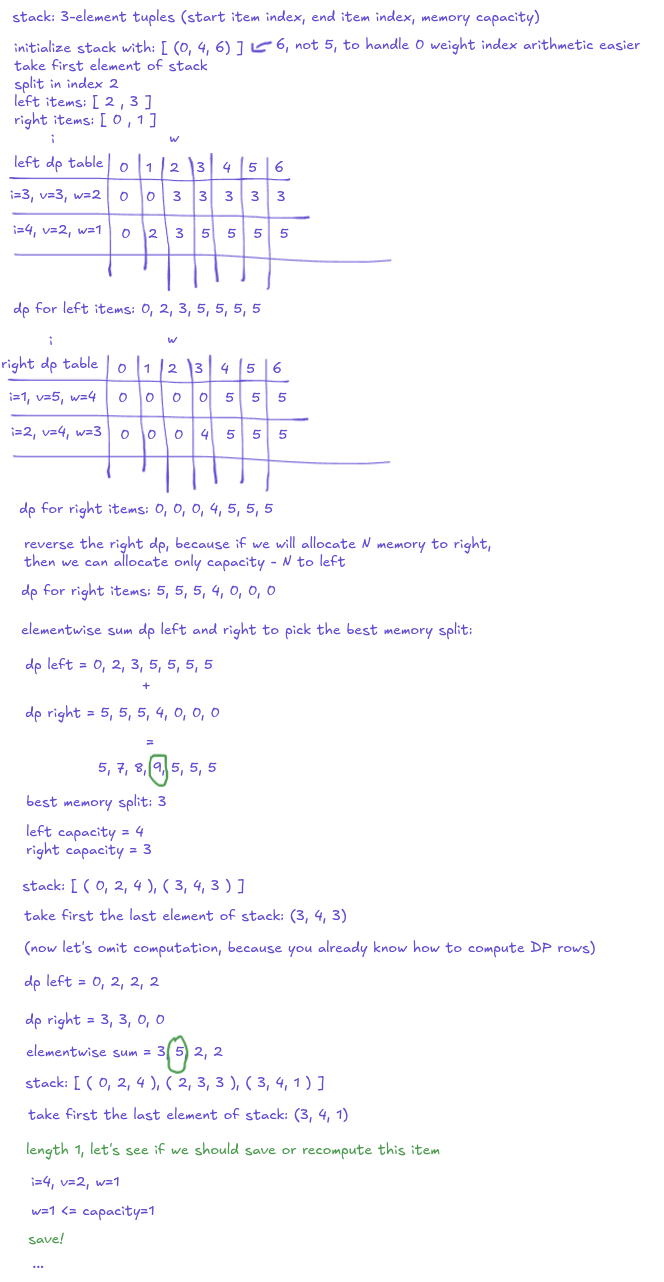
此视觉效果支持第二段中描述的第二项优化,展示了 Hirschberg 方法如何递归地分解问题。
在实际测试中,这一改进允许求解器在拥有 64GB RAM 的机器上处理包含 2,000 个项目的任务——而在原始的 `dp_knapsack` 求解器中,仅 100 个项目就会导致崩溃。虽然新求解器提供精确解并比基准方法快约 37%,但它并不是目前最快的可用方法。对于可以包含外部依赖的用户,通过 SciPy 使用的整数线性规划(ILP)求解器速度明显更快。然而,对于受限于标准 PyTorch 分发的用户来说,`dp_knapsack_sliding_hirschberg` 提供了一种在无需传统 DP 表格开销的情况下管理内存密集型模型的高效稳健方案。
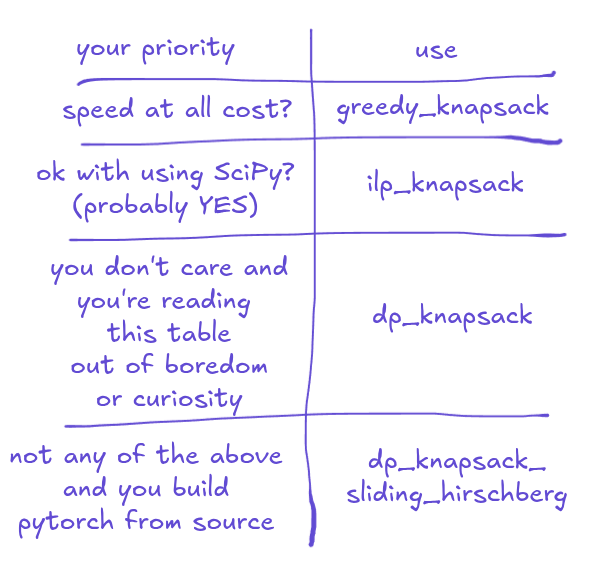
这张图片展示了最后一段讨论的实际测试结果,以及新求解器、基准方法和外部 ILP 求解器之间的对比。