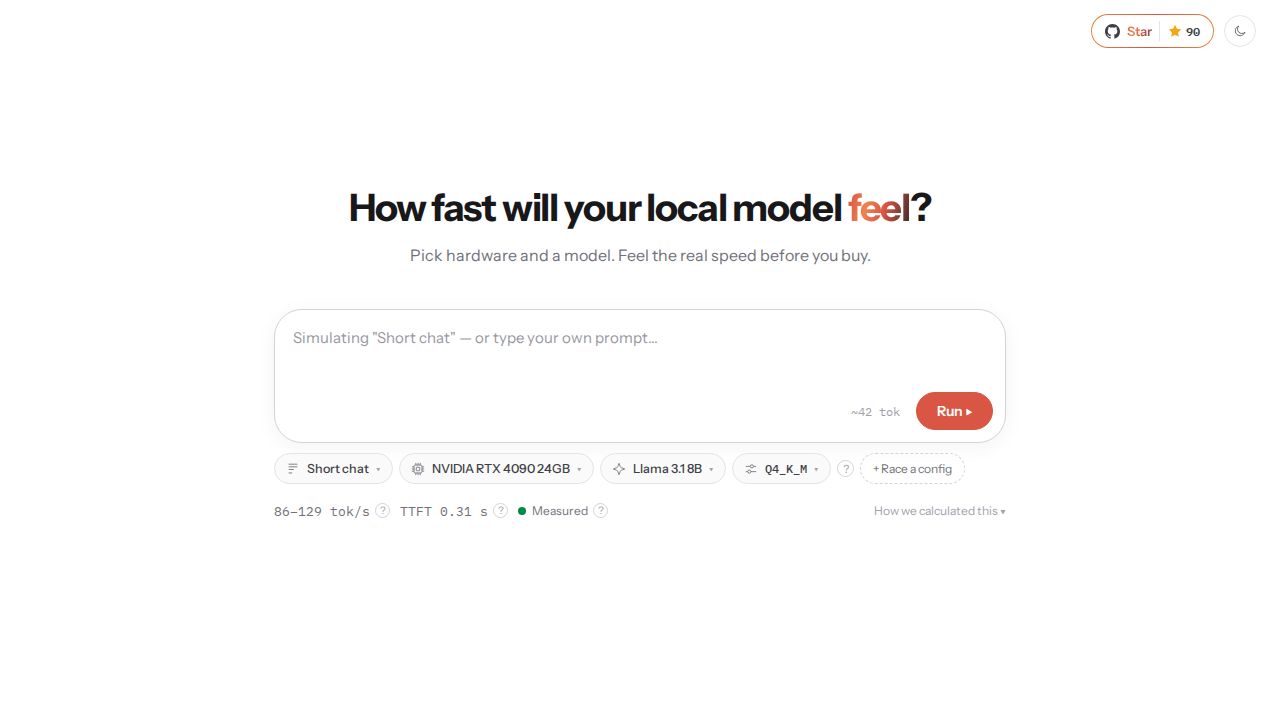
Llmspeed 是一个基于 Web 的工具,旨在帮助用户估算本地大型语言模型(LLM)在特定硬件上的运行速度。通过提供涵盖从 NVIDIA RTX 5090 等消费级 GPU 到 Mac Studio M5 Ultra 等高端工作站的硬件配置目录,以及包括 Qwen、Gemma 4 和 DeepSeek 在内的多种模型,该工具允许用户在无需自行下载和运行模型的情况下,直观地查看每秒 Token 数(tk/s)和首字生成时间(TTFT)等性能指标。
该工具的估算数据源自社区基准测试(如 r/LocalLLaMA 和 localscore.ai)以及基于硬件规格的预测。它为用户提供了一种评估模型大小、量化级别(例如 4 位或 8 位)与硬件内存限制之间权衡的方法。例如,它可以展示特定模型如何适配 GPU 的 VRAM,或者某种配置在物理上是否能够运行特定模型的参数。
然而,用户和技术观察者指出,这些估算值仅代表性能的一个特定快照,可能无法完全捕捉真实使用场景的复杂性。围绕该工具的讨论强调,性能可能会因推理引擎的实现、特定的软件优化(如投机采样)以及上下文窗口的大小而显著变化。例如,虽然模型在短提示词上表现良好,但随着上下文窗口的扩大,性能可能会下降。此外,一些用户指出,真实的智能体(agentic)工作负载——通常涉及大型提示词和复杂的 KV 缓存管理——产生的吞吐量可能低于简化基准测试中显示的峰值。该工具作为一个高层级的规划资源,但实际性能仍取决于最终用户使用的特定软件栈和硬件细微差别。