Apple Machine Learning Research 展示了使用 MLX 框架在 Mac Studio 硬件上运行前沿级大语言模型(LLMs)的能力。MLX 是一个开源数组框架,旨在利用 Apple silicon 的统一内存架构,允许开发者在本地进行推理和微调。该研究强调了通过利用 Mac Studio 集群运行 Muse Spark Open 的能力,这是一个拥有近一万亿参数的混合专家(MoE)模型。在测试中,一个由四台机器组成的集群在 8,192 个 token 的上下文尺寸下实现了每秒超过 36 个 token 的速度,超过了人类的平均阅读速度。
MLX 是一个开源数组框架,旨在利用 Apple silicon 的统一内存架构,允许开发者在本地进行推理和微调。
这些模型的性能深受硬件内存架构和专用加速器的影响。例如,M5 Ultra 芯片配备了支持专用矩阵乘法的 GPU 神经网络加速器,Apple 报告称,与上一代 M3 Ultra 相比,该加速器可将“首字生成时间”(TTFT)提高多达 4.6 倍。虽然像 Qwen 3.8 (27B) 和 Mistral Medium 3.5 (128B) 这样较小的模型可以放入拥有 512GB 统一内存的单台 Mac Studio 中,但 Muse Spark Open 模型在原生精度下需要超过 1.6TB 的 RAM。即使量化到 4 位(NVFP4)精度,该模型的内存占用仍达到约 493GB,因此需要跨多台机器进行并行处理,以容纳模型以及推理过程中所需的中间计算。
为了处理这些庞大的模型,MLX 支持两种主要的并行方案:流水线并行和张量并行。流水线并行将模型的层分布到不同的机器上,其中一台 Mac Studio 执行前一半的层并将输出传递给下一台。张量并行则分布模型的宽度,每台机器持有每一层的一部分。为了使张量并行可行,MLX 利用了基于 Thunderbolt 5 的低延迟 RDMA(远程直接内存访问)驱动程序。这实现了集群内聚合输出所需的高速机器间通信。虽然流水线并行提供了简洁性,但只要通信开销保持在较低水平,随着更多机器加入集群,张量并行可以为稠密架构提供显著的加速。
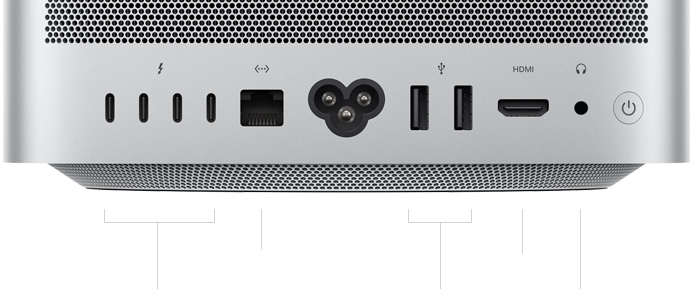
为了使张量并行可行,MLX 利用了基于 Thunderbolt 5 的低延迟 RDMA(远程直接内存访问)驱动程序。