Anthropic 最近推出了 Scion,这是一款旨在处理大规模单体仓库(monorepos)的版本控制系统。在发布公告中,Anthropic 表示该系统是基于从 Google 的 Piper 和 Meta 的 Sapling 等现有系统中获得的“艰苦教训”构建的。然而,Scion 的技术实现——特别是其使用“派生数据”来优化“blame”等操作的方法——被开源社区指出与 Meta Sapling 项目的一个组件 Mononoke 的设计几乎完全相同。
Scion 的核心机制涉及从变更集(changesets)中构建额外的数据结构,以高效回答复杂查询。由于变更集仅记录了发生变化的内容,它无法快速识别谁最后编辑了特定的一行。Scion 通过创建“派生数据”来解决这个问题——这些是用于文件 blame、路径历史和提交图的索引,它们从父级变更集中递归计算得出。这反映了早在 2017-2018 年就开发的 Mononoke 的架构。批评者认为,虽然 Anthropic 承认了更广泛的 Sapling 项目,但未能专门致谢提供派生数据模型实际技术蓝图的 Mononoke,这近乎剽窃,尤其是由于术语和数据模型几乎完全一致。
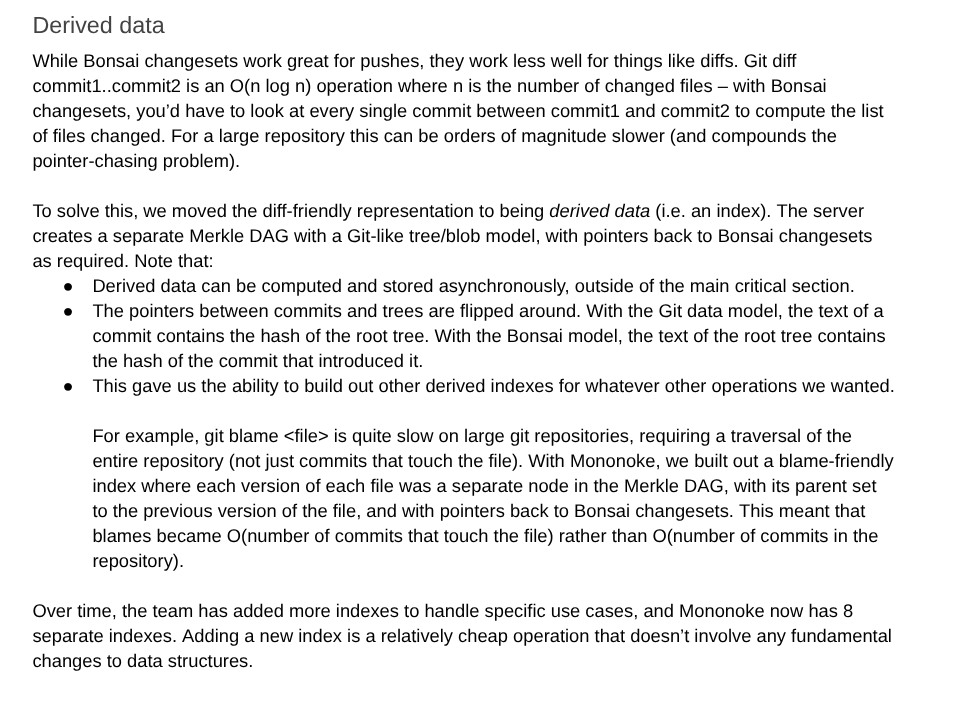
这张图片解释了 Mononoke 派生数据的技术架构,它是 Scion 设计的主要对比点。
这一争议突显了在大语言模型(LLM)时代日益增长的紧张关系。由于 Mononoke 是开源的,并且包含在 Claude 和 GPT 等模型的训练集中,这些模型可以轻松复制复杂且非显而易见的工程设计,而无需向原始人类创造者提供归属。一些观察人士指出,随着 LLM 使“氛围编码”(vibe-code)或从头生成整个系统变得更便宜,知识产权“洗白”的风险正在增加。这创造了一个潜在的长期风险:如果这些贡献可以被 AI 辅助开发团队瞬间提炼并重新品牌化,而无需承认创新的原始来源,那么分享和维护开源项目的动力将会减弱。
虽然有人认为,当现成的解决方案无法完美适应公司的规模时,构建自定义系统是合理的工程选择,但其他人指出,两者的相似度如此之高,以至于表明这是直接衍生而非独立发现。辩论仍集中在:使用 LLM 基于现有开源仓库生成代码是否需要新的归属标准,或者当前的“艰苦教训”框架对于现代软件开发是否已经足够。
最终,这种情况强调了软件生产的一种转变:由于 AI 的介入,构建复杂系统的成本显著降低,但底层逻辑的来源仍然模糊不清。对于开源社区来说,挑战在于确保在 AI 可以毫不费力地复制人类劳动成果的景观中,原始创新的“人类”劳动继续得到认可。
Scion 和 Mononoke 之间的技术区别仍是一个争议点。虽然 Scion 的实现是私有的,但使用 Merkle DAG 来创建对 blame 友好的索引的底层逻辑是直接沿用自 Mononoke 的设计。这突显了现代开发中的一个特定权衡:AI 辅助创作的速度与保护正在构建的软件的知识传承之间的矛盾。
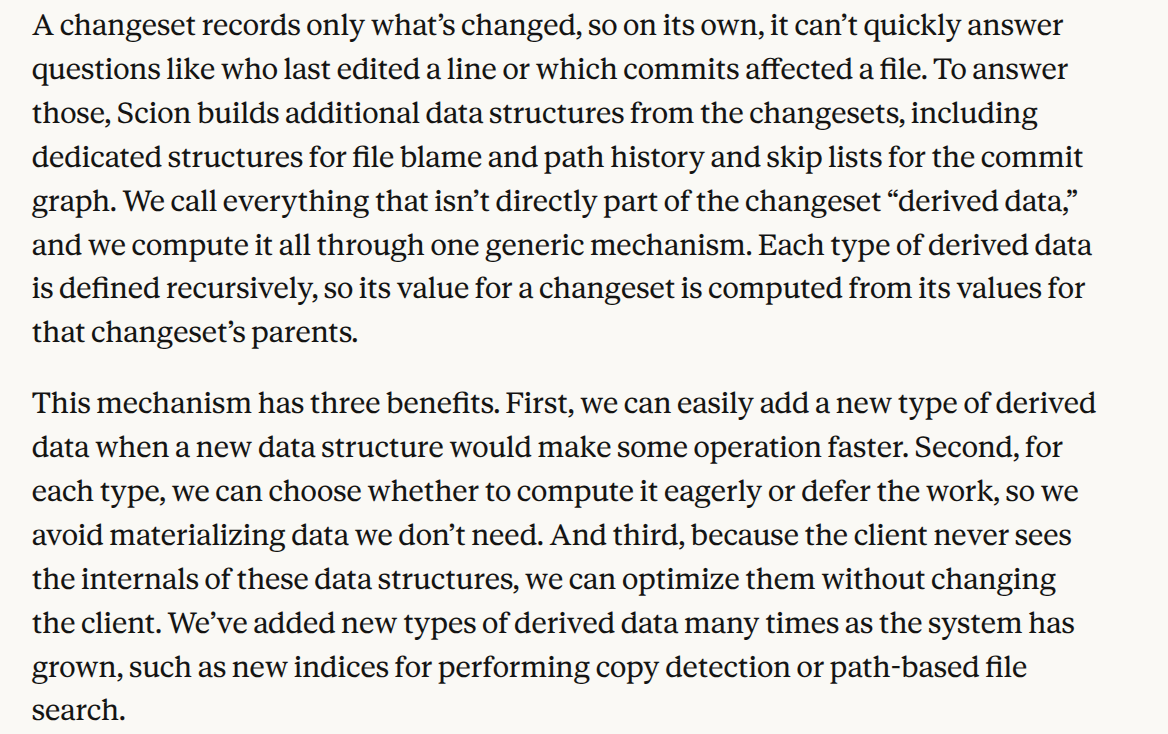
此视觉效果描绘了 Scion 派生数据的具体技术实现,这是设计相似性争议的核心。
随着 Anthropic 为未来的里程碑(包括潜在的 IPO)做准备,对其工程实践的审查成为了整个行业的案例研究。它引发了关于公司将如何处理使用 AI 从开源仓库中“剥离”高价值架构设计,同时将产出的产品作为新颖创新呈现的伦理问题的思考。