Liquid AI 发布了 LFM2.5-24B-A2B,这是其 LFM2.5 系列中最大的模型。该模型专门为“端侧”智能体设计——即在用户硬件上本地运行而非在云端运行的 AI 系统——以确保隐私性和低延迟。它采用了混合专家(MoE)架构,这使得模型能够拥有庞大的总参数量(240 亿),但在生成每个 token 时仅激活一小部分(20 亿)。这一设计选择使模型在消费级硬件上运行速度显著快于同类 MoE 模型,例如在 Apple M5 Max 上可达到每秒 184 个 token。

该图像作为 LFM2.5-24B-A2B 模型的主要视觉展示,说明了其作为高速端侧智能体的角色。
LFM2.5-24B-A2B 模型是一个“纯推理”模型,这意味着它经过训练,在给出最终答案之前会生成显式的思维链。这种方法旨在利用 MoE 架构的高解码速度的同时提高答案质量。为了支持复杂的智能体任务,该模型经历了包含监督微调(SFT)、教师专业化和智能体强化学习在内的五个阶段的后期训练流程。这些阶段旨在帮助模型掌握工具调用、多轮轨迹以及在 OpenClaw 和 Hermes Agent 等流行智能体框架中的交互模式。
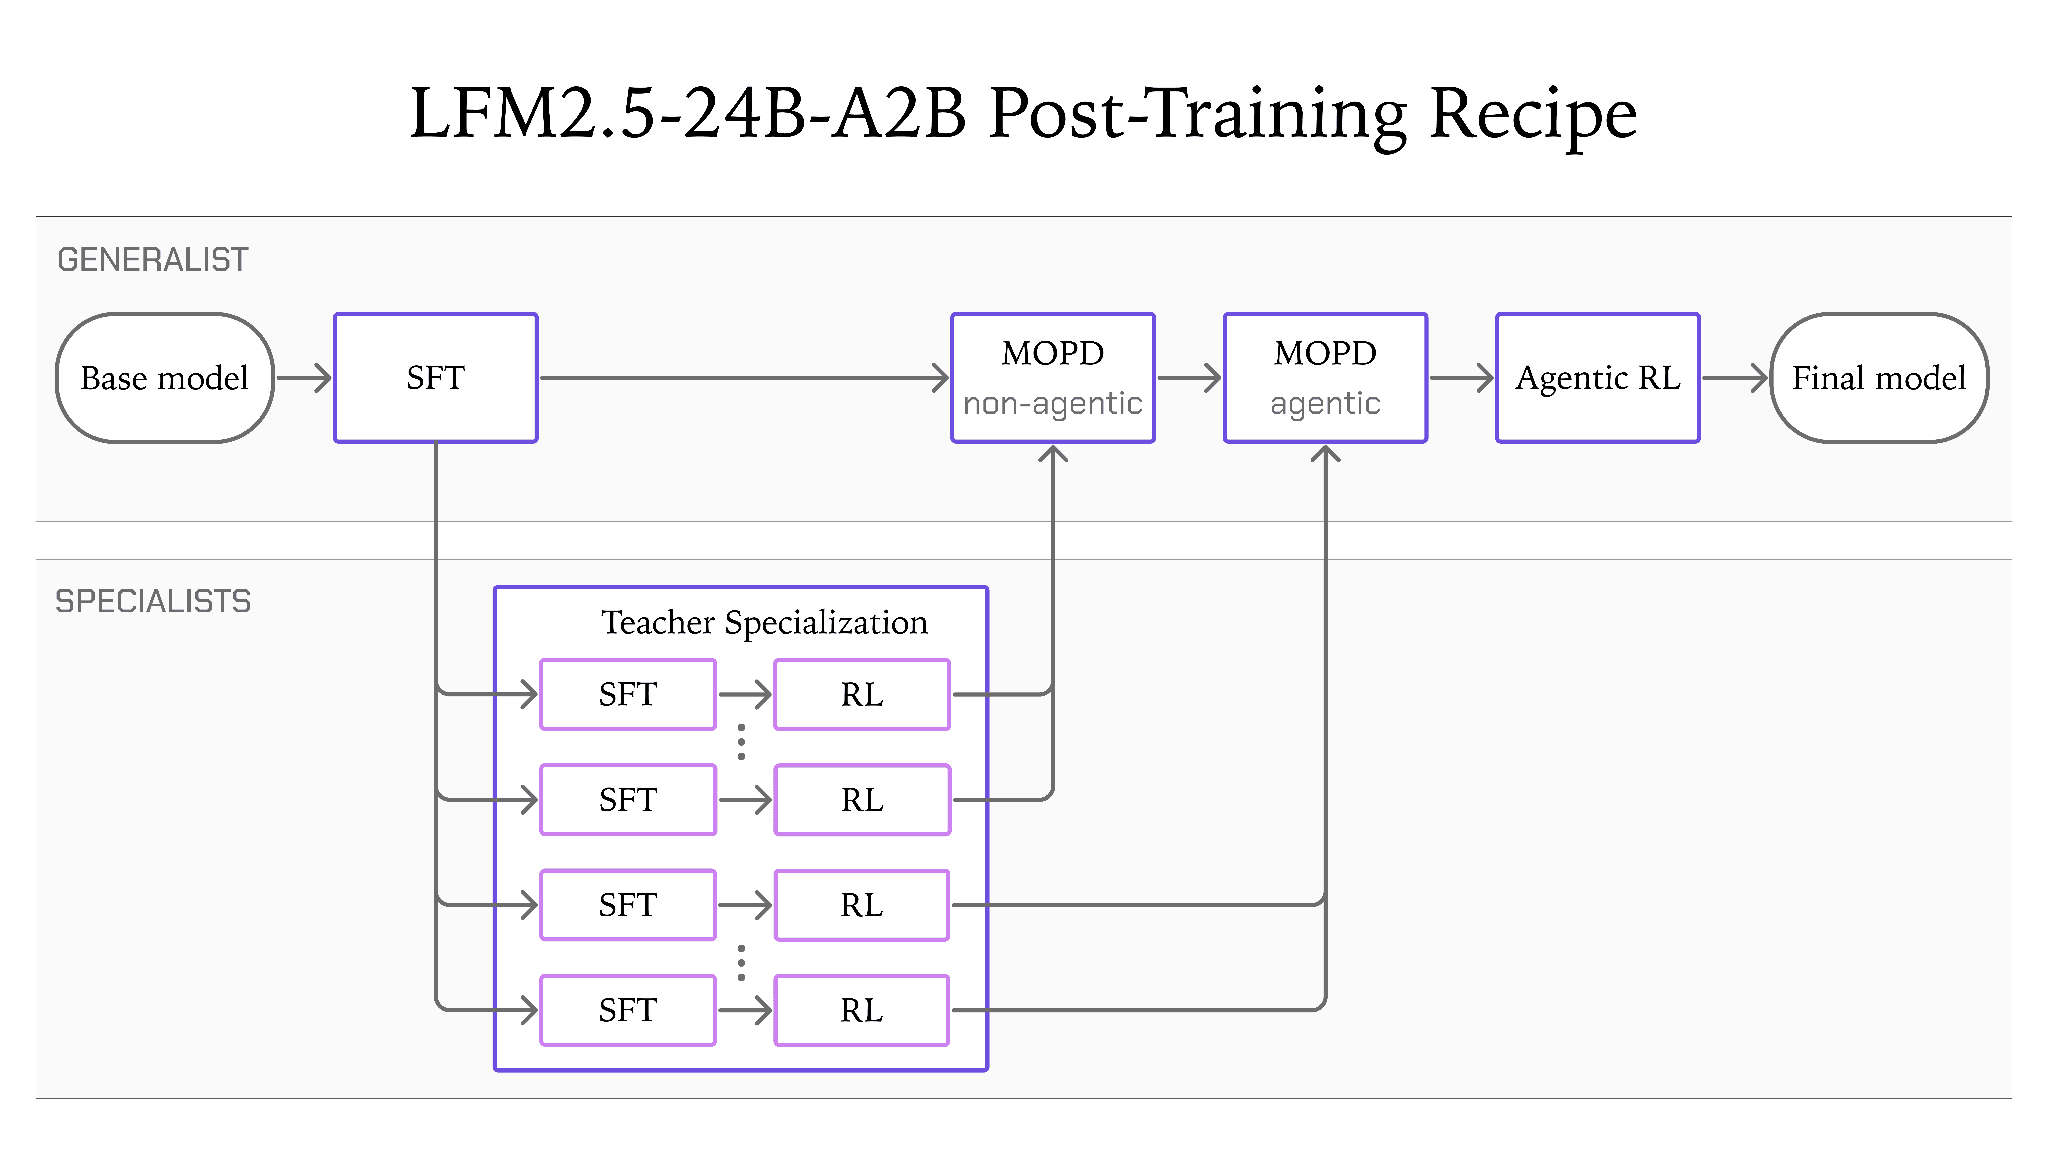
此图表解释了文中提到的包括 SFT 和智能体强化学习在内的具体训练阶段。
虽然该模型在工具调用和指令遵循基准测试中表现强劲——在 AutomationBench 等类别中甚至超越了一些更大的模型——但在知识密集型任务中面临权衡。Liquid AI 指出,对于需要深度事实知识的工作负载,应将该模型与检索增强生成(RAG)或网络搜索相结合。此外,虽然该模型在速度和特定智能体工作流方面表现出色,但用户注意到与更大的模型相比,它在处理复杂的编程任务时可能会遇到困难,这突显了其优化的推理速度与其在特定领域深度推理能力之间的平衡。