市场数据提出了独特的建模挑战,因为它融合了连续和离散元素。虽然价格等单个属性可以连续变化,但订单簿通过离散事件演变——订单的下达、撤销和成交——这些事件以不规则间隔发生。这种双重特性意味着传统生成模型(假设纯连续或纯离散数据)难以捕捉金融时间序列的微观结构。在定量金融中,从业者通常基于历史市场数据流预测未来价格,但生成逼真的合成数据需要同时保持价格和时序等变量的连续动态以及事件类型的离散性。杰恩街的一个由 Kavish 领导的实习项目探索了自回归扩散是否能弥合这一差距,将在图像、视频、机器人和音频生成中成功的技术应用于订单簿事件的特定特征。
团队构建了编码器-扩散器架构:因果掩码 Transformer 编码器为序列中的每个位置创建潜在嵌入,这馈入一个小型类别头,用于预测下一个事件是交易还是最佳买卖报价(BBO)更新,而扩散头生成诸如价格、经过时间和规模等连续目标。最初的实验使用了具有 1,000 步余弦调度和 DDIM 采样的去噪扩散概率模型(DDPM),但这种配置证明不稳定——生成轨迹快速发散,所有连续目标中有 88‑95% 的值超过均值的八个标准差。正如一条 Hacker News 评论所指出的:“DDPM 失效是因为订单簿事件间隔是离散的点质量,而不是平滑的高斯分布。”转向流匹配——在噪声和数据之间进行线性插值并训练网络预测该线上的速度——即开箱即用地提供了稳定的性能。为了处理市场数据固有的不连续性(例如,时间聚集在零和整数秒周围,价格集中在买卖中点),Kavish 将类别头细化为代表常见事件子类的 20 类,并开发了一种“原子平滑”程序,该程序平滑尖峰分布然后重新塑造尖峰以保持概率质量而不引入人工不连续性。
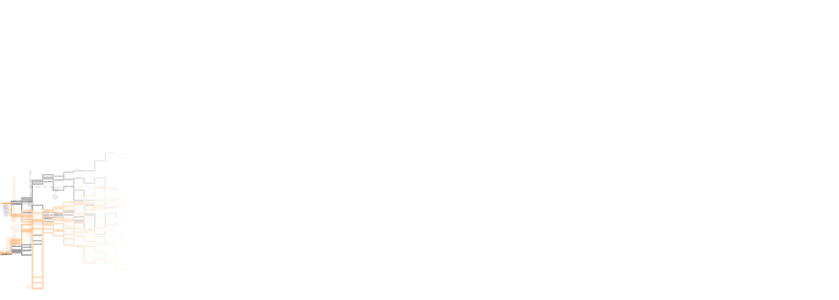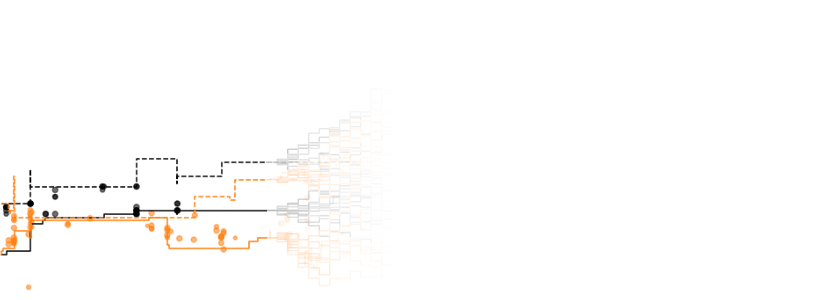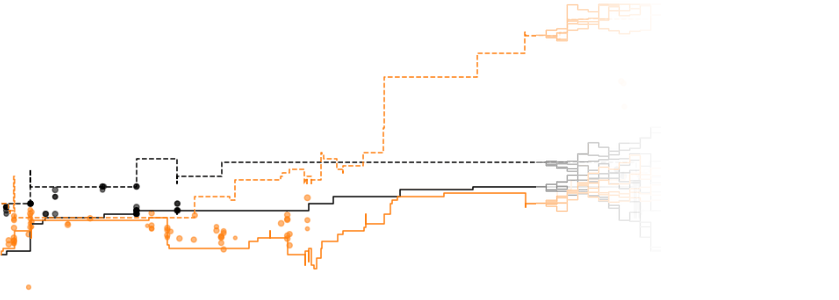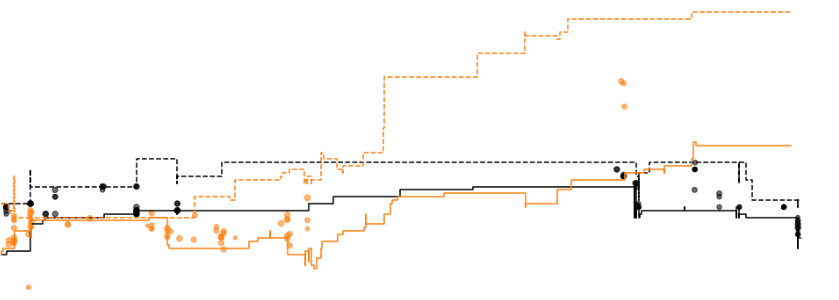
此图展示了文章中描述的编码器-扩散器架构,其中 Transformer 编码器预测事件类型,而扩散头生成价格和时间等连续变量。
评估表明,带有原子压缩的流匹配模型产生的边缘分布比真实数据更接近,并且在由训练用来区分模型输出和真实事件的分类器鉴别时生成了更逼真的样本。然而,自回归展开显示合成轨迹在更长时间范围内会退化——合成 CME 美国价格的散布相对于真实数据变宽,表明误差在累积。因此,该模型尚不够准确,无法作为市场数据的实际生成器。此次实习澄清了两个未来工作的开放问题:应显式建模多少离散性,留多少给扩散过程;以及如何最好地表示和平滑特征分布,以便扩散能够有效学习订单簿数据的复杂、尖峰统计特性。正如另一条评论所观察到的:“真正的故事在于此出色的阐释,展示了将扩散模型应用于既不是离散也不是连续的时间序列数据。”.